Microsoft Fabric
Pandas vs Polars vs DuckDB vs PySpark en Microsoft Fabric: velocidad, memoria y escala
Compara pandas, Polars, DuckDB, PySpark y Spark SQL en Microsoft Fabric por velocidad, uso de memoria, tamaño de datos, soporte de Delta y escala, con resultados medidos en un benchmark real en Fabric y una guía práctica para elegir el motor adecuado.
En este artículo
Microsoft Fabric ofrece dos tipos de notebook y al menos cinco formas de procesar una tabla dentro de ellos: pandas, Polars, DuckDB y PyArrow en un notebook de Python puro, y PySpark, Spark SQL o la API de pandas en Spark en un notebook de Spark. No son cinco sintaxis para lo mismo. Son arquitecturas de ejecución distintas, y la adecuada depende de cuántos datos tienes, cuánta memoria necesitan, de qué funcionalidades de Delta Lake dependes y de lo grandes que serán los datos el año que viene.
Esta guía responde a una pregunta: ¿cuándo conviene usar pandas, Polars, DuckDB o PySpark en Microsoft Fabric? Compara los motores a nivel de arquitectura (modelo de ejecución, velocidad según el tamaño de los datos, comportamiento de la memoria, soporte de Delta Lake, soporte técnico y coste) y termina con un marco de decisión. Por el camino, recoge lo que medimos en nuestro propio benchmark en Fabric con datos reales de taxis de Nueva York, incluido un hallazgo sobre la orquestación de notebooks que cambió la forma en que ejecutamos notebooks de Python en pipelines, y te da un harness para ejecutarlo en tu propia capacidad. No compara sintaxis; para las diferencias de API entre pandas y PySpark, consulta la serie sobre DataFrames de Python.
La versión corta
- Datos pequeños que seguirán siendo pequeños (Microsoft pone el límite en torno a 1 GB comprimido): un notebook de Python con Polars o DuckDB suele ser la opción más rápida y sencilla. pandas está bien para DataFrames realmente pequeños y a menudo es el último paso adecuado.
- 1 GB comprimido o más, o datos que llegarán a ese tamaño: Microsoft recomienda el kernel de Spark, empezando por una sesión de un solo nodo de 8 vCores del starter pool si los datos aún son modestos. PySpark y Spark SQL se ejecutan sobre el mismo motor; elige según el equipo y la legibilidad, no según la escala.
- Pipelines de producción con uso intensivo de Delta (MERGE, UPDATE, DELETE, deletion vectors, OPTIMIZE, VACUUM, Change Data Feed): Fabric Spark. Los motores de Python leen bien Delta, pero solo escriben una parte.
- Los joins, las escrituras y el crecimiento pesan más que la velocidad de lectura. Una lectura local rápida no convierte a un motor en la opción adecuada para el ETL de producción.
- Haz un benchmark de tu propia carga de trabajo antes de comprometerte. Las franjas de benchmark de Microsoft que verás más abajo son observaciones, no umbrales.
Qué midió nuestro benchmark en Fabric
Ejecutamos los motores en un pipeline de Microsoft Fabric con datos Parquet reales de los taxis amarillos de Nueva York. Hay tres hallazgos que conviene conocer antes de la teoría; los resultados completos y el método vienen más adelante.
- Con un conjunto de datos pequeño, pandas y Polars terminaron con 0,21 segundos de diferencia. En el conjunto S (tres archivos Parquet, 11.198.026 filas, agregadas a 1.240 filas), una ejecución tardó 2,3387 s de procesamiento en pandas y 2,5467 s en Polars, y ambas produjeron checksums SHA-256 idénticos. Es una única ejecución sobre una entrada pequeña, así que respalda «los dos van bien a este tamaño», no «pandas es más rápido».
- La duración de una actividad de notebook no es el tiempo de procesamiento del motor. Cada actividad independiente de benchmark de Python en el pipeline tardó entre 34 y 38 segundos, mientras que una ejecución medida de pandas o Polars sobre el conjunto S necesitó entre 2,3 y 2,5 segundos de procesamiento. La duración de actividad que muestra Fabric también incluye la sesión del notebook y su ciclo de vida, así que, con datos pequeños, cómo orquestas los notebooks puede importar más que qué motor eliges.
- Un notebook padre superó a tres actividades separadas en tiempo de actividad. Un notebook runner de Python que llamaba al notebook de benchmark una vez por motor con
notebookutils.notebook.runMultiple()terminó en 51 segundos, frente a 104 segundos sumados de tres actividades de notebook separadas. No se usaron session tags, y no es una comparación controlada del tiempo total real (wall-clock). La sección de orquestación explica qué demuestra y qué no.
Dos runtimes, no uno
Los notebooks de Fabric admiten un kernel de Python, un kernel de Spark y un kernel de T-SQL. Aquí importan los dos primeros, y son entornos separados, con versiones y ciclos de vida propios. Confundirlos es la fuente más habitual de consejos equivocados.
| Notebook de Python de Fabric | Notebook de Spark de Fabric (Runtime 2.0) | |
|---|---|---|
| Ejecución | Un solo nodo, sin ejecución distribuida | Driver y executors; un solo nodo o varios nodos |
| Cómputo predeterminado | 2 vCores / 16 GB (1 CU); configurable hasta 64 vCores con %%configure |
Starter pool: nodos de 8 vCores con escalado automático |
| Versión de Python | El kernel que elijas: 3.10, 3.11 o 3.12; 3.12 es el predeterminado | 3.13, fijada por el runtime |
| Versiones de los motores | Bibliotecas del runtime de notebooks de Python | Apache Spark 4.1, Java 21, Delta Lake 4.2 |
| Motores | pandas, Polars, DuckDB, PyArrow; delta-rs (deltalake) para Delta |
PySpark, Spark SQL, Scala, SparkR, API de pandas en Spark |
| Delta Lake | Lectura y escritura con delta-rs y DuckDB; «es posible que algunas funcionalidades de Delta Lake no sean totalmente compatibles» | Soporte completo de funcionalidades |
| Native Execution Engine | No | Sí, cuando está habilitado |
Runtime 2.0 es el runtime GA y el predeterminado para nuevas áreas de trabajo y elementos de entorno. Microsoft indica explícitamente que la versión de Python dentro de un runtime de Spark es independiente del kernel de notebook de Python que selecciones: elegir uno no cambia el otro. Python 3.10 llegó al fin de soporte anunciado en octubre de 2026, así que los notebooks de Python nuevos deberían usar 3.11 o 3.12. La comparación de Runtime 2.0, 1.3 y 1.2 cubre en detalle el runtime de Spark.
En un notebook de Python, Microsoft indica que DuckDB, Polars y scikit-learn vienen preinstalados, incluye delta-rs y DuckDB «para admitir tanto la lectura como la escritura de datos de Delta Lake» y da un consejo que enmarca todo este artículo: si te encuentras con un OOM al cargar un gran volumen de datos, prueba a usar DuckDB, Polars o un DataFrame de PyArrow en lugar de pandas. Las versiones de las bibliotecas del runtime de Python cambian; el benchmark que verás más abajo las registra en lugar de suponerlas.
Primero, los modelos de ejecución
Antes de comparar velocidades, hay que tener claro dónde se ejecuta el trabajo.
- Un solo nodopandas, Polars, DuckDB, PyArrow
- Proceso del notebookUn proceso de Python en una VM
- Motor en el procesoLos hilos comparten la memoria de una máquina
- pandas
- Polars
- DuckDB
- Límite de la máquinaHasta 64 vCores en un notebook de Python de Fabric
- DistribuidoPySpark, Spark SQL, API de pandas en Spark
- DriverPlanifica la consulta y reparte las tareas
- ExecutorsProcesan particiones en paralelo
- Partición 1
- Partición 2
- Partición N
- ShuffleMueve filas entre executors para joins y agregaciones
- Añadir nodosEscalar horizontalmente sin reescribir código
- pandas se ejecuta de forma inmediata (eager) en un proceso de Python. Cada paso materializa un DataFrame completo en memoria antes de que empiece el siguiente, y la mayoría de las operaciones usan un solo núcleo.
- Polars se ejecuta en una máquina pero usa todos sus núcleos. Guarda los datos en un formato columnar de estilo Arrow, y su API lazy (
scan_parquet…collect()) permite que el optimizador lleve los filtros y la selección de columnas hasta la lectura antes de leer nada. - DuckDB es una base de datos analítica embebida: un motor SQL vectorizado dentro de tu proceso de Python, sin servidor. Consulta archivos Parquet directamente (
read_parquet) sin convertirlos antes en un DataFrame. - PyArrow es sobre todo el formato de memoria columnar y la capa de E/S que comparten los demás (lectura y escritura de Parquet, datasets, traspasos sin copia). Tiene funciones de cómputo, pero es más la fontanería que el motor alrededor del que diseñas un pipeline.
- PySpark y Spark SQL describen una consulta que un driver planifica y que los executors ejecutan en paralelo sobre particiones de los datos. Las filas se mueven entre executors (un shuffle) cuando un join o una agregación las necesita juntas. Añadir nodos añade capacidad sin cambiar el código.
Todo lo demás en este artículo se deriva de esa división: los motores de un solo nodo arrancan rápido y apenas coordinan nada; Spark paga costes de coordinación que solo compensan cuando el trabajo es lo bastante grande como para repartirlo.
La velocidad cambia con la escala
La guía de selección de kernels de notebook de Microsoft describe un patrón claro, obtenido de benchmarks ELT de extremo a extremo que comparan Fabric Spark con el Native Execution Engine frente a motores de Python de una sola máquina (pandas, DuckDB, Polars):
| Escala de datos comprimidos | Patrón observado por Microsoft |
|---|---|
| Ultrapequeña, menos de ~140 MB | Los motores de Python de una sola máquina (DuckDB, Polars) son más rápidos |
| Pequeña, ~1–2 GB | Los motores de Python siguen teniendo ventaja; Fabric Spark con el Native Execution Engine se vuelve competitivo a medida que aumentan los núcleos por motor, sobre todo en operaciones con muchas escrituras |
| Pequeña-mediana, ~10–13 GB | Fabric Spark con el Native Execution Engine es competitivo o más rápido que la mayoría de los motores de una sola máquina; estos pueden quedarse sin memoria (OOM) con menos vCores |
| Mediana y superior, ~100 GB o más | Para la mayoría de las cargas, Fabric Spark con el Native Execution Engine es el motor más rápido y fiable |
Son observaciones de benchmarks de Microsoft, no límites. El punto de cruce de tu pipeline se mueve según las operaciones (lecturas frente a joins frente a escrituras), los núcleos que recibe cada motor, el formato y la organización de los archivos, el particionado, la compresión, la memoria y la configuración del clúster.
- Un nodo más rápidoMenos de ~140 MBDuckDB y Polars evitan la sobrecarga distribuida
- crecen los datosUn nodo por delante~1–2 GBSpark con NEE competitivo al crecer los núcleos, sobre todo en escrituras
- crecen los datosPunto de cruce~10–13 GBSpark con NEE competitivo o más rápido; un nodo con pocos núcleos puede dar OOM
- crecen los datosSpark con NEE delante~100 GB o másEl más rápido y fiable para la mayoría de las cargas
Por qué los motores de un solo nodo ganan con cargas pequeñas
Con una tabla pequeña, la mayor parte del tiempo transcurrido es sobrecarga, no cómputo. Polars, DuckDB y pandas empiezan a ejecutar dentro del proceso que ya tiene tu sesión: ninguna consulta tiene que dividirse en tareas, ninguna tarea tiene que planificarse en un executor, ninguna fila tiene que serializarse y moverse entre máquinas, y ningún resultado tiene que volver a un driver.
Spark paga todo eso en cada job: planificar y programar stages, lanzar tareas, preparar los archivos de shuffle y coordinar los executors. Con 100 MB, esos costes fijos pueden ser la mayor parte de la ejecución. Con 100 GB son un error de redondeo, y el paralelismo que compran es precisamente lo que importa.
El arranque de la sesión no lo es todo
El arranque de la sesión solía dominar esta comparación. Hoy en Fabric, una sesión de Spark del starter pool arranca en unos cinco segundos, algo comparable a un notebook de Python, y una sesión de Spark de un solo nodo de 8 vCores del starter pool arranca igual de rápido. Los pools de Spark personalizados suelen tardar entre tres y cinco minutos, y Microsoft indica que una ejecución de un notebook de Python que no encuentra hueco en su live pool también puede tardar hasta tres minutos. Mide el arranque de la sesión por separado de la ejecución; la guía de arranque de notebooks explica cómo separar el tiempo de cola, de sesión y de ejecución.
Por qué el Native Execution Engine cambia la comparación
El Native Execution Engine (NEE) es la razón por la que las franjas de Microsoft favorecen a Spark tan pronto. Descarga operadores de Spark compatibles desde la JVM a una ruta de ejecución vectorizada en C++ basada en Velox y Apache Gluten, con soporte nativo de Parquet y Delta, y mantiene el comportamiento del optimizador de Spark (ejecución adaptativa de consultas, poda de columnas, predicate pushdown). No requiere cambios de código.
Lo que significa para esta comparación:
- Reduce la ventaja que aprovechaban los motores de un solo nodo. Polars y DuckDB son rápidos en parte porque son motores vectorizados y columnares. NEE lleva ese mismo estilo de ejecución a los operadores de Spark.
- Ayuda más donde Spark ya es la opción natural: consultas intensivas en cómputo sobre Parquet y Delta, joins, agregaciones y transformaciones complejas. Microsoft señala que las mejoras son menores en consultas sencillas o limitadas por E/S.
- No es universal. Los operadores y funcionalidades no compatibles vuelven automáticamente a Spark sobre la JVM: structured streaming y los orígenes JSON y XML, entre otros. Las comparaciones de fechas necesitan tipos coincidentes en ambos lados. Ese retorno (fallback) se ve en
df.explain()y en la Spark UI (los operadores nativos terminan enTransformero aparecen comoNativeFileScanoVeloxColumnarToRowExec), y Fabric Spark Advisor lo señala en la salida de la celda. - Hay que habilitarlo. Runtime 1.3 y 2.0 lo admiten; actívalo en la configuración Acceleration del entorno o con
spark.native.enableden%%configure.
Microsoft informa de mejoras de varias veces en cargas de benchmark representativas. La cifra concreta de la página del runtime es hasta seis veces más rápido que Spark de código abierto en TPC-DS con factor de escala 1000 usando Delta, lo que Microsoft traduce en un ahorro de alrededor del 83 % en costes de cómputo con un clúster de tamaño fijo. Tómalo como el techo de un benchmark, no como un multiplicador para tu job.
La memoria suele ser el factor decisivo
Las gráficas de velocidad hacen que los motores parezcan intercambiables hasta que uno se queda sin memoria. En la práctica, la memoria decide más elecciones de motor que la velocidad bruta.
pandas mantiene cada DataFrame intermedio completo en memoria, en un solo proceso. Parquet comprimido ocupa poco en disco; las columnas descomprimidas en memoria ocupan más, y las columnas de objetos de Python y de cadenas pueden ocupar muchísimo más. Los joins, las conversiones de tipo y las copias multiplican el conjunto de trabajo. Por eso pandas puede quedarse sin memoria con datos cuyo tamaño en almacenamiento parece inofensivo, y por eso el primer consejo de Microsoft ante un OOM es dejar de usarlo.
Polars mantiene los datos en un formato columnar compacto, usa todos los núcleos y, con la API lazy, lee solo las columnas y los row groups que necesita una consulta. Su motor de streaming (collect(engine="streaming") en las versiones actuales) procesa las consultas por lotes y puede manejar datos que no caben en memoria, pero las operaciones que no están implementadas en streaming vuelven al motor en memoria, lo que puede devolver la presión de memoria. Suele ser mucho más eficiente en memoria que pandas, pero el límite sigue siendo la máquina.
DuckDB ejecuta SQL vectorizado directamente sobre archivos y admite cargas mayores que la memoria derramando a disco (spill): las agrupaciones, los joins, las ordenaciones y las funciones de ventana pueden volcar datos intermedios a un directorio temporal. Su propia documentación enumera las excepciones: varios operadores bloqueantes en una misma consulta pueden seguir provocando un error de falta de memoria, y algunas agregaciones (como string_agg) no pueden derramar a disco.
Spark reparte el conjunto de trabajo entre executors. La entrada se divide en particiones, cada tarea procesa una porción, los shuffles distribuyen los datos intermedios, y los datos de shuffle, ordenación y agregación pueden derramar a disco. La capacidad crece añadiendo workers.
- pandasUn proceso, ejecución inmediata
- Crecen los datos
- Todo el DataFrame en memoriaMás las copias de joins y conversiones
- Presión de memoriaMuy por debajo del tamaño nominal del nodo
- OOMEl kernel muere; se pierden las variables
- Polars y DuckDBUna máquina, columnar
- Crecen los datos
- Columnar, pushdownLee solo las columnas y row groups necesarios
- Lotes o spillStreaming en Polars; DuckDB derrama a disco
- Límite de la máquinaUn nodo mayor, hasta 64 vCores, y ahí se acaba
- SparkDriver más executors
- Crecen los datos
- ParticionarLa entrada se divide en tareas
- Distribuir y hacer shuffleLos executors comparten el conjunto de trabajo; spill a disco
- Añadir workersEl sesgo, los broadcasts y los collect al driver aún pueden dar OOM
Spark también puede quedarse sin memoria
La memoria distribuida desplaza el límite; no lo elimina. Los OOM clásicos de Spark tienen que ver con concentrar datos en un solo sitio:
- Recogida en el driver.
collect()ytoPandas()traen el resultado completo al driver. - Broadcasts demasiado grandes. Un broadcast join copia el lado pequeño a cada executor; hacer broadcast de algo que no es pequeño falla en el driver o en los executors.
- Sesgo (skew). Una clave con una gran proporción de las filas envía esa proporción a una sola tarea, tengas los executors que tengas.
- Particiones demasiado grandes. Pocas particiones para los datos significan que cada tarea carga demasiado.
- Caché descuidada. Cachear resultados intermedios grandes quita memoria de executor al trabajo que la necesita.
- Estado sin límite. Linajes largos, particiones de ventana grandes o un estado de streaming que no deja de crecer.
La guía de rendimiento de notebooks y la cheat sheet de rendimiento de PySpark explican cómo encontrarlos y corregirlos.
Comparación de memoria
| Motor | Límite de memoria de un solo nodo | Ejecución lazy o streaming | Spill a disco | Memoria distribuida |
|---|---|---|---|---|
| pandas | Sí: todo el conjunto de trabajo en un proceso | No: inmediata, cada paso se materializa | No | No |
| Polars | Sí: una máquina | Planes lazy; el motor de streaming procesa por lotes y vuelve al motor en memoria en operaciones no compatibles | No es un mecanismo general; depende del streaming | No |
| DuckDB | Sí, acotado por su límite de memoria en una máquina | Los pipelines vectorizados procesan las lecturas en flujo | Sí: operadores GROUP BY, JOIN, ORDER BY y de ventana; algunas consultas y agregaciones aún pueden dar OOM | No |
| PyArrow | Sí: una máquina | Lectura de datasets por lotes de registros | Ningún mecanismo general | No |
| PySpark, Spark SQL, API de pandas en Spark | El driver tiene su propio límite para collects, toPandas() y broadcasts |
Planes lazy, ejecutados por stage | Sí: datos de shuffle, ordenación y agregación | Sí, entre executors |
Los motores de un vistazo
| Motor | Modelo de ejecución | Sobrecarga de arranque | Modelo de memoria | Escalado horizontal | Capacidad Delta en Fabric | Mejor uso |
|---|---|---|---|---|---|---|
| pandas | Un proceso, inmediato, casi siempre un núcleo | Baja | Todo en memoria; cadenas y objetos costosos | No | Mediante delta-rs o Spark, no de forma nativa | Datos pequeños, resultados finales, ecosistema de Python |
| Polars | Una máquina, multihilo, columnar, optimizador lazy | Baja | Columnar; pushdown; lotes de streaming | No | Lectura; append, overwrite y MERGE; sin UPDATE ni DELETE | ETL rápido con DataFrames en un solo nodo |
| DuckDB | Motor SQL vectorizado embebido | Baja | Vectorizado; derrama los operadores bloqueantes | No | Lectura; solo INSERT | SQL sobre archivos, análisis ad hoc |
| PyArrow | Formato columnar, E/S y kernels de cómputo | Baja | Buffers de Arrow; lectura por lotes | No | Mediante deltalake (delta-rs) |
Intercambio, E/S de Parquet, traspaso sin copia |
| API de pandas en Spark | API de estilo pandas compilada a Spark | Media | Distribuida | Sí | Completa, mediante Spark | Conocimientos de pandas sobre el motor de Spark |
| DataFrame de PySpark | Distribuido: driver, executors, NEE opcional | Media | Distribuida; spill | Sí | Completa | ETL de producción, joins grandes, Delta |
| Spark SQL | El mismo motor que PySpark | Media | Distribuida; spill | Sí | Completa | Equipos SQL a cualquier escala |
Aquí, «sobrecarga de arranque» incluye la coordinación de cada job además del inicio de la sesión. Una sesión de Spark ya caliente sigue programando tareas para cada consulta.
Joins, agregaciones y escrituras
Joins
En un solo nodo, un join es rápido si ambos lados y el resultado caben holgadamente en memoria. Polars y DuckDB son excelentes en esto; pandas va bien mientras los DataFrames son pequeños. DuckDB puede derramar a disco un join grande; pandas no.
En Spark, la estrategia de join importa más que el tamaño de la entrada:
- Broadcast hash join: el lado pequeño se copia a cada executor y el lado grande nunca se mueve. Spark hace broadcast automáticamente por debajo de
spark.sql.autoBroadcastJoinThreshold(10 MB por defecto en Apache Spark). - Joins con shuffle: ambos lados se reparticionan por la clave de join para que las filas coincidentes se encuentren en el mismo executor. Es lo que hace posibles los joins entre tablas grandes, y también donde está la mayor parte del coste.
- Sesgo: si una clave domina, una sola tarea hace la mayor parte del trabajo. La ejecución adaptativa de consultas, habilitada por defecto desde Spark 3.2, puede dividir particiones sesgadas en los sort-merge joins, pero no puede arreglar un modelo de datos en el que un cliente es la mitad de la tabla.
La forma del join puede importar más que el tamaño de los archivos. Leer 100 GB con un filtro selectivo puede salir más barato que hacer un join entre dos tablas de 5 GB por una clave de alta cardinalidad, porque el join tiene que mover y emparejar cada fila de ambos lados. Reduce los dos lados antes del join (filtra, proyecta, agrega al grano necesario) y luego mide. La cheat sheet de joins de PySpark recoge los patrones.
Agregaciones
Una agregación vectorizada local en Polars o DuckDB es excepcionalmente rápida: sin shuffle, con todos los núcleos trabajando sobre un mismo espacio de memoria compartido. Spark agrega en dos fases, una agregación parcial en cada executor y luego un shuffle para combinar los parciales, lo que añade sobrecarga con datos pequeños y escala con datos grandes.
La agregación en un solo nodo deja de ser la mejor opción cuando la tabla hash ya no cabe (claves de agrupación de alta cardinalidad), cuando la entrada es demasiado grande para leerla en un tiempo aceptable con los núcleos de una máquina, cuando varios usuarios o jobs comparten la misma capacidad, o cuando la agregación es un paso de un pipeline cuyo verdadero cuello de botella son las escrituras y los joins.
Las escrituras importan más de lo que sugieren los benchmarks
Los benchmarks suelen medir lecturas, porque las lecturas son fáciles de comparar. Los pipelines de producción también escriben, y las escrituras separan más a los motores que las lecturas:
- Las escrituras de Parquet están bien soportadas en todas partes. Spark escribe muchos archivos en paralelo (uno o más por tarea); los motores de un solo nodo suelen escribir uno o unos pocos. Ninguna opción es incorrecta, pero el número y el tamaño de los archivos afectan a todas las lecturas posteriores; consulta el mantenimiento de tablas Delta para el problema de los archivos pequeños.
- Las escrituras Delta son donde más difieren los motores: semántica transaccional, MERGE, UPDATE y DELETE, deletion vectors, checkpoints y mantenimiento. La siguiente sección tiene los detalles.
- MERGE a escala es un join más una reescritura de los archivos afectados. Spark con deletion vectors lo gestiona como merge-on-read; ahí se aplican los patrones de rendimiento de MERGE en Delta.
- Los escritores concurrentes necesitan detección de conflictos. Spark y delta-rs implementan control de concurrencia optimista; un INSERT de DuckDB no detecta conflictos.
Una lectura local rápida no convierte a un motor en la mejor opción para el ETL de producción. El motor tiene que terminar la escritura correctamente, de forma transaccional y con una organización que el siguiente lector pueda aprovechar.
Compatibilidad con Delta Lake
Este es el factor decisivo en muchos pipelines de Fabric, porque las tablas del Lakehouse son tablas Delta. La tabla siguiente resume la matriz de funcionalidades de Microsoft, que refleja pruebas directas con Fabric Spark Runtime 1.3 y 2.0 a junio de 2026. El ecosistema Delta de código abierto para Python publica versiones con frecuencia; revisa las notas de versión de cada proyecto antes de depender de una funcionalidad.
| Funcionalidad Delta | Fabric Spark | delta-rs (deltalake) |
DuckDB | Polars |
|---|---|---|---|---|
| Leer tablas Delta | Sí | Sí | Sí | Sí |
| Append y overwrite | Sí | Sí | Solo INSERT, sin evolución de esquema | Sí |
| MERGE | Sí | Sí | No | Sí |
| UPDATE y DELETE | Sí | Sí | No | No |
| Escribir deletion vectors | Sí | No | No | No |
| Leer deletion vectors | Sí | No | Sí | Sí |
| OPTIMIZE | Sí | Sí | No (usa delta-rs) | No (usa delta-rs) |
| VACUUM | Sí | Solo VACUUM LITE | No | No |
| Escribir Change Data Feed | Sí | No | No | No |
| Escrituras con Liquid Clustering | Sí | No | No | No |
| Checkpoints | Cada 10 commits por defecto | Configurable, 100 por defecto | INSERT no escribe ninguno | Configurable, 100 por defecto |
Las consecuencias que destaca Microsoft:
- Los deletion vectors están habilitados por defecto para las tablas nuevas a partir de Runtime 2.0, y ningún motor de Python puede escribirlos. Escribir con un motor de Python en una tabla con deletion vectors habilitados provoca errores de compatibilidad.
- Los pipelines que mezclan motores necesitan fijar la versión. Si Polars o DuckDB leen y delta-rs escribe, ambos lados deben fijar la versión de la tabla para mantener el aislamiento entre lectura y escritura.
- Las tablas escritas solo por motores de Python acumulan archivos pequeños y logs de transacciones largos a menos que ejecutes tú mismo el mantenimiento con delta-rs; un INSERT de DuckDB nunca escribe checkpoints.
- Los metadatos de row tracking (
row_id,row_commit_version) solo se pueden leer en Spark, así que la lógica de CDC o deduplicación que dependa de ellos debe leer con Spark.
La propia recomendación de Microsoft es tratar los motores de Python como un complemento de Spark para lecturas ligeras, desarrollo local y appends sencillos, y no como un sustituto de uso general. Para el modelo Delta en sí, consulta tablas Delta para ingenieros de SQL Server.
Soporte técnico
Es la pregunta del arquitecto que las gráficas de velocidad nunca responden: ¿quién lo arregla cuando se rompe?
Fabric Spark es el fork de Apache Spark de Microsoft. Microsoft mantiene y distribuye el runtime, da soporte de extremo a extremo a los componentes internos de Spark y Delta, incluido el Native Execution Engine, y acepta incidencias de soporte sobre el comportamiento de Spark, planes de consulta, problemas de memoria y errores del motor. Las actualizaciones del runtime aportan mejoras de rendimiento al código existente.
DuckDB y Polars son motores de código abierto que Fabric pone a tu disposición. Microsoft no mantiene forks de ellos. Su soporte cubre las integraciones con OneLake incluidas en el runtime de Fabric, como la autenticación y el acceso al sistema de archivos. Un error del motor, una regresión de rendimiento o un cambio de API entre versiones de la biblioteca se gestionan con la comunidad de código abierto. Microsoft también señala que los cambios de API entre versiones pueden requerir refactorizar, que ninguno de los dos motores tiene un equivalente de monitorización en vivo como la Spark UI, y que un stack ELT completo construido sobre ellos suele combinar varias bibliotecas (DuckDB para transformar, delta-rs para escrituras y mantenimiento) cuyas versiones tendrás que mantener compatibles.
Nada de eso los convierte en una mala elección. Los convierte en una elección cuyo riesgo operativo asumes tú. Para un notebook que un analista ejecuta bajo demanda, eso suele estar bien. Para el pipeline que alimenta un cierre financiero, merece una decisión explícita.
Coste y concurrencia
«Spark siempre cuesta más» es un mito, y lo contrario también. Fabric factura el cómputo en unidades de capacidad a lo largo del tiempo, así que, para una configuración dada:
Coste = recursos reservados × tiempo transcurrido.
La guía de selección de Microsoft da los puntos de referencia:
| Configuración | vCores | Unidades de capacidad durante la ejecución |
|---|---|---|
| Notebook de Python, predeterminado | 2 | 1 CU |
| Notebook de Python, el más grande | 64 | 32 CU |
| Spark, un solo nodo de 4 vCores (pool personalizado, arranque más lento) | 4 | 2 CU |
| Spark, un solo nodo de 8 vCores (starter pool) | 8 | 4 CU |
| Starter pool de Spark, tras el escalado proactivo | Workers de 8 núcleos | 8 CU como mínimo |
Dos consecuencias:
- Con trabajos pequeños, un notebook de Python de 2 vCores que termina en el mismo tiempo que Spark usa una fracción de la capacidad. La configuración de Spark de un solo nodo de 8 vCores existe para reducir esa diferencia sin renunciar a las funcionalidades de Spark.
- Con trabajos grandes, un motor que termina varias veces más rápido con más núcleos puede consumir menos en total que un motor más pequeño que tarda mucho más, o que uno que falla y se vuelve a ejecutar.
La contabilidad real de la capacidad tiene más matices (suavizado, bursting, operaciones en segundo plano frente a interactivas); consulta la capacidad de Fabric explicada antes de prometer CU a un equipo de finanzas.
La concurrencia vuelve a cambiar el panorama. Cinco analistas que ejecutan cada uno un notebook de Python de 64 vCores reservan cinco nodos grandes; el modo de alta concurrencia de Spark permite que notebooks compatibles compartan una sesión, y los pools de Spark aíslan las cargas. Microsoft incluye la alta concurrencia y la planificación de jobs FAIR o FIFO entre los motivos para elegir el kernel de Spark. Cuando muchos jobs comparten una capacidad, elige el motor pensando en la capacidad, no solo en un job.
Primero Spark, pandas al final
La línea individual más cara de muchos notebooks de Fabric es esta:
pdf = spark_df.toPandas() # on a large DataFrame: every row moves to the drivertoPandas() recoge el DataFrame de Spark completo en la memoria del driver y lo convierte a pandas. Con una tabla grande, convierte un job distribuido en uno de una sola máquina en el peor momento posible, y el driver se queda sin memoria mucho antes de que lo hicieran los executors. La guía de Microsoft es directa: úsalo solo con conjuntos de resultados pequeños o medianos; filtra, agrega o muestrea antes en Spark.
- 2 TBTablas del LakehouseSe quedan en Spark
- SparkFiltrar y proyectarPredicados empujados a la lectura; solo las columnas necesarias
- SparkAgregarReducir al grano que necesita el análisis
- 20 MBResultado pequeñoCabe holgadamente en la memoria del driver
- toPandas()pandasGráficos, machine learning, bibliotecas de Python
from pyspark.sql import functions as F

monthly = (spark.read.table("sales_orders")
           .where(F.col("order_date") >= "2026-01-01")
           .groupBy("region", F.trunc("order_date", "month").alias("month"))
           .agg(F.sum("amount").alias("revenue")))

pdf = monthly.toPandas() # a few hundred rows, not two terabytesLa misma regla se aplica en la otra dirección: no cargues un archivo grande en pandas en un notebook de Python «para echarle un vistazo». Usa Polars o DuckDB para reducirlo y convierte después el resultado pequeño si una biblioteca necesita pandas.
Dónde brilla cada motor
pandas: el último tramo adecuado
pandas no es el villano de este artículo. Sigue siendo excelente para datos pequeños, para conjuntos de resultados finales, para el trabajo de ciencia de datos y, sobre todo, por su compatibilidad con el ecosistema: las bibliotecas de gráficos, los paquetes de estadística y de machine learning, e innumerables herramientas posteriores esperan un DataFrame de pandas. pandas suele ser el último tramo adecuado, no el primero cuando hay muchísimos datos. Sus límites son la ejecución en un solo proceso y tenerlo todo en memoria, no su calidad.
Polars: DataFrames rápidos en un solo nodo
Polars resulta atractivo para la exploración en notebooks, las transformaciones de archivo a archivo, los conjuntos de datos medianos que caben en una máquina y el ETL de alto rendimiento en un solo nodo, con una API de DataFrames que resulta familiar. Usa la API lazy (scan_parquet en lugar de read_parquet) para que el optimizador pueda descartar columnas y row groups antes de leer.
import polars as pl

top_customers = (pl.scan_parquet("/lakehouse/default/Files/raw/orders/*.parquet")
                 .filter(pl.col("status") == "shipped")
                 .group_by("customer_id")
                 .agg(pl.col("amount").sum().alias("revenue"))
                 .sort("revenue", descending=True)
                 .head(100)
.collect())No es un «mini Spark». No distribuye, no tiene un clúster hacia el que crecer, y cuando los datos superan el nodo más grande, el código tiene que migrar.
DuckDB: SQL sobre archivos
DuckDB encaja con el análisis basado en SQL: leer Parquet, hacer joins entre archivos, la exploración ad hoc y el procesamiento analítico embebido dentro de un notebook de Python, sin cargar antes nada en un DataFrame. En un notebook de Python con un lakehouse predeterminado adjunto, los archivos del Lakehouse están disponibles en /lakehouse/default/Files/:
import duckdb

duckdb.sql("""
    SELECT region, date_trunc('month', order_date) AS month, sum(amount) AS revenue
    FROM read_parquet('/lakehouse/default/Files/raw/orders/*.parquet')
    WHERE status = 'shipped'
    GROUP BY ALL
    ORDER BY ALL
""").df() # convert the small result for pandas-based toolsPara las tablas del Lakehouse, parte del fragmento de código que genera el notebook (arrastra la tabla al lienzo o usa Load data), que usa las bibliotecas Delta incluidas en el runtime. Las escrituras Delta de DuckDB son solo INSERT, así que usa delta-rs para todo lo demás.
PySpark y Spark SQL: un motor, dos lenguajes
PySpark y Spark SQL se compilan a los mismos planes y se ejecutan sobre el mismo cómputo de Spark, incluido el Native Execution Engine. Microsoft describe los lenguajes del kernel de Spark (PySpark, Spark SQL, Scala, SparkR) como «todos respaldados por el mismo cómputo de Spark». Spark SQL no implica una escala menor que PySpark.
Elige según el estilo de expresión y las habilidades del equipo:
- Spark SQL para transformaciones basadas en conjuntos que un equipo de SQL leerá y revisará, y para lógica que encaja de forma natural en
SELECT … JOIN … GROUP BY. - PySpark para pipelines programáticos: listas de columnas parametrizadas, funciones reutilizables, esquemas dinámicos y transformaciones que se pueden probar con tests unitarios (consulta tests unitarios de PySpark con pytest).
Mezclarlos en un mismo notebook es normal: spark.sql(...) devuelve un DataFrame y createOrReplaceTempView expone uno a SQL.
API de pandas en Spark: sintaxis familiar, motor distribuido
La API de pandas en Spark (import pyspark.pandas as ps) ofrece una sintaxis de estilo pandas sobre el motor distribuido de Spark. Tiene sentido para equipos con buen dominio de pandas, para llevar lógica de pandas existente a datos más grandes y como ayuda en una migración. Para la ingeniería de producción exigente, PySpark nativo o Spark SQL suelen ser más claros: trasladar la semántica de pandas (orden de las filas, alineación de índices) a un motor distribuido puede ocultar operaciones costosas, y los planes, los joins y el particionado son más fáciles de razonar con las API nativas. Es una opción legítima, no un atajo para no entender Spark.
Diseña para el volumen de mañana, no para la muestra de hoy
Las decisiones de motor suelen tomarse con los datos de hoy:
| Volumen diario | Cómo se comporta un pipeline de un solo nodo | |
|---|---|---|
| Hoy | 700 MB | Rápido, barato, sencillo |
| Dentro de seis meses | 15 GB | Nodo más grande, ejecuciones más largas, algún OOM |
| Dentro de dos años | 200 GB | Reescritura |
La reescritura es la parte cara: API distintas, rutas de escritura Delta distintas, tests distintos, monitorización distinta, y una migración hecha con prisas porque el job ya falla. Microsoft dice lo mismo en su guía de selección: migrar código cuando los datos superan los límites de un motor no distribuido es costoso, y empezar con Spark en una configuración de un solo nodo permite escalar a varios nodos sin reescribir el pipeline.
Así que hazte dos preguntas, no una: ¿qué tamaño tienen los datos? y ¿qué tamaño tendrán durante la vida de este pipeline? Si la respuesta honesta a la segunda es «grande, o no lo sé», empieza en Spark, aunque un motor de un solo nodo gane el benchmark de hoy.
Un marco de decisión por tamaño de datos
La referencia es la guía de Microsoft: usa el kernel de Python para datos por debajo de aproximadamente 1 GB comprimido cuando lo que más importa es el rendimiento en una sola máquina, y el kernel de Spark a partir de 1 GB comprimido, o cuando esperes que los datos crezcan hasta esa escala. Las franjas que siguen son mis propias heurísticas de trabajo en torno a ese límite.
| Entrada comprimida | Punto de partida | Por qué |
|---|---|---|
| Menos de ~1 GB, estable | Polars o DuckDB en un notebook de Python; pandas para DataFrames realmente pequeños | La menor sobrecarga; el rango del kernel de Python según Microsoft |
| Menos de ~1 GB, en crecimiento | Spark, un solo nodo de 8 vCores del starter pool | El mismo arranque rápido, sin reescribir después |
| ~1–10 GB | Haz benchmark de ambos; por defecto, Spark para pipelines de producción | Microsoft recomienda Spark a partir de 1 GB; los motores de un solo nodo aún pueden ganar en lecturas y trabajo interactivo |
| ~10–100 GB | PySpark o Spark SQL para pipelines de producción | La franja de cruce de Microsoft; los joins, las escrituras y el riesgo de OOM favorecen a Spark |
| ~100 GB o más | PySpark o Spark SQL con el Native Execution Engine | Microsoft observa que Spark con NEE es el más rápido y fiable para la mayoría de las cargas |
Sea cual sea el tamaño, dos condiciones empujan por sí solas hacia Spark: funcionalidades Delta que los motores de Python no pueden escribir (deletion vectors, patrones con mucho MERGE en DuckDB, UPDATE y DELETE en Polars, Change Data Feed, Liquid Clustering) y joins o escrituras grandes.
Guía de decisión por carga de trabajo
Guía de decisión de Javi Builds (no es un requisito de Microsoft). «Muy adecuado»: una opción predeterminada sensata. «Posible»: funciona, pero no es la opción obvia. «Benchmark primero»: la respuesta depende de tus datos y tu capacidad. «Mejor evitar»: encaja mal con esa arquitectura.
| Carga de trabajo | pandas | Polars | DuckDB | PySpark | Spark SQL |
|---|---|---|---|---|---|
| Filtro sobre 100 MB | Posible | Muy adecuado | Muy adecuado | Posible | Posible |
| Agregación de 1 GB | Benchmark primero | Muy adecuado | Muy adecuado | Posible | Posible |
| Join de 10 GB | Mejor evitar | Benchmark primero | Benchmark primero | Muy adecuado | Muy adecuado |
| Transformación de 100 GB | Mejor evitar | Mejor evitar | Mejor evitar | Muy adecuado | Muy adecuado |
| MERGE Delta grande | Mejor evitar | Mejor evitar | Mejor evitar | Muy adecuado | Muy adecuado |
| Exploración interactiva de datos pequeños | Muy adecuado | Muy adecuado | Muy adecuado | Posible | Posible |
| Análisis SQL repetido sobre archivos modestos | Mejor evitar | Posible | Muy adecuado | Posible | Muy adecuado |
| ETL distribuido grande | Mejor evitar | Mejor evitar | Mejor evitar | Muy adecuado | Muy adecuado |
Árbol de decisión
- Dimensiona la cargaEntrada comprimida hoy y durante la vida del pipeline
- ¿Cabe en un nodo y seguirá cabiendo?Las tres primeras ramas suponen que sí
- SQLDuckDBSQL sobre Parquet y lecturas Delta
- DataFramesPolarsTransformaciones lazy y multihilo
- resultadospandasResultados pequeños para el ecosistema de Python
- crecePySpark o Spark SQLEmpieza en un nodo de 8 vCores; escala después
- DeltaSpark con NEEMERGE, deletion vectors, OPTIMIZE, joins grandes
Benchmark real en Fabric
La guía de Microsoft y este benchmark son tipos de evidencia distintos. Las franjas de benchmark citadas antes son una referencia documentada de Microsoft. El benchmark de Javi Builds es un experimento observado: una carga de trabajo realista en un área de trabajo de Fabric (ws_fabric_engine_benchmark), orquestada por un pipeline (pl_fabric_engine_benchmark), con cada cifra publicada trazada hasta una ejecución. Se sitúa junto a las franjas de Microsoft; no las sustituye.
Los resultados que siguen proceden de un piloto: el pipeline ejecutó las seis configuraciones de motor (pandas, Polars, DuckDB, PySpark, Spark SQL y PySpark con el Native Execution Engine), pero los tiempos a nivel de motor publicados hasta ahora son ejecuciones únicas de pandas y Polars con un solo tamaño de datos. Las ejecuciones controladas y repetidas que se describen en Método son el siguiente paso. Cuando un valor no se midió, esta sección lo dice en lugar de estimarlo.
Tres dimensiones de rendimiento, nunca una sola clasificación
Un benchmark en Fabric produce tres tipos de duración. Responden a preguntas distintas, y sumarlas o clasificarlas juntas da un resultado engañoso.
| Dimensión | Qué mide | De dónde sale | Ejemplo de este experimento |
|---|---|---|---|
| Tiempo de procesamiento del motor | El trabajo del motor desde la lectura hasta la escritura, etapa por etapa | Temporizadores dentro del notebook de benchmark | pandas 2,3387 s, Polars 2,5467 s en el conjunto S (una ejecución) |
| Duración de la actividad de notebook | Una actividad del pipeline de principio a fin: sesión del notebook, parámetros, imports, el trabajo del motor y el ciclo de vida de la actividad | Columna Duration de la pestaña Output del pipeline | Actividad independiente de Polars: 34 s |
| Tiempo total real del pipeline (wall-clock) | Desde el inicio de la primera actividad hasta el final de la última, incluidas las ramas paralelas y las esperas | La ejecución del pipeline, o derivado de la tabla de actividades | Unos 7 min 54 s en la última ejecución |
La distancia entre las dos primeras filas es la lección principal con datos pequeños: una actividad independiente de benchmark de Python tardó entre 34 y 38 segundos, mientras que el procesamiento que pretende medir tardó unos 2,5 segundos en una ejecución medida. Una comparación de motores tiene que usar la primera fila. Una comparación de diseños de pipeline usa la segunda y la tercera.
Conjunto de datos
La entrada son datos públicos reales: los registros de viajes de los taxis amarillos de la NYC Taxi & Limousine Commission de 2025, en los archivos Parquet mensuales oficiales, más la tabla oficial de zonas de taxi. Los doce archivos de 2025 suman unos 840 MB comprimidos y 49,4 millones de filas, con los mismos tipos de columna en todos los meses.
| Nivel | Entrada | Estado |
|---|---|---|
| XS | Un mes de 2025 | Usado por las actividades de Spark en el piloto |
| S | Tres archivos mensuales | Verificado: 11.198.026 registros sin procesar, 1.240 filas agregadas |
| M | Doce meses | Previsto |
| L, XL | Copias repetidas de los doce meses, generadas con Spark hasta unos 10 GB y 100 GB | Previsto |
Los niveles mayores se etiquetan como lo que son: copias repetidas/escaladas de datos reales de la TLC para pruebas de rendimiento. Cada copia lleva un benchmark_replica_id, de modo que el esquema y las distribuciones de valores son reales, pero los viajes no son únicos.
Carga de trabajo
Todos los motores ejecutan el mismo pipeline lógico sobre los mismos archivos preparados, de Parquet a Parquet, en seis etapas cronometradas: lectura, transformación, agregación, join, ordenación y escritura.
- mismos archivosParquet de la TLC preparadoIdentificado por nombre y tamaño de archivo
- 8 columnasProyectar y filtrarDistancia e importe positivos, llegada posterior a la recogida
- zona, pagoAgregarViajes, ingresos, propinas, tarifa media, distancia, duración
- tabla de zonasJoin y ordenaciónLeft join por zona de recogida, ingresos descendentes
- escrituraUn archivo ParquetValidado después frente a todos los demás motores
- Transformación: conservar los viajes con distancia e importe total positivos y con la llegada posterior a la recogida, y calcular la duración del viaje en minutos.
- Agregación: agrupar por zona de recogida y tipo de pago (1.240 grupos en el conjunto S) y calcular el número de viajes, los ingresos, las propinas, la tarifa media, la distancia media y la duración media.
- Join: un left join del resultado agregado con la tabla de zonas de taxi por el ID de la zona de recogida, de modo que los grupos con una zona desconocida se conservan con los nombres de zona vacíos en lugar de descartarse.
- Ordenación y escritura: ingresos en orden descendente con criterios de desempate deterministas, escritos como un único archivo Parquet.
Resultados: pandas y Polars en el conjunto S
| Etapa | pandas | Polars |
|---|---|---|
| Lectura | 1,1506 s | 1,0510 s |
| Transformación | 0,2203 s | 0,2103 s |
| Agregación | 0,7495 s | 1,0863 s |
| Join | 0,0752 s | 0,0663 s |
| Ordenación | 0,0054 s | 0,0065 s |
| Escritura | 0,1377 s | 0,1263 s |
| Total | 2,3387 s | 2,5467 s |
Lo que respaldan las cifras:
- Los dos motores dieron la misma respuesta. 1.240 filas de salida, unos ingresos totales de 287.431.793,68 $, unas propinas totales de 31.903.631,09 $ y checksums SHA-256 idénticos.
- Leer y agregar es el trabajo. Lectura más agregación suponen el 81 % del total de pandas y el 84 % del total de Polars. Una vez que 11,2 millones de filas se convierten en 1.240 grupos, el join, la ordenación y la escritura apenas cuestan nada.
- Polars no se ejecutó aquí en su mejor modo. Para medir por etapas, cada etapa tiene que terminar antes de que empiece la siguiente, así que Polars tuvo que materializar cada resultado intermedio en lugar de dejar que su optimizador lazy planificara todo el pipeline de una vez. La etapa de agregación, donde la diferencia es mayor, es justo donde un plan lazy fusionado sería distinto. Una ejecución lazy de extremo a extremo es otra medición, y la siguiente que hay que hacer.
- A este tamaño, la elección del motor son unos cientos de milisegundos. Es la misma conclusión que la franja más pequeña de Microsoft: con datos pequeños, todos los motores de un solo nodo son rápidos, y lo que domina es la sobrecarga de otras partes.
Otros motores del piloto
DuckDB, PySpark, Spark SQL y PySpark con el Native Execution Engine se ejecutaron correctamente como actividades del pipeline. Sus tiempos de procesamiento del motor en el conjunto S no se publican, porque todavía no existen las mediciones que los harían comparables (el mismo conjunto de datos, ejecuciones repetidas, salida validada de forma cruzada). Sus duraciones de actividad en el pipeline están en la sección de orquestación, y no son tiempos de motor: la duración de una actividad de Spark incluye la obtención de una sesión de Spark, y las actividades de Spark procesaron el conjunto XS.
Método
Qué hizo el piloto. pandas, Polars y DuckDB se ejecutaron en un notebook de Python de Fabric (nb_fabric_engine_python), parametrizado con engine, dataset_scale y run_count; PySpark, Spark SQL y PySpark con el Native Execution Engine se ejecutaron en notebooks de Spark. Un pipeline preparó los datos y después ejecutó los motores. El notebook de cada motor cronometró las seis etapas y escribió un checksum de su salida.
Qué harán las ejecuciones controladas. Para cada motor y tamaño de datos:
- Repeticiones: una primera ejecución en una sesión nueva y después al menos cinco ejecuciones posteriores, de las que se publica la mediana con el mínimo y el máximo. Se conservan todas las ejecuciones, incluidos los fallos. Cinco es el mínimo para publicar una afirmación de rendimiento; con menos ejecuciones no se pueden separar diferencias pequeñas del ruido.
- Tiempos: una ejecución por etapas (para ver adónde va el tiempo) y otra de extremo a extremo (el mejor plan propio de cada motor, incluida la escritura). Los tiempos de Spark terminan siempre en una acción, para que un plan lazy nunca se confunda con trabajo realizado.
- Aislamiento: un motor por kernel de Python recién reiniciado, para que cada cifra de memoria sea la suya; una sesión nueva por configuración de Spark; los hijos de un notebook runner se ejecutan de uno en uno mientras se cronometran.
- El arranque de la sesión se registra por separado de la ejecución y nunca se incluye en el tiempo de procesamiento del motor.
- El entorno se registra desde la sesión en el momento de la ejecución: capacidad, vCores del notebook de Python, pool y tamaño de nodo de Spark, runtime, versiones de las bibliotecas y si la ejecución nativa apareció realmente en el plan de consulta.
Cómo leer los resultados: qué mueve las cifras
- Cómputo de Python frente a cómputo de Spark. Un notebook de Python se ejecuta en un nodo, con 2 vCores y 16 GB por defecto; un notebook de Spark ejecuta un driver y executors de un pool. Compararlos compara hardware además de motores, así que registra ambos y repite con núcleos equivalentes cuando puedas.
- Native Execution Engine. El NEE acelera los operadores de Spark compatibles y vuelve en silencio a la JVM con los demás. Comprueba el plan (
*Transformer,NativeFileScan) en lugar de fiarte del nombre de una actividad. - Ejecución de notebooks en frío frente a en caliente. Un notebook de Python que no encuentra hueco en el live pool de Fabric puede tardar hasta tres minutos en arrancar; uno que sí lo encuentra arranca en segundos. Esa variación cae en la duración de la actividad, no en el tiempo de procesamiento del motor. En este piloto, la primera ejecución correcta del runner tardó 1 min 21 s, y las siguientes, 50 y 51 s.
- Caché y memoria. Volver a leer los mismos archivos se beneficia de la caché de páginas del sistema operativo, de las cachés de metadatos de cada motor y de la caché inteligente de Spark. Una primera ejecución y una quinta miden cosas distintas; publica ambas.
- Lazy frente a inmediato. pandas ejecuta cada paso en cuanto se llama. La API lazy de Polars y Spark planifican primero y ejecutan con collect o con una acción. Medir por etapas obliga a ejecutar en cada etapa y penaliza a los motores lazy; medir de extremo a extremo, no.
- Materialización con acciones en Spark.
df.filter(...)vuelve al instante porque no se ha ejecutado nada. Un tiempo de Spark que no termina encount(),collect()o una escritura mide la planificación, no el procesamiento. - Competencia por recursos compartidos. Las actividades de la misma capacidad, los hijos de un mismo notebook runner y los jobs de otros usuarios comparten recursos. Dos actividades que se solapan en el tiempo pueden ralentizarse mutuamente.
- Ejecuciones repetidas y variabilidad estadística. Las duraciones de las actividades de Spark de este piloto variaron más de un minuto entre ejecuciones del mismo notebook. Una ejecución aislada describe un momento; las medianas de al menos cinco ejecuciones describen el motor.
Validación
Cada ejecución produce una firma del resultado. El número de filas, el número total de viajes y un hash de cada grupo con sus nombres de zona y su número de viajes tienen que coincidir exactamente entre motores. Los totales monetarios tienen que coincidir al céntimo y las medias con una tolerancia relativa de 1e-9, porque los motores suman números de coma flotante en órdenes distintos. Una ejecución que no coincide se marca como VALIDATION_FAILED y su tiempo se excluye. Los fallos se conservan como resultados: un motor que se queda sin memoria, que falla o que el límite de seguridad de pandas omite se publica como tal, sin descartarlo en silencio.
En el piloto, pandas y Polars coincidieron en todas las comprobaciones: número de filas, ingresos, propinas y el checksum SHA-256 de la salida completa.
Evidencias
| Evidencia | Valor |
|---|---|
| Conjunto de datos | Registros de viajes de los taxis amarillos de la NYC TLC, 2025; conjunto S: tres archivos Parquet |
| Filas | 11.198.026 registros sin procesar; 1.240 filas agregadas |
| Totales de salida | Ingresos 287.431.793,68 $; propinas 31.903.631,09 $ |
| Motores con tiempos de procesamiento publicados | pandas, Polars |
| Motores ejecutados en el pipeline | pandas, Polars, DuckDB, PySpark, Spark SQL, PySpark con NEE |
| Repeticiones | 1 ejecución por motor (piloto) |
| Validación | Checksums SHA-256 idénticos para pandas y Polars |
| Área de trabajo y pipeline | ws_fabric_engine_benchmark, pl_fabric_engine_benchmark |
| Ejecuciones del pipeline mostradas | 11 de noviembre de 2026 |
| Capacidad de Fabric | No registrada en la evidencia publicada |
| Cómputo del notebook de Python | No registrado en la evidencia publicada |
| Runtime y pool de Spark | No registrados en la evidencia publicada |
| Ejecución nativa | Se ejecutó una actividad PySpark NEE independiente; aún no se ha publicado evidencia a nivel de plan |
Hay previsto un benchmark de Delta Lake (lectura, append, MERGE, UPDATE, DELETE) como experimento independiente. Los motores no admiten las mismas operaciones Delta, así que mezclar Delta en esta comparación la haría injusta.
Optimizar la orquestación de notebooks de Microsoft Fabric sin session tags
El hallazgo más útil del piloto no tuvo que ver con los motores. Tuvo que ver con cómo el pipeline arrancaba los notebooks de Python.
El diseño original: una actividad de pipeline por motor
La primera versión del pipeline ejecutaba un notebook de preparación y después una actividad Notebook por motor, una tras otra: Benchmark_Pandas, Benchmark_Polars y Benchmark_DuckDB (cada una llamaba a nb_fabric_engine_python con un parámetro engine distinto), y después las tres actividades de Spark.
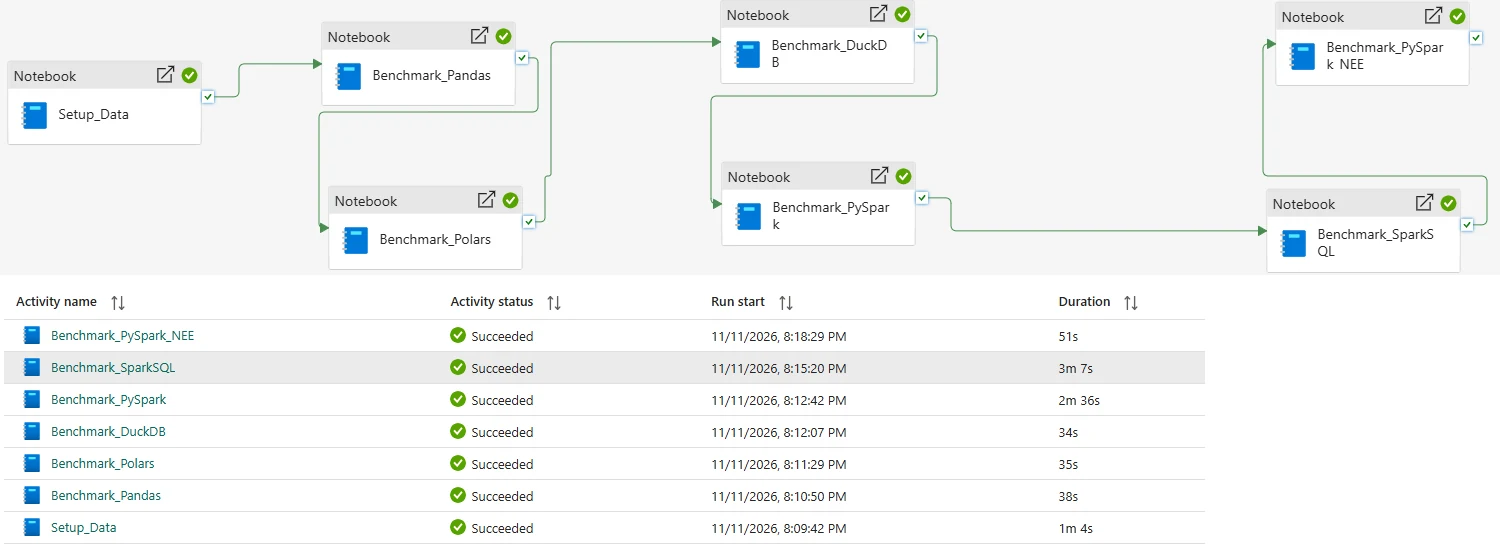
Cada actividad de Python tardó entre 34 y 38 segundos. Una ejecución medida de pandas o Polars sobre el conjunto S hace unos 2,5 segundos de trabajo de motor, así que, con datos pequeños, la mayor parte de una actividad como esta es el coste de ejecutar un notebook como actividad de pipeline, pagado tres veces.
El cambio: un notebook runner que llama a un notebook hijo por motor
Añadimos un notebook padre de Python, nb_fabric_benchmark_runner. Llama al notebook de benchmark existente una vez por motor con notebookutils.notebook.runMultiple(), pasando cada vez un argumento engine distinto, y falla si falla algún hijo. En el pipeline se ejecuta en su propia rama después de Setup_Data, y las tres actividades de Python independientes están marcadas como Inactive.
- Actividades separadasPipeline original
- Setup_Data
- Benchmark_PandasActividad de 35 s
- Benchmark_PolarsActividad de 34 s
- Benchmark_DuckDBActividad de 35 s
- Actividades de SparkEmpiezan tras DuckDB, unos 110 s después de la preparación
- Notebook runnerPipeline actual
- Setup_Data
- benchmark_runnerActividad de 51 s; notebook de Python, runMultiple()
- Hijo pandas
- Hijo Polars
- Hijo DuckDB
- en paraleloActividades de SparkEmpiezan 2 s después de la preparación
Un runner de este tipo es breve. Los valores que siguen son ilustrativos, no una copia de nuestro notebook; dataset_scale y run_count proceden de la celda de parámetros del runner:
# Fabric Python notebook (the runner). Children must also be Python notebooks.
from time import perf_counter
from notebookutils.common.exceptions import RunMultipleFailedException

dag = {
    "activities": [
        {
            "name": f"benchmark_{engine}",
            "path": "nb_fabric_engine_python",           # the existing benchmark notebook
            "args": {"engine": engine, "dataset_scale": dataset_scale, "run_count": run_count},
            "timeoutPerCellInSeconds": 1800,              # default is 90 seconds per cell
        }
        for engine in ["pandas", "polars", "duckdb"]
    ],
    "concurrency": 1,  # run children one at a time while they are being timed
}

notebookutils.notebook.validateDAG(dag)  # catches structural and compute-type errors early
start = perf_counter()
try:
    results = notebookutils.notebook.runMultiple(dag)
except RunMultipleFailedException as error:
    results = error.result
print(f"Runner wall time: {perf_counter() - start:.2f} s")

failures = {name: str(info["exception"]) for name, info in results.items() if info["exception"] is not None}
if failures:
raise RuntimeError(f"Benchmark failures: {failures}")Para un benchmark importan dos ajustes. concurrency vale por defecto tres veces el número de núcleos de CPU del nodo, así que sin él los hijos se ejecutan a la vez y sus tiempos de motor incluyen la carga de los demás. timeoutPerCellInSeconds vale por defecto 90 segundos, algo que un conjunto de datos mayor superará.
Qué mostraron las ejecuciones del pipeline
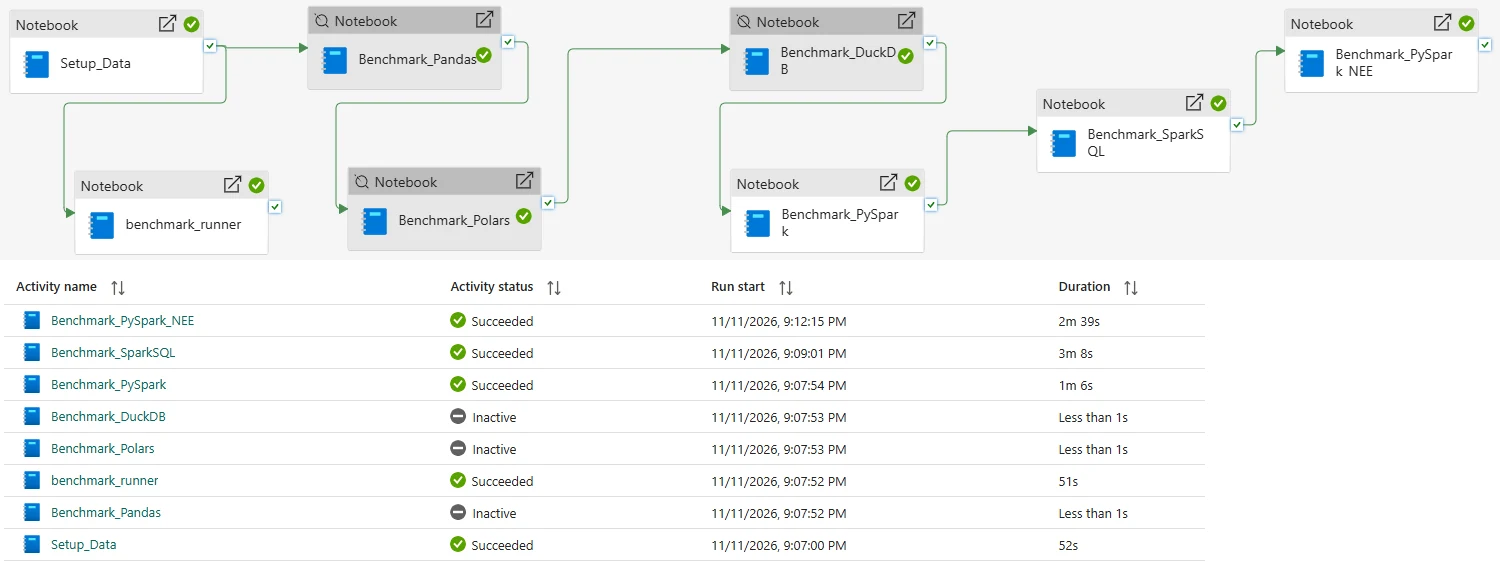
Tres ejecuciones del pipeline del 11 de noviembre de 2026 muestran el cambio. La ejecución B es una ejecución de transición en la que el runner y las actividades independientes se ejecutaron a la vez, así que sus duraciones de actividad se midieron con carga compartida.
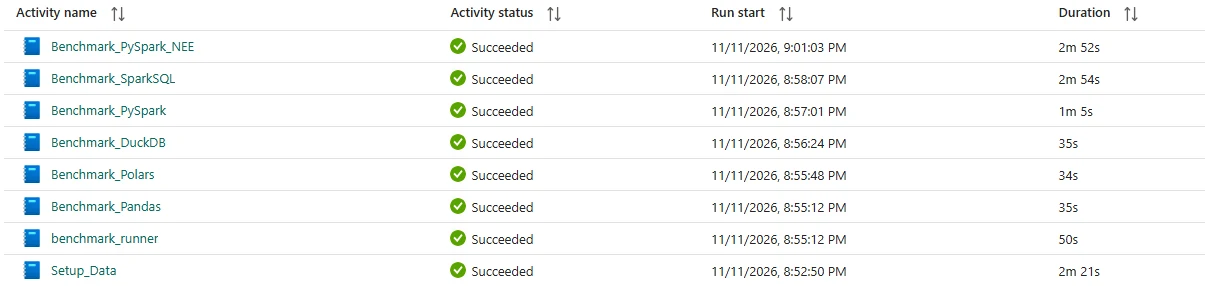
| Ejecución A: actividades separadas | Ejecución B: ambas | Ejecución C: solo el runner | |
|---|---|---|---|
| pandas, Polars, DuckDB independientes | 38 s, 35 s, 34 s | 35 s, 34 s, 35 s | Inactivas |
| Suma de las tres | 107 s | 104 s | — |
benchmark_runner |
No estaba en el pipeline | 50 s, a la vez que las actividades independientes | 51 s |
| La cadena de Spark empieza tras la preparación | Unos 116 s después | Unos 110 s después | Unos 2 s después |
| PySpark, Spark SQL, PySpark NEE | 2m 36s, 3m 7s, 51s | 1m 5s, 2m 54s, 2m 52s | 1m 6s, 3m 8s, 2m 39s |
| Tiempo total real del pipeline (derivado) | Unos 9 min 38 s | Unos 11 min 5 s | Unos 7 min 54 s |
Las filas derivadas se calculan a partir de las horas de inicio y las duraciones en segundos enteros de la tabla de actividades, así que tienen una precisión de unos pocos segundos; no son duraciones del pipeline medidas por separado.
Qué significa el 51 % y qué no
Los 51 segundos del runner son alrededor de un 51 % menos que la suma de las duraciones de las tres actividades separadas (104 segundos). Es la única comparación que estas ejecuciones respaldan directamente, y tiene tres matices:
- No es una comparación del tiempo total real del pipeline. En el pipeline original, las tres actividades se ejecutaban una tras otra, así que su suma se acerca al tiempo que ocuparon (107 segundos desde el inicio de Pandas hasta el final de DuckDB en la ejecución B). Un pipeline que ejecutara las tres actividades en paralelo tardaría más o menos lo que la más lenta, no 104 segundos. No ejecutamos esa variante, así que no podemos decir que el runner la supere.
- No aísla la reutilización del runtime. Los notebooks hijos llamados con
runMultiple()se ejecutan dentro de la sesión del llamador y comparten su cómputo; Microsoft documenta que la API «usa una implementación multihilo dentro de una sesión de Spark, lo que significa que las ejecuciones de notebooks referenciados comparten recursos de cómputo». Arrancar una sesión de notebook en lugar de tres es la razón plausible de que el runner sea más corto, pero no registramos por separado el arranque de la sesión, la duración de cada hijo ni el solapamiento entre hijos, así que la parte del ahorro que viene de evitar arranques de sesión no está medida. - Compara ejecuciones distintas en condiciones distintas. Las duraciones independientes de la ejecución B se midieron mientras el runner también se estaba ejecutando, y el runner de la ejecución C se ejecutó a la vez que PySpark. Dos ejecuciones en una misma tarde no son una distribución.
El efecto a nivel de pipeline es más fácil de ver, y no es el 51 %. En las ejecuciones A y B, las actividades de Spark esperaron unos 110–116 segundos a la cadena de Python; en la ejecución C empezaron 2 segundos después de la preparación, porque los benchmarks de Python pasaron a una rama paralela. La duración combinada de las actividades de Spark fue similar en las tres ejecuciones (394, 411 y 413 segundos), así que el pipeline más corto de la última ejecución refleja sobre todo esa espera eliminada, no motores más rápidos. Las actividades de Spark individuales variaron mucho más que el runner: la actividad NEE tardó 51 segundos en una ejecución y más de 2,5 minutos en las otras dos.
Los tipos de cómputo del padre y de los hijos deben coincidir
El primer runner era un notebook de Spark. La validación de su DAG falló antes de que se ejecutara ningún hijo:
ChildNotebook compute type JupyterCompute does not match to main notebook compute type SparkComputeJupyterCompute es el notebook de Python (el hijo, nb_fabric_engine_python); SparkCompute es el notebook de Spark que lo llamaba. Un notebook referenciado se ejecuta en el cómputo del llamador, y Fabric comprueba que los tipos de cómputo del padre y del hijo coinciden antes de ejecutar nada. La solución fue convertir el runner en un notebook de Python, algo que Microsoft documenta como compatible: los notebooks de Python pueden ejecutar por referencia otros notebooks de Python con notebookutils.notebook.run() o runMultiple(). Llama antes a validateDAG() y este error aparecerá en un segundo, no después de una ejecución larga.
La regla se generaliza: agrupa los notebooks hijos por tipo de cómputo. Hijos de Python bajo un runner de Python, hijos de Spark bajo un runner de Spark (o como actividades de pipeline separadas). Por eso los motores de Spark de este pipeline se quedaron como actividades propias.
Cuándo ayuda la orquestación entre notebooks
- Muchos notebooks cortos en los que el arranque de la sesión es una parte grande de cada actividad, como las actividades de Python de 34–38 segundos de este caso, que hacían 2,5 segundos de trabajo.
- El mismo notebook ejecutado con parámetros distintos (un motor, una tabla, una fecha): un hijo parametrizado y un DAG de argumentos.
- Hijos con el mismo tipo de cómputo y el mismo lakehouse predeterminado. Una ejecución por referencia se bloquea si el hijo declara un lakehouse predeterminado distinto del del padre.
- Cuando una actividad de pipeline es la unidad adecuada de monitorización y reintento, con el runner lanzando un error si falló algún hijo.
Cuándo puede no ayudar
- Hijos de larga duración. Si cada hijo tarda veinte minutos, unos segundos de arranque de sesión son ruido, y pierdes la visibilidad por actividad en el pipeline a cambio de nada.
- Hijos que compiten por un mismo nodo. Los hijos comparten el cómputo del runner. En un notebook de Python de 2 vCores predeterminado, tres hijos que consumen mucha memoria a la vez pueden ser más lentos que tres actividades separadas, o quedarse sin memoria juntos.
- Tipos o tamaños de cómputo mezclados. Los hijos de Spark y de Python no pueden compartir un runner, y todos los hijos reciben el tamaño de nodo del runner.
- Control por actividad en el pipeline. Las actividades separadas dan a cada notebook su propia política de reintentos, tiempo de espera, condiciones de dependencia y estado en el centro de supervisión (Monitoring hub). Un runner traslada esa lógica a Python.
- Notebooks de Spark que podrían compartir sesión de otra forma. Para las actividades de Spark, el modo de alta concurrencia para pipelines y las session tags son el mecanismo documentado para compartir sesiones; no se usaron aquí y son otro experimento.
Cómo medir la diferencia
Para convertir esta observación en un resultado controlado, ejecuta el mismo pipeline con cada diseño, con el mismo conjunto de datos y la misma capacidad:
- Variantes: actividades separadas en secuencia, actividades separadas en paralelo y un runner con
concurrency: 1(y, por separado, conconcurrencysin restringir). - Ejecuciones: al menos cinco por variante, alternando el orden de las variantes para repartir por igual los efectos de la hora del día.
- Registra tres cifras por ejecución: la duración de cada actividad en la pestaña Output, el tiempo total real del pipeline y, dentro del runner, la duración de cada hijo (cronometra cada actividad de
runMultipleo haz que cada hijo devuelva sus tiempos connotebookutils.notebook.exit()). - Registra el arranque de la sesión de cada variante en el Monitoring hub, para que la reutilización de sesiones se mida en lugar de deducirse.
- Compara medianas con mínimo y máximo, por métrica. No combines nunca el tiempo de actividad, el tiempo total real y el tiempo de procesamiento del motor en una sola puntuación.
La guía de arranque de notebooks explica cómo separar el tiempo de cola, de sesión y de ejecución, y la monitorización de pipelines y notebooks de Fabric cubre dónde se informa de cada duración. Para pasar argumentos como engine, consulta parámetros de notebooks en Fabric; para el equilibrio más general, pipelines frente a notebooks en Fabric.
Haz este benchmark en tu propia capacidad de Fabric
Las franjas de Microsoft te dicen dónde mirar. Tus propias cifras te dicen qué elegir. El método siguiente compara Polars, DuckDB y pandas en un notebook de Python con PySpark y Spark SQL en un notebook de Spark, sobre los mismos archivos y la misma carga de trabajo.
Qué probar
Genera (o copia) la misma entrada en varios tamaños, por ejemplo ~100 MB, ~1 GB y ~10 GB comprimidos, y más grandes si tu capacidad lo permite. Ejecuta un pipeline realista, no una sola operación:
- leer Parquet;
- filtrar;
- hacer un join con una dimensión;
- agrupar y agregar;
- ordenar;
- escribir el resultado.
No hagas un benchmark solo de un count(): Spark puede responder algunos recuentos a partir de los metadatos, Polars y DuckDB pueden saltarse la mayor parte de los datos, y nada de eso dice nada sobre joins o escrituras.
Qué registrar
- Tiempo de arranque de la sesión, por separado de la ejecución (barra de estado del notebook o Monitoring hub).
- Tiempo de ejecución de todo el pipeline, incluida la escritura.
- Memoria máxima del proceso en los motores de un solo nodo; memoria de los executors y spill en Spark (consulta las advertencias más abajo).
- Salida: número de archivos y un checksum (número de filas y totales) que demuestre que todos los motores produjeron el mismo resultado.
- Éxito, error u OOM, por ejecución.
- Repetibilidad: al menos cinco ejecuciones por motor y tamaño, publicadas como la mediana con mínimo y máximo.
- Duración de la actividad y tiempo total real del pipeline, por separado del tiempo de procesamiento del motor, si el benchmark se ejecuta en un pipeline.
- Entorno: SKU de la capacidad, vCores del notebook de Python o pool y tamaño de nodo de Spark, runtime de Spark, si el NEE estaba habilitado, versiones de las bibliotecas, formato de origen y tamaño de entrada comprimida.
Reglas para un benchmark justo
- Los mismos archivos de origen, las mismas columnas y filtros, la misma semántica de salida, verificada con un checksum.
- Separa la primera ejecución de una sesión de las siguientes; las cachés (la de DuckDB, la caché inteligente de Spark, la del sistema operativo) favorecen las lecturas repetidas, y una lectura realmente en frío es difícil de garantizar.
- Da a los motores núcleos comparables cuando puedas: un notebook de Python de 2 vCores frente a un nodo de Spark de 8 vCores compara hardware, no motores. Repite con el notebook de Python a 8 vCores (
%%configure). - Mide el arranque por separado de la ejecución.
- Ejecuta cada caso varias veces y publica la mediana, conservando todas las ejecuciones. No elijas a dedo la ejecución más rápida.
- Incluye pandas solo en los tamaños que pueda aguantar, y no hagas nunca un benchmark tumbando a propósito una capacidad compartida.
Harness para notebooks de Python: Polars, DuckDB, pandas
Ejecuta esto en un notebook de Python con un lakehouse predeterminado adjunto. Genera pedidos y clientes sintéticos con DuckDB y después ejecuta la misma carga de trabajo cinco veces por motor, muestreando la memoria máxima del proceso y escribiendo una línea JSON por ejecución. pandas se omite por encima de PANDAS_MAX_BYTES, así que el benchmark nunca agota la memoria a propósito. Aumenta ORDER_ROWS y cambia SIZE_LABEL para cada tamaño, y registra el tamaño comprimido que imprime en lugar del número de filas. Las API de las bibliotecas cambian entre versiones (DuckDB 2.0 eliminó fetchone() de las relaciones, por ejemplo), y por eso el harness registra las versiones y se limita a llamadas consolidadas.
# Fabric Python notebook (pure Python kernel), default lakehouse attached.
# Cell 1: configuration and synthetic data. Same files are read by every engine.
import json, os, platform, statistics, threading, time
from datetime import date

BASE = os.environ.get("BENCH_BASE", "/lakehouse/default/Files/engine-bench")
SIZE_LABEL = "s1"                 # one folder per dataset size: s1, s2, s3 ...
ORDER_ROWS = 2_000_000            # raise step by step: compressed size is what you report
CUSTOMERS = 200_000
RUNS = 5                          # report the median, keep every run
ENGINES = ["polars", "duckdb", "pandas"]  # one engine per fresh kernel gives clean peak-memory numbers
PANDAS_MAX_BYTES = 500 * 1024**2  # skip pandas above this compressed input size
DATA = f"{BASE}/data/{SIZE_LABEL}"
RESULTS = f"{BASE}/results/results.jsonl"

import duckdb

def generate():
    os.makedirs(DATA, exist_ok=True)
    con = duckdb.connect()
    con.execute(f"""
        COPY (SELECT i AS order_id,
                     (hash(i) % {CUSTOMERS})::INTEGER AS customer_id,
                     DATE '2024-01-01' + (hash(i * 7) % 730)::INTEGER AS order_date,
                     ['open', 'shipped', 'cancelled', 'returned'][1 + (hash(i * 13) % 4)::INTEGER] AS status,
                     round((hash(i * 31) % 100000) / 100.0, 2) AS amount
              FROM range({ORDER_ROWS}) t(i))
        TO '{DATA}/orders' (FORMAT parquet, PER_THREAD_OUTPUT true, OVERWRITE_OR_IGNORE true)""")
    con.execute(f"""
        COPY (SELECT i::INTEGER AS customer_id,
                     ['north', 'south', 'east', 'west'][1 + (i % 4)::INTEGER] AS region,
                     ['retail', 'smb', 'enterprise'][1 + (i % 3)::INTEGER] AS segment
              FROM range({CUSTOMERS}) t(i))
        TO '{DATA}/customers' (FORMAT parquet, PER_THREAD_OUTPUT true, OVERWRITE_OR_IGNORE true)""")

def folder_bytes(path):
    return sum(os.path.getsize(os.path.join(root, f)) for root, _, files in os.walk(path) for f in files)

if not os.path.exists(f"{DATA}/orders"):
    generate()
INPUT_BYTES = folder_bytes(f"{DATA}/orders") + folder_bytes(f"{DATA}/customers")
print(f"compressed input: {INPUT_BYTES / 1024**2:.1f} MB")

# Cell 2: one workload, three engines. Filter, join, aggregate by month, sort, write Parquet.
SINCE = date(2025, 1, 1)
STATUSES = ["shipped", "returned"]

def run_polars(out):
    import polars as pl
    orders = pl.scan_parquet(f"{DATA}/orders/*.parquet")
    customers = pl.scan_parquet(f"{DATA}/customers/*.parquet")
    result = (orders.filter(pl.col("status").is_in(STATUSES) & (pl.col("order_date") >= SINCE))
              .join(customers, on="customer_id", how="inner")
              .group_by("region", "segment", pl.col("order_date").dt.truncate("1mo").alias("order_month"))
              .agg(pl.col("amount").sum().alias("revenue"), pl.len().alias("orders"))
              .sort("region", "segment", "order_month")
              .collect())
    result.write_parquet(f"{out}/part-0.parquet")

def run_duckdb(out):
    con = duckdb.connect()
    con.execute(f"""
        COPY (SELECT c.region, c.segment, date_trunc('month', o.order_date) AS order_month,
                     sum(o.amount) AS revenue, count(*) AS orders
              FROM read_parquet('{DATA}/orders/*.parquet') o
              JOIN read_parquet('{DATA}/customers/*.parquet') c USING (customer_id)
              WHERE o.status IN ('shipped', 'returned') AND o.order_date >= DATE '{SINCE}'
              GROUP BY ALL ORDER BY region, segment, order_month)
        TO '{out}/part-0.parquet' (FORMAT parquet)""")

def run_pandas(out):
    import pandas as pd
    orders = pd.read_parquet(f"{DATA}/orders")
    orders["order_date"] = pd.to_datetime(orders["order_date"])
    orders = orders[orders["status"].isin(STATUSES) & (orders["order_date"] >= pd.Timestamp(SINCE))]
    joined = orders.merge(pd.read_parquet(f"{DATA}/customers"), on="customer_id", how="inner")
    joined["order_month"] = joined["order_date"].dt.to_period("M").dt.to_timestamp()
    result = (joined.groupby(["region", "segment", "order_month"], as_index=False)
              .agg(revenue=("amount", "sum"), orders=("amount", "size"))
              .sort_values(["region", "segment", "order_month"]))
    result.to_parquet(f"{out}/part-0.parquet", index=False)

# Cell 3: harness. Wall time, peak process memory (RSS, sampled), output files, a checksum, success or error.
def peak_rss(fn):
    try:
        import psutil
    except ImportError:
        return fn(), None
    proc, peak, done = psutil.Process(), [0], threading.Event()
    def sample():
        while not done.is_set():
            peak[0] = max(peak[0], proc.memory_info().rss)
            time.sleep(0.05)
    sampler = threading.Thread(target=sample, daemon=True)
    sampler.start()
    try:
        return fn(), peak[0]
    finally:
        done.set()
        sampler.join()

def checksum(out):
    row = duckdb.connect().execute(f"SELECT count(*), round(sum(revenue), 2), sum(orders) FROM read_parquet('{out}/*.parquet')").fetchone()
    return {"rows": row[0], "revenue": float(row[1]), "orders": int(row[2])}

def versions():
    import importlib.metadata as md
    found = {}
    for name in ("pandas", "polars", "duckdb", "pyarrow", "deltalake"):
        try:
            found[name] = md.version(name)
        except md.PackageNotFoundError:
            found[name] = None
    return found

def bench(engine, fn):
    if engine == "pandas" and INPUT_BYTES > PANDAS_MAX_BYTES:
        return [{"engine": engine, "status": "skipped", "reason": "input above PANDAS_MAX_BYTES"}]
    runs = []
    for run in range(1, RUNS + 1):
        out = f"{BASE}/out/{SIZE_LABEL}/{engine}/run{run}"
        os.makedirs(out, exist_ok=True)
        for f in os.listdir(out):
            os.remove(os.path.join(out, f))
        start = time.perf_counter()
        try:
            _, rss = peak_rss(lambda: fn(out))
            record = {"status": "ok", "seconds": round(time.perf_counter() - start, 3),
                      "peak_rss_mb": rss and round(rss / 1024**2), "files": len(os.listdir(out)), **checksum(out)}
        except MemoryError as error:
            record = {"status": "oom", "error": repr(error)[:200]}
        except Exception as error:
            record = {"status": "error", "error": repr(error)[:200]}
        runs.append({"engine": engine, "run": run, **record})
    return runs

env = {"kernel": "python", "python": platform.python_version(), "vcores": os.cpu_count(),
       "size": SIZE_LABEL, "input_mb": round(INPUT_BYTES / 1024**2, 1), "libraries": versions()}
os.makedirs(os.path.dirname(RESULTS), exist_ok=True)
with open(RESULTS, "a") as log:
    for engine in ENGINES:
        records = bench(engine, {"polars": run_polars, "duckdb": run_duckdb, "pandas": run_pandas}[engine])
        for record in records:
            log.write(json.dumps({**env, **record}) + "\n")
        ok = [r["seconds"] for r in records if r["status"] == "ok"]
print(engine, "median s:", statistics.median(ok) if ok else None, [r["status"] for r in records])Harness para notebooks de Spark: PySpark y Spark SQL
Ejecuta esto en un notebook de Spark adjunto al mismo lakehouse, con el mismo SIZE_LABEL. Ejecútalo una vez con el Native Execution Engine habilitado y otra sin él si quieres ver su efecto en tu carga de trabajo.
# Fabric Spark notebook (PySpark kernel), same default lakehouse, same SIZE_LABEL as the Python run.
# Record the session start time separately (notebook status bar or Monitoring hub): it is not part of `seconds`.
import json, os, statistics, time
from pyspark.sql import functions as F

BASE = os.environ.get("BENCH_BASE", "/lakehouse/default/Files/engine-bench")  # local mount, for result files
SPARK_BASE = os.environ.get("BENCH_SPARK_BASE", "Files/engine-bench")          # same folder, as Spark sees it
SIZE_LABEL = "s1"
RUNS = 5
DATA = f"{SPARK_BASE}/data/{SIZE_LABEL}"

def run_dataframe(out):
    orders = spark.read.parquet(f"{DATA}/orders")
    customers = spark.read.parquet(f"{DATA}/customers")
    result = (orders.where(F.col("status").isin("shipped", "returned") & (F.col("order_date") >= F.lit("2025-01-01").cast("date")))
              .join(customers, "customer_id")
              .groupBy("region", "segment", F.trunc("order_date", "month").alias("order_month"))
              .agg(F.sum("amount").alias("revenue"), F.count(F.lit(1)).alias("orders"))
              .orderBy("region", "segment", "order_month"))
    result.write.mode("overwrite").parquet(out)

def run_sql(out):
    spark.read.parquet(f"{DATA}/orders").createOrReplaceTempView("orders")
    spark.read.parquet(f"{DATA}/customers").createOrReplaceTempView("customers")
    spark.sql("""
        SELECT c.region, c.segment, trunc(o.order_date, 'month') AS order_month,
               sum(o.amount) AS revenue, count(*) AS orders
        FROM orders o JOIN customers c USING (customer_id)
        WHERE o.status IN ('shipped', 'returned') AND o.order_date >= DATE '2025-01-01'
        GROUP BY ALL ORDER BY region, segment, order_month
    """).write.mode("overwrite").parquet(out)

def checksum(out):
    row = spark.read.parquet(out).agg(F.count(F.lit(1)), F.round(F.sum("revenue"), 2), F.sum("orders")).first()
    return {"rows": row[0], "revenue": float(row[1]), "orders": int(row[2])}

env = {"kernel": "spark", "spark": spark.version, "size": SIZE_LABEL,
       "native_engine": spark.conf.get("spark.native.enabled", "unset"),
       "default_parallelism": spark.sparkContext.defaultParallelism}
os.makedirs(f"{BASE}/results", exist_ok=True)
with open(f"{BASE}/results/results.jsonl", "a") as log:
    for engine, fn in (("pyspark", run_dataframe), ("spark-sql", run_sql)):
        records = []
        for run in range(1, RUNS + 1):
            out = f"{SPARK_BASE}/out/{SIZE_LABEL}/{engine}/run{run}"
            start = time.perf_counter()
            try:
                fn(out)
                record = {"status": "ok", "seconds": round(time.perf_counter() - start, 3),
                          "files": len([f for f in os.listdir(f"{BASE}/out/{SIZE_LABEL}/{engine}/run{run}") if f.endswith(".parquet")]),
                          **checksum(out)}
            except Exception as error:  # executor OOM surfaces as a failed job, not a MemoryError
                record = {"status": "error", "error": repr(error)[:200]}
            records.append({"engine": engine, "run": run, **record})
            log.write(json.dumps({**env, **records[-1]}) + "\n")
        ok = [r["seconds"] for r in records if r["status"] == "ok"]
        print(engine, "median s:", statistics.median(ok) if ok else None, [r["status"] for r in records])
# Memory: read peak executor memory and spill from the Spark UI (Executors and Stages tabs), not from the driver.Los dos harnesses añaden sus resultados a Files/engine-bench/results/results.jsonl, así que una sola consulta de DuckDB lo compara todo:
import duckdb

duckdb.sql("""
    SELECT size, engine, count(*) FILTER (status = 'ok') AS ok_runs,
           median(seconds) AS median_seconds, max(peak_rss_mb) AS peak_rss_mb,
           any_value(rows) AS rows, any_value(revenue) AS revenue
    FROM read_json_auto('/lakehouse/default/Files/engine-bench/results/results.jsonl')
    GROUP BY ALL ORDER BY size, median_seconds
""").show()Que rows y revenue coincidan entre motores es la prueba de que comparaste el mismo trabajo.
Antes de publicar, ejecuté el harness de Python fuera de Fabric con Python 3.12 y datos sintéticos pequeños (unos 28 MB comprimidos): Polars, DuckDB y pandas produjeron el mismo número de filas y los mismos checksums, el límite de tamaño de pandas omitió la ejecución correctamente y la consulta de resumen anterior funcionó sobre los resultados. El harness de Spark se compiló y se revisó, pero no se ejecutó fuera de Fabric. Fueron comprobaciones de corrección, no resultados de rendimiento; los tiempos de un portátil no dicen nada de una capacidad de Fabric, así que no los publico.
Incluso en esa prueba pequeña aparecieron dos efectos que también verás en Fabric:
- La primera ejecución es más lenta. Los imports, los metadatos de los archivos y las cachés hacen que la ejecución 1 sea una ejecución en frío. Consérvala, pero no compares la ejecución en frío de un motor con la ejecución en caliente de otro.
- La memoria máxima se acumula en un mismo proceso. El muestreador de RSS mide todo el proceso del notebook, así que un motor que se ejecuta después de otro hereda lo que el primero dejó asignado. Para obtener cifras de memoria limpias, pon un solo motor en
ENGINESy reinicia el kernel entre motores (notebookutils.session.restartPython()).
Advertencias sobre la medición de memoria
La memoria de un proceso de Python es fácil de observar: el harness muestrea la memoria residente (RSS) del proceso del notebook, que incluye la memoria que Polars y DuckDB asignan de forma nativa. Es un pico razonable para un solo nodo, aunque el muestreo puede perder picos muy breves.
La memoria de Spark no es una sola cifra. Está en el driver, en el heap de la JVM de cada executor, fuera del heap y en la memoria nativa que usa el Native Execution Engine, y en los archivos de shuffle y spill en disco. No presentes el RSS del driver como el uso de memoria de Spark; mide el único proceso que menos trabaja. Usa en su lugar la Spark UI: la pestaña Executors para la memoria máxima por executor, y la pestaña Stages para el spill (memoria y disco) y la lectura y escritura de shuffle. Compara si cada motor se mantuvo dentro de sus límites y cuánto se acercó a ellos, en lugar de poner uno al lado del otro un RSS de un solo nodo y un total de clúster como si fueran la misma medida.
Antipatrones
- Elegir pandas solo porque el equipo conoce pandas. La familiaridad es un factor de coste real, no un modelo de ejecución.
- Elegir Spark solo porque los datos están en un Lakehouse. Los datos pequeños y estables se leen perfectamente desde un notebook de Python.
- Llamar a
toPandas()demasiado pronto. Reduce antes en Spark. - Comparar el tiempo de ejecución e ignorar el arranque, o comparar el arranque e ignorar la ejecución.
- Ignorar la memoria. El motor que es un 20 % más rápido y se queda sin memoria con el doble de datos no es más rápido.
- Hacer el benchmark de una sola operación, sobre todo de un
count(). - Elegir una arquitectura de producción a partir de una muestra minúscula.
- Ignorar el crecimiento. Los 700 MB de hoy son un dato puntual, no un tamaño.
- Ignorar los requisitos de funcionalidades Delta, hasta que un motor de Python se encuentra con una tabla con deletion vectors.
- Ignorar el soporte técnico. Ten claro a quién llamarás cuando el motor se comporte mal.
- Suponer que la lectura más rápida es el pipeline más rápido. Los joins y las escrituras deciden la mayoría de las ejecuciones.
- Suponer que un solo nodo es más barato. El coste son los recursos multiplicados por el tiempo, incluidas las repeticiones.
- Suponer que Spark escala automáticamente. El sesgo, las particiones demasiado grandes, los broadcasts y los collect al driver siguen fallando; consulta la resolución de problemas de rendimiento en Fabric.
Matriz de recomendaciones
Guía de Javi Builds: haz un benchmark de tu carga de trabajo.
| Situación | Punto de partida recomendado |
|---|---|
| Datos exploratorios de 100 MB | Polars o DuckDB |
| DataFrame pequeño que necesita el ecosistema de Python | pandas |
| Notebook analítico de 1–2 GB | Polars o DuckDB; haz benchmark de Spark en un solo nodo si se convierte en un pipeline |
| Transformación de producción de 10 GB | Haz benchmark de un solo nodo frente a Spark; inclínate por Spark si se espera crecimiento |
| ETL de 100 GB o más | PySpark o Spark SQL con el Native Execution Engine |
| Carga Delta grande (MERGE, UPDATE, DELETE, mantenimiento) | Spark |
| Joins grandes | Spark |
| Exploración de archivos con SQL | DuckDB |
| Trabajo rápido con DataFrames en un solo nodo | Polars |
| Resultado pequeño tras una agregación en Spark | pandas |
| Equipo experto en pandas, con datos que superan un nodo | API de pandas en Spark, y después PySpark nativo para las rutas críticas |
Relacionado en Javi Builds
- Microsoft Fabric Runtime 2.0 vs 1.3 vs 1.2: las versiones del runtime de Spark, el Native Execution Engine y los riesgos de migración.
- Cómo acelerar los notebooks de Microsoft Fabric: diagnosticar notebooks de Spark lentos.
- Reducir el tiempo de inicio de los notebooks de Fabric: tiempo de cola, de sesión y de ejecución.
- Cómo usar session tags en pipelines de Fabric: el mecanismo para compartir sesiones de Spark que este experimento no usó.
- Parámetros de notebooks en Fabric y monitorización de pipelines y notebooks de Fabric.
- Alta concurrencia en Microsoft Fabric: compartir sesiones de Spark entre notebooks.
- La capacidad de Microsoft Fabric explicada: CU, suavizado y limitación.
- Patrones de rendimiento de MERGE en Delta Lake y mantenimiento de tablas Delta.
- Checklist de rendimiento de notebooks de Fabric (en inglés).
- El hub de ingeniería de datos y la ruta de aprendizaje de Microsoft Fabric.
Fuentes
Microsoft Learn, consultado en noviembre de 2026:
- Choosing a notebook kernel in Microsoft Fabric: opciones de cómputo y CU, franjas de benchmark, matriz de funcionalidades Delta Lake (a junio de 2026), madurez y soporte de los motores, guía de decisión.
- Use Python experience on Notebook: kernels, cómputo predeterminado, bibliotecas preinstaladas, delta-rs y DuckDB, consejo ante OOM,
%%configure, ejecuciones por referencia entre notebooks de Python, tiempo de arranque del live pool. - Python notebook runtime and kernel lifecycle: versiones de kernel y fechas de fin de soporte.
- Apache Spark runtime in Fabric y Runtime 2.0: runtime GA, versiones de componentes, el benchmark TPC-DS del Native Execution Engine.
- Native execution engine for Fabric Data Engineering: Velox y Gluten, habilitación, fallback, limitaciones.
- Read and write data with pandas: rutas del Lakehouse y guía sobre
toPandas(). - Load data into your lakehouse with a notebook: rutas relativas, ABFS y
/lakehouse/default/que usa el benchmark. - Intelligent cache in Microsoft Fabric: por qué las lecturas posteriores de los mismos archivos en Spark son más rápidas.
- NotebookUtils notebook run and orchestration:
run(),runMultiple(), campos y valores predeterminados del DAG (concurrencia, tiempo de espera por celda), cómputo compartido, la regla del lakehouse predeterminado. - Configure high concurrency mode for notebooks in pipelines: session tags y sesiones de Spark compartidas, que este experimento no usó.
Datos del benchmark:
- NYC TLC Trip Record Data: archivos Parquet mensuales de los taxis amarillos y la tabla de zonas de taxi.
- Yellow Taxi trip records data dictionary.
Documentación de los proyectos:
- Apache Spark SQL performance tuning: umbral de broadcast, ejecución adaptativa de consultas, joins con sesgo.
- Polars streaming engine.
- DuckDB: tuning workloads, procesamiento mayor que la memoria y spill.
- pandas API on Spark.
¿Te resultó útil este contenido?
¿Qué podríamos mejorar?
Gracias — esto me ayuda a mejorar Javi Builds.
Sigue aprendiendo
- Guía rápidaRendimiento de los notebooks de FabricDiagnostica y mejora el rendimiento de los notebooks de Microsoft Fabric separando los cuellos de botella del inicio de la sesión Spark, la lectura de datos, el shuffle, el skew, la presión sobre el driver, la concurrencia y la escritura.Abrir guía rápida
- Hoja de rutaFabric Performance at ScaleCompara pandas, Polars, DuckDB, PySpark y Spark SQL en Microsoft Fabric por velocidad, uso de memoria, tamaño de datos, soporte de Delta y escala, con resultados medidos en un benchmark real en Fabric y una guía práctica para elegir el motor adecuado.Ver hoja de ruta
¿Qué debería crear después?
Estoy construyendo Javi Builds alrededor de problemas reales que enfrentan los ingenieros de datos. Dime qué tema te gustaría ver después.
Mantente al día
Recibe solo las novedades de Javi Builds que realmente te interesan.
Revisa tu bandeja de entrada
Te he enviado un enlace de confirmación. Tu suscripción se activará cuando la confirmes.