Microsoft Fabric
Cómo usar session tags en pipelines de Fabric
Usa los session tags de los pipelines de Microsoft Fabric para agrupar actividades de notebook compatibles, reutilizar sesiones Spark y mantener los límites entre cargas.
En este artículo
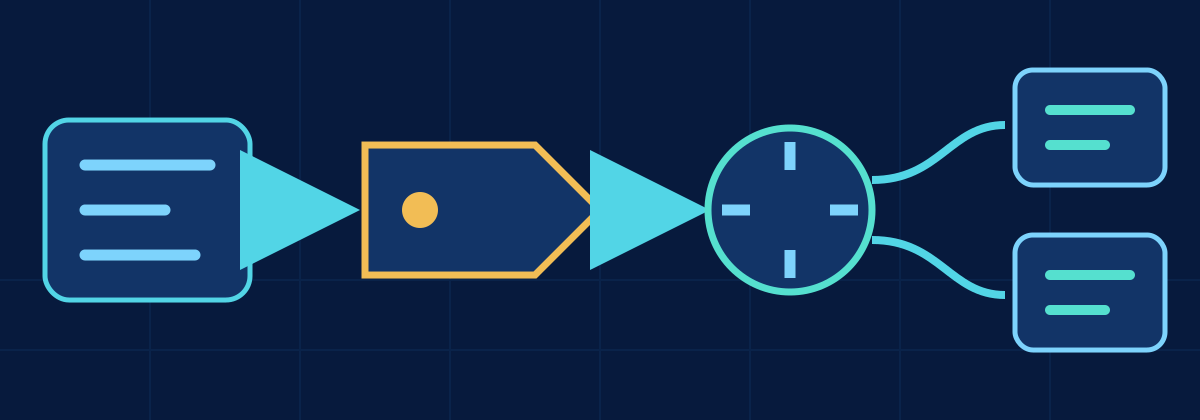
Respuesta corta: un session tag le indica a un pipeline de Fabric qué actividades de notebook pueden compartir una misma sesión de Spark en alta concurrencia. Las actividades con el mismo tag, ejecutadas por el mismo usuario con la misma área de trabajo, el mismo Lakehouse predeterminado, la misma configuración de cómputo y las mismas bibliotecas, pueden unirse a una sesión ya en curso en lugar de iniciar cada una la suya. Así se evitan inicios repetidos y, como solo se factura la actividad que inicia la sesión compartida, se puede reducir el coste. Usa un mismo tag para notebooks cortos, relacionados y compatibles; da su propio tag al trabajo con mucha memoria o sensible al aislamiento.
- Actividad de notebookUno de varios notebooks de un pipeline
- compatibleTag compartidoMismo usuario, Lakehouse, cómputo y bibliotecas; pasos cortos
- pesadoTag propioGrandes shuffles o cachés, necesidad de aislamiento estricto
- incompatibleSin posibilidad de compartirEntorno, Lakehouse o identidad distintos
Problema
Un pipeline ejecuta varios notebooks dentro del mismo flujo operativo. Cada notebook es correcto por sí solo, pero los inicios repetidos hacen que la duración de extremo a extremo sea irregular. Quieres reutilizar sesiones sin mezclar cargas que no tienen relación y sin suponer que un texto coincidente anula las reglas de compatibilidad y aislamiento.
Qué hace un session tag y qué no hace
En alta concurrencia, una aplicación de Spark aloja varios notebooks, cada uno en su propio núcleo REPL, de modo que las variables locales de un notebook no sobrescriben las de otro. Los ejecutores se comparten y se reparten entre esos núcleos REPL con planificación FAIR.
Un session tag:
- agrupa las actividades de notebook de un pipeline como candidatas a la misma sesión compartida;
- evita inicios repetidos para cada actividad que se une a una sesión ya en curso;
- cambia la facturación: solo se factura la actividad que inicia la sesión compartida.
Un session tag no:
- anula la compatibilidad. Compartir exige el mismo usuario, área de trabajo, Lakehouse predeterminado, configuración de cómputo de Spark y paquetes de bibliotecas. Si no, Fabric inicia otra sesión.
- funciona por sí solo. Un administrador del área de trabajo debe habilitar For pipeline running multiple notebooks en la configuración de alta concurrencia.
- garantiza una sola sesión. Por defecto, hasta cinco notebooks comparten una sesión; el límite es configurable hasta 50 (en inglés). Las reglas de capacidad y de agrupación pueden crear sesiones adicionales.
- comparte estado. Las variables están aisladas por notebook; los datos deben pasar por tablas, archivos o parámetros.
Recomendaciones prácticas
Elige un tag que represente un grupo de compatibilidad de ejecución, no solo una etiqueta de negocio. Los notebooks de un pipeline diario de ventas pueden ir juntos si usan el mismo Lakehouse, entorno, configuración de Spark, límite de identidad y una programación que se solapa. Una transformación financiera y un notebook experimental de machine learning no deberían compartir tag solo porque ambos se ejecutan en el mismo workspace.
Construye los tags de forma determinista. Un valor estable como sales-daily-standard convierte a las actividades relacionadas en candidatas para reutilizar la sesión dentro de la ventana prevista. Añadir un identificador de ejecución único a cada tag impide la reutilización entre actividades, porque cada una presenta un valor distinto. Por el contrario, usar un único tag global para todos los pipelines crea un grupo demasiado amplio y hace que el comportamiento sea más difícil de entender.
Separa de forma deliberada las cargas incompatibles. Un notebook con requisitos de cómputo, bibliotecas o Lakehouse predeterminado distintos debe usar otro grupo aunque forme parte del mismo proceso de negocio. Para trabajos que consumen mucha memoria o que son sensibles a la latencia, el aislamiento puede ser más importante que el tiempo de inicio.
Mide en ambos niveles. Registra la duración de la actividad del pipeline y la de cada etapa del notebook. En alta concurrencia, el monitoreo ofrece vistas por notebook y logs separados, que son imprescindibles cuando varios notebooks comparten la aplicación subyacente. Una sesión compartida puede mejorar la adquisición mientras el trabajo de Spark dentro de ella sigue siendo lento o compite por recursos. Monitoreo de pipelines y notebooks de Microsoft Fabric explica cómo separar esos tiempos.
Ejemplo: Validar → Transformar → Fusionar → Resumir
Un pipeline diario de ventas ejecuta cuatro notebooks en secuencia. Validar comprueba la llegada y el esquema de los archivos; Transformar limpia y conforma los datos Silver; Fusionar hace un upsert en una tabla Delta Gold grande; Resumir genera pequeños agregados para reporting. Los cuatro usan el mismo Lakehouse y el mismo entorno.
| Escenario | ¿Reutilizar la sesión? | Por qué |
|---|---|---|
| Validar, Transformar y Resumir: cortos, secuenciales, mismos ajustes | Sí, un tag como sales-daily-standard |
Si no, cada uno pagaría el inicio de sesión; usan poca memoria |
| Fusionar reescribe un destino grande con un shuffle pesado | Normalmente un tag aparte | Comparte ejecutores con todos los notebooks de la sesión; el desbordamiento y la contención los ralentizan a todos |
| Un paso necesita bibliotecas de otro entorno | No, otro tag | Las bibliotecas distintas impiden compartir de todos modos; un tag común solo confunde |
| Los pasos se ejecutan en paralelo y almacenan en caché DataFrames grandes | Probar antes de compartir | La memoria y los ejecutores se comparten aunque las variables no |
| Un paso debe ejecutarse con otra identidad u otro Lakehouse predeterminado | No | Compartir exige el mismo usuario y el mismo Lakehouse predeterminado |
| Los pasos necesitan intercambiar datos | No es una decisión de tag | Pasa los datos por tablas o parámetros, nunca por la memoria de la sesión |
Pasa un identificador de correlación del pipeline como parámetro del notebook en lugar de incluirlo en el session tag. Así el grupo de reutilización se mantiene estable y los logs siguen siendo trazables.
# Parameter cell values supplied by the pipeline
pipeline_run_id = ""
processing_date = ""

print({
    "pipeline_run_id": pipeline_run_id,
    "processing_date": processing_date,
    "stage": "build_silver_orders",
})Precauciones operativas
- Entornos incompatibles. Dos notebooks con el mismo tag pero distinto entorno o Lakehouse predeterminado no compartirán sesión; el tag oculta entonces la agrupación real. Mantén un tag por combinación de entorno y Lakehouse.
- Presión de memoria. Los ejecutores de una sesión atienden a todos sus notebooks. Un merge grande, un join amplio o una caché pueden provocar desbordamiento en los demás. Mide la duración de las etapas y el desbordamiento por notebook antes y después de agrupar.
- Suposiciones sobre el estado compartido. Dos errores opuestos: depender de las variables de otro notebook (están aisladas) y suponer que no se comparte nada (el cómputo, la memoria y el disco sí).
- Sesiones de larga duración. Una sesión compartida sigue activa mientras se le unen actividades, y un notebook largo la retiene para todos. Revisa el límite de la sesión cuando se ejecutan muchas actividades a la vez, y cuenta con una sesión nueva (y su inicio) cuando termine la anterior.
- Depuración. La supervisión muestra la aplicación de Spark compartida y vistas por notebook; confirma qué actividades se unieron realmente antes de atribuir una mejora al tag. Una convención de nombres como
<dominio>-<cadencia>-<perfil>(sales-daily-standard,sales-daily-heavy) hace legible la agrupación en el historial de ejecuciones.
Errores comunes
- Configurar un tag sin habilitar la opción de alta concurrencia para pipelines en el workspace.
- Suponer que tags idénticos pueden anular diferencias de Lakehouse, configuración de cómputo, bibliotecas o límites de usuario.
- Incluir un ID de ejecución único en el tag de cada actividad y desactivar así la reutilización sin darse cuenta.
- Asignar un único tag a todos los notebooks del workspace.
- Depender de las variables en memoria o de la caché de otro notebook como interfaz del pipeline.
- Combinar actividades concurrentes que consumen muchos recursos sin medir la contención.
- Fijarse solo en la duración de extremo a extremo sin separar la adquisición de sesión del trabajo de Spark.
- Suponer que un tag siempre corresponde a una sola sesión física; la capacidad y las reglas de agrupación de la plataforma pueden crear sesiones adicionales.
Qué revisar después
Confirma la opción de alta concurrencia del workspace y, después, revisa en cada actividad el Lakehouse predeterminado, el entorno, la configuración de cómputo, las bibliotecas, la identidad y el tag. En el monitoreo, verifica qué sesiones y trabajos de notebook se crearon y si las actividades previstas quedaron asociadas a la ejecución compartida.
Si no hay reutilización, considera la compatibilidad como primera hipótesis. Si hay reutilización pero el pipeline sigue siendo lento, examina la concurrencia, las etapas de Spark, el shuffle, la E/S y las escrituras; Cómo acelerar los notebooks de Microsoft Fabric cubre ese diagnóstico. Si la fiabilidad empeora con la ejecución compartida, reduce el grupo o aísla la carga en conflicto. La estrategia de sesión correcta depende de la compatibilidad de las cargas, de su comportamiento de recursos y de la claridad operativa, no de maximizar la reutilización a cualquier costo. Para otras causas de un inicio lento, consulta Reducir el tiempo de inicio de los notebooks de Fabric.
Relacionado
- Aumentar el límite de sesiones en alta concurrencia (en inglés)
- Reducir el tiempo de inicio de los notebooks de Fabric
- Acelerar los notebooks de Microsoft Fabric
Fuentes
- Microsoft Learn: modo de alta concurrencia de Apache Spark en Fabric (aislamiento REPL, planificación, facturación, límite de sesión), configurar la alta concurrencia para notebooks en pipelines (condiciones para compartir, configuración del área de trabajo, session tags)
Revisado en Microsoft Learn en noviembre de 2026. La página de pipelines todavía menciona un máximo de cinco notebooks; la información general documenta el límite configurable.
¿Te resultó útil este contenido?
¿Qué podríamos mejorar?
Gracias — esto me ayuda a mejorar Javi Builds.
Sigue aprendiendo
- Guía rápidaRendimiento de los notebooks de FabricDiagnostica y mejora el rendimiento de los notebooks de Microsoft Fabric separando los cuellos de botella del inicio de la sesión Spark, la lectura de datos, el shuffle, el skew, la presión sobre el driver, la concurrencia y la escritura.Abrir guía rápida
- Hoja de rutaMicrosoft Fabric Notebook PerformanceUsa los session tags de los pipelines de Microsoft Fabric para agrupar actividades de notebook compatibles, reutilizar sesiones Spark y mantener los límites entre cargas.Ver hoja de ruta
¿Qué debería crear después?
Estoy construyendo Javi Builds alrededor de problemas reales que enfrentan los ingenieros de datos. Dime qué tema te gustaría ver después.