Microsoft Fabric
Pandas vs Polars vs DuckDB vs PySpark dans Microsoft Fabric : vitesse, mémoire et montée en charge
Comparez pandas, Polars, DuckDB, PySpark et Spark SQL dans Microsoft Fabric selon la vitesse, la mémoire, le volume de données, la prise en charge de Delta et la montée en charge, avec les résultats mesurés d'un vrai benchmark dans Fabric et des conseils pratiques pour choisir le bon moteur.
Dans cet article
Microsoft Fabric propose deux types de notebook et au moins cinq façons de traiter une table à l’intérieur : pandas, Polars, DuckDB et PyArrow dans un notebook Python pur, et PySpark, Spark SQL ou l’API pandas sur Spark dans un notebook Spark. Ce ne sont pas cinq syntaxes pour la même chose. Ce sont des architectures d’exécution différentes, et la bonne dépend du volume de vos données, de la mémoire qu’elles demandent, des fonctionnalités de Delta Lake dont vous dépendez et de la taille qu’auront les données l’an prochain.
Ce guide répond à une question : quand utiliser pandas, Polars, DuckDB ou PySpark dans Microsoft Fabric ? Il compare les moteurs au niveau de l’architecture (modèle d’exécution, vitesse selon le volume, comportement mémoire, prise en charge de Delta Lake, support et coût) et se termine par un cadre de décision. En chemin, il présente ce que nous avons mesuré dans notre propre benchmark sur Fabric avec de vraies données de taxis new-yorkais, y compris une découverte sur l’orchestration des notebooks qui a changé notre façon d’exécuter les notebooks Python dans les pipelines, et il vous donne un harness à exécuter sur votre propre capacité. Il ne compare pas les syntaxes ; pour les différences d’API entre pandas et PySpark, consultez la série sur les DataFrames Python.
En bref
- Des petites données qui resteront petites (Microsoft place la limite autour de 1 Go compressé) : un notebook Python avec Polars ou DuckDB est généralement le choix le plus rapide et le plus simple. pandas convient aux DataFrames vraiment petits et constitue souvent la bonne dernière étape.
- 1 Go compressé ou plus, ou des données qui y arriveront : Microsoft recommande le noyau Spark, en commençant par une session mono-nœud de 8 vCores du starter pool si les données restent modestes. PySpark et Spark SQL s’exécutent sur le même moteur ; choisissez selon l’équipe et la lisibilité, pas selon l’échelle.
- Pipelines de production très orientés Delta (MERGE, UPDATE, DELETE, deletion vectors, OPTIMIZE, VACUUM, Change Data Feed) : Fabric Spark. Les moteurs Python lisent bien Delta, mais n’en écrivent qu’une partie.
- Les jointures, les écritures et la croissance comptent plus que la vitesse de lecture. Une lecture locale rapide ne fait pas d’un moteur le bon choix pour l’ETL de production.
- Faites un benchmark de votre propre charge de travail avant de vous engager. Les plages de benchmark de Microsoft présentées plus bas sont des observations, pas des seuils.
Ce que notre benchmark dans Fabric a mesuré
Nous avons exécuté les moteurs dans un pipeline Microsoft Fabric sur de vraies données Parquet des taxis jaunes de New York. Trois constats méritent d’être connus avant la théorie ; les résultats complets et la méthode viennent plus loin.
- Sur un petit jeu de données, pandas et Polars ont terminé à 0,21 seconde d’écart. Sur le jeu S (trois fichiers Parquet, 11 198 026 lignes, agrégées en 1 240 lignes), une exécution a demandé 2,3387 s de traitement avec pandas et 2,5467 s avec Polars, et les deux ont produit des checksums SHA-256 identiques. C’est une exécution unique sur une petite entrée : elle permet de dire « les deux conviennent à cette taille », pas « pandas est plus rapide ».
- La durée d’une activité de notebook n’est pas le temps de traitement du moteur. Chaque activité autonome de benchmark Python du pipeline a duré de 34 à 38 secondes, alors qu’une exécution mesurée de pandas ou de Polars sur le jeu S a demandé 2,3 à 2,5 secondes de traitement. La durée d’activité affichée par Fabric couvre aussi la session du notebook et son cycle de vie : sur de petites données, la manière d’orchestrer les notebooks peut compter davantage que le choix du moteur.
- Un notebook parent a fait mieux que trois activités séparées en durée d’activité. Un notebook runner Python qui appelait le notebook de benchmark une fois par moteur avec
notebookutils.notebook.runMultiple()a terminé en 51 secondes, contre 104 secondes cumulées pour trois activités de notebook séparées. Aucune session tag n’a été utilisée, et il ne s’agit pas d’une comparaison contrôlée du temps total réel (wall-clock). La section sur l’orchestration explique ce que cela montre et ce que cela ne montre pas.
Deux runtimes, pas un seul
Les notebooks Fabric prennent en charge un noyau Python, un noyau Spark et un noyau T-SQL. Les deux premiers nous intéressent ici, et ce sont des environnements distincts, avec leurs propres versions et cycles de vie. Les confondre est la source la plus fréquente de mauvais conseils.
| Notebook Python Fabric | Notebook Spark Fabric (Runtime 2.0) | |
|---|---|---|
| Exécution | Un seul nœud, pas d’exécution distribuée | Driver et executors ; mono-nœud ou multi-nœud |
| Calcul par défaut | 2 vCores / 16 Go (1 CU) ; configurable jusqu’à 64 vCores avec %%configure |
Starter pool : nœuds de 8 vCores avec mise à l’échelle automatique |
| Version de Python | Le noyau choisi : 3.10, 3.11 ou 3.12 ; 3.12 par défaut | 3.13, fixée par le runtime |
| Versions des moteurs | Bibliothèques du runtime des notebooks Python | Apache Spark 4.1, Java 21, Delta Lake 4.2 |
| Moteurs | pandas, Polars, DuckDB, PyArrow ; delta-rs (deltalake) pour Delta |
PySpark, Spark SQL, Scala, SparkR, API pandas sur Spark |
| Delta Lake | Lecture et écriture via delta-rs et DuckDB ; « certaines fonctionnalités de Delta Lake peuvent ne pas être entièrement prises en charge » | Prise en charge complète |
| Native Execution Engine | Non | Oui, lorsqu’il est activé |
Runtime 2.0 est le runtime GA et le runtime par défaut des nouveaux espaces de travail et éléments d’environnement. Microsoft précise que la version de Python d’un runtime Spark est indépendante du noyau de notebook Python que vous sélectionnez : choisir l’un ne change pas l’autre. Python 3.10 a atteint sa fin de support annoncée en octobre 2026 ; les nouveaux notebooks Python devraient donc utiliser 3.11 ou 3.12. La comparaison Runtime 2.0, 1.3 et 1.2 détaille le runtime Spark.
Dans un notebook Python, Microsoft indique que DuckDB, Polars et scikit-learn sont préinstallés, fournit delta-rs et DuckDB « pour prendre en charge la lecture et l’écriture de données Delta Lake » et donne un conseil qui encadre tout cet article : si vous rencontrez un OOM en chargeant un gros volume de données, essayez DuckDB, Polars ou un DataFrame PyArrow au lieu de pandas. Les versions des bibliothèques du runtime Python évoluent ; le benchmark présenté plus bas les enregistre au lieu de les supposer.
D’abord, les modèles d’exécution
Avant de comparer les vitesses, il faut savoir où le travail s’exécute.
- Mono-nœudpandas, Polars, DuckDB, PyArrow
- Processus du notebookUn processus Python sur une VM
- Moteur dans le processusLes threads partagent la mémoire d'une machine
- pandas
- Polars
- DuckDB
- Limite de la machineJusqu'à 64 vCores dans un notebook Python Fabric
- DistribuéPySpark, Spark SQL, API pandas sur Spark
- DriverPlanifie la requête et répartit les tâches
- ExecutorsTraitent les partitions en parallèle
- Partition 1
- Partition 2
- Partition N
- ShuffleDéplace des lignes entre executors pour les jointures et agrégations
- Ajouter des nœudsMonter en charge sans réécrire le code
- pandas s’exécute de façon immédiate (eager) dans un processus Python. Chaque étape matérialise un DataFrame complet en mémoire avant que la suivante commence, et la plupart des opérations utilisent un seul cœur.
- Polars s’exécute sur une machine mais utilise tous ses cœurs. Les données sont stockées dans un format en colonnes de style Arrow, et l’API lazy (
scan_parquet…collect()) permet à l’optimiseur de pousser les filtres et la sélection de colonnes jusqu’à la lecture avant de lire quoi que ce soit. - DuckDB est une base de données analytique embarquée : un moteur SQL vectorisé dans votre processus Python, sans serveur. Il interroge directement les fichiers Parquet (
read_parquet) sans les convertir d’abord en DataFrame. - PyArrow est surtout le format mémoire en colonnes et la couche d’E/S que les autres partagent (lecture et écriture Parquet, datasets, transferts sans copie). Il a des fonctions de calcul, mais c’est davantage la tuyauterie que le moteur autour duquel on conçoit un pipeline.
- PySpark et Spark SQL décrivent une requête qu’un driver planifie et que des executors exécutent en parallèle sur des partitions des données. Les lignes circulent entre executors (un shuffle) lorsqu’une jointure ou une agrégation en a besoin ensemble. Ajouter des nœuds ajoute de la capacité sans changer le code.
Tout le reste de l’article découle de cette distinction : les moteurs mono-nœud démarrent vite et coordonnent très peu ; Spark paie des coûts de coordination qui ne sont rentables que lorsque le travail est assez gros pour être partagé.
La vitesse change avec l’échelle
Le guide de sélection des noyaux de notebook de Microsoft décrit une tendance nette, issue de benchmarks ELT de bout en bout comparant Fabric Spark avec le Native Execution Engine aux moteurs Python mono-machine (pandas, DuckDB, Polars) :
| Volume de données compressées | Tendance observée par Microsoft |
|---|---|
| Très petit, moins de ~140 Mo | Les moteurs Python mono-machine (DuckDB, Polars) sont plus rapides |
| Petit, ~1–2 Go | Les moteurs Python gardent l’avantage ; Fabric Spark avec le Native Execution Engine devient compétitif à mesure que le nombre de cœurs par moteur augmente, surtout pour les opérations riches en écritures |
| Petit à moyen, ~10–13 Go | Fabric Spark avec le Native Execution Engine est compétitif ou plus rapide que la plupart des moteurs mono-machine ; ceux-ci peuvent manquer de mémoire (OOM) avec moins de vCores |
| Moyen et au-delà, ~100 Go et plus | Pour la plupart des charges, Fabric Spark avec le Native Execution Engine est le moteur le plus rapide et le plus fiable |
Ce sont des observations issues des benchmarks de Microsoft, pas des limites. Le point de bascule de votre pipeline dépend des opérations (lectures, jointures ou écritures), du nombre de cœurs de chaque moteur, du format et de l’organisation des fichiers, du partitionnement, de la compression, de la mémoire et de la configuration du cluster.
- Mono-nœud plus rapideMoins de ~140 MoDuckDB et Polars évitent le surcoût distribué
- les données grossissentMono-nœud devant~1–2 GoSpark avec NEE compétitif quand les cœurs augmentent, surtout en écriture
- les données grossissentPoint de bascule~10–13 GoSpark avec NEE compétitif ou plus rapide ; un nœud avec peu de cœurs peut faire un OOM
- les données grossissentSpark avec NEE devant~100 Go et plusLe plus rapide et le plus fiable pour la plupart des charges
Pourquoi les moteurs mono-nœud gagnent sur les petites charges
Sur une petite table, l’essentiel du temps écoulé est du surcoût, pas du calcul. Polars, DuckDB et pandas s’exécutent dans le processus qui porte déjà votre session : aucune requête n’a besoin d’être découpée en tâches, aucune tâche d’être planifiée sur un executor, aucune ligne d’être sérialisée et déplacée entre machines, et aucun résultat de revenir à un driver.
Spark paie tout cela à chaque job : planifier et ordonnancer les stages, lancer les tâches, préparer les fichiers de shuffle et coordonner les executors. Sur 100 Mo, ces coûts fixes peuvent représenter l’essentiel de l’exécution. Sur 100 Go, ils deviennent négligeables, et le parallélisme qu’ils achètent est précisément ce qui compte.
Le démarrage de la session n’explique pas tout
Le démarrage de la session dominait autrefois cette comparaison. Aujourd’hui dans Fabric, une session Spark du starter pool démarre en cinq secondes environ, ce qui est comparable à un notebook Python, et une session Spark mono-nœud de 8 vCores du starter pool démarre tout aussi vite. Les pools Spark personnalisés prennent généralement trois à cinq minutes, et Microsoft précise qu’une exécution de notebook Python qui ne trouve pas de place dans son live pool peut aussi prendre jusqu’à trois minutes. Mesurez le démarrage de la session séparément de l’exécution ; le guide sur le démarrage des notebooks montre comment séparer le temps de file d’attente, de session et d’exécution.
Pourquoi le Native Execution Engine change la comparaison
Le Native Execution Engine (NEE) explique pourquoi les plages de Microsoft favorisent Spark aussi tôt. Il déporte les opérateurs Spark pris en charge de la JVM vers un chemin d’exécution vectorisé en C++ construit sur Velox et Apache Gluten, avec une prise en charge native de Parquet et de Delta, tout en conservant le comportement de l’optimiseur de Spark (exécution adaptative des requêtes, élagage des colonnes, predicate pushdown). Il ne nécessite aucune modification du code.
Ce que cela change pour cette comparaison :
- Il réduit l’avantage dont profitaient les moteurs mono-nœud. Polars et DuckDB sont rapides en partie parce que ce sont des moteurs vectorisés en colonnes. Le NEE apporte le même style d’exécution aux opérateurs de Spark.
- Il aide surtout là où Spark a déjà sa place : requêtes gourmandes en calcul sur Parquet et Delta, jointures, agrégations et transformations complexes. Microsoft indique que les gains sont plus faibles pour les requêtes simples ou limitées par les E/S.
- Il n’est pas universel. Les opérateurs et fonctionnalités non pris en charge reviennent automatiquement à Spark sur la JVM : structured streaming, sources JSON et XML, entre autres. Les comparaisons de dates exigent des types identiques des deux côtés. Ce repli (fallback) est visible dans
df.explain()et dans la Spark UI (les opérateurs natifs se terminent parTransformer, ou apparaissent commeNativeFileScanouVeloxColumnarToRowExec), et Fabric Spark Advisor le signale dans la sortie de la cellule. - Il faut l’activer. Runtime 1.3 et 2.0 le prennent en charge ; activez-le dans les paramètres Acceleration de l’environnement ou avec
spark.native.enableddans%%configure.
Microsoft fait état de gains de plusieurs fois sur des charges de benchmark représentatives. Le chiffre précis de la page du runtime est jusqu’à six fois plus rapide que Spark open source sur TPC-DS au facteur d’échelle 1000 avec Delta, ce que Microsoft traduit par environ 83 % d’économies de calcul sur un cluster de taille fixe. Voyez-le comme le plafond d’un benchmark, pas comme un multiplicateur pour votre job.
La mémoire est souvent le facteur décisif
Les graphiques de vitesse donnent l’impression que les moteurs sont interchangeables, jusqu’à ce que l’un d’eux manque de mémoire. En pratique, la mémoire décide davantage du choix d’un moteur que la vitesse brute.
pandas garde chaque DataFrame intermédiaire entièrement en mémoire, dans un seul processus. Le Parquet compressé occupe peu de place sur disque ; les colonnes décompressées en mémoire en occupent davantage, et les colonnes d’objets Python et de chaînes beaucoup plus encore. Les jointures, les conversions de type et les copies multiplient l’ensemble de travail. C’est pourquoi pandas peut manquer de mémoire sur des données dont la taille de stockage semble anodine, et pourquoi le premier conseil de Microsoft en cas d’OOM est d’en changer.
Polars conserve les données dans un format en colonnes compact, utilise tous les cœurs et, avec l’API lazy, ne lit que les colonnes et les row groups nécessaires à une requête. Son moteur de streaming (collect(engine="streaming") dans les versions actuelles) traite les requêtes par lots et peut gérer des données qui ne tiennent pas en mémoire, mais les opérations non implémentées en streaming reviennent au moteur en mémoire, ce qui peut faire revenir la pression mémoire. Il est généralement bien plus économe en mémoire que pandas, mais la machine reste la limite.
DuckDB exécute du SQL vectorisé directement sur les fichiers et gère des charges plus grandes que la mémoire en déversant sur disque (spill) : les regroupements, les jointures, les tris et les fonctions de fenêtrage peuvent tous décharger des données intermédiaires dans un répertoire temporaire. Sa propre documentation liste les exceptions : plusieurs opérateurs bloquants dans une même requête peuvent encore provoquer une erreur de mémoire insuffisante, et certaines agrégations (comme string_agg) ne peuvent pas déverser sur disque.
Spark répartit l’ensemble de travail entre les executors. L’entrée est découpée en partitions, chaque tâche traite une tranche, les shuffles distribuent les données intermédiaires, et les données de shuffle, de tri et d’agrégation peuvent déverser sur disque. La capacité augmente en ajoutant des workers.
- pandasUn processus, exécution immédiate
- Les données grossissent
- Tout le DataFrame en mémoirePlus les copies des jointures et conversions
- Pression mémoireBien en dessous de la taille nominale du nœud
- OOMLe noyau s'arrête ; les variables sont perdues
- Polars et DuckDBUne machine, en colonnes
- Les données grossissent
- Colonnes, pushdownNe lit que les colonnes et row groups utiles
- Lots ou spillStreaming dans Polars ; DuckDB déverse sur disque
- Limite de la machineUn plus gros nœud, jusqu'à 64 vCores, puis plus rien
- SparkDriver et executors
- Les données grossissent
- PartitionnerL'entrée est découpée en tâches
- Distribuer et shuffleLes executors se partagent l'ensemble de travail ; spill sur disque
- Ajouter des workersLe skew, les broadcasts et les collect vers le driver peuvent encore faire un OOM
Spark peut aussi manquer de mémoire
La mémoire distribuée déplace la limite ; elle ne la supprime pas. Les OOM classiques de Spark consistent tous à concentrer des données au même endroit :
- Collecte sur le driver.
collect()ettoPandas()ramènent l’intégralité du résultat sur le driver. - Broadcasts trop volumineux. Une jointure broadcast copie le petit côté sur chaque executor ; diffuser quelque chose qui n’est pas petit échoue sur le driver ou sur les executors.
- Déséquilibre (skew). Une clé qui porte une grande part des lignes envoie cette part à une seule tâche, quel que soit le nombre d’executors.
- Partitions trop grosses. Trop peu de partitions pour les données signifie que chaque tâche en porte trop.
- Cache mal maîtrisé. Mettre en cache de gros résultats intermédiaires prend de la mémoire d’executor au travail qui en a besoin.
- État non borné. Lignage long, grandes partitions de fenêtrage ou état de streaming qui ne cesse de croître.
Le guide de performance des notebooks et l’aide-mémoire performance PySpark expliquent comment les repérer et les corriger.
Comparaison de la mémoire
| Moteur | Limite mémoire mono-nœud | Exécution lazy ou en streaming | Spill sur disque | Mémoire distribuée |
|---|---|---|---|---|
| pandas | Oui : tout l’ensemble de travail dans un processus | Non : immédiate, chaque étape est matérialisée | Non | Non |
| Polars | Oui : une machine | Plans lazy ; le moteur de streaming traite par lots et revient au moteur en mémoire pour les opérations non prises en charge | Pas de mécanisme général ; s’appuie sur le streaming | Non |
| DuckDB | Oui, borné par sa limite mémoire sur une machine | Les pipelines vectorisés traitent les lectures en flux | Oui : opérateurs GROUP BY, JOIN, ORDER BY et de fenêtrage ; certaines requêtes et agrégations peuvent encore faire un OOM | Non |
| PyArrow | Oui : une machine | Lecture des datasets par lots d’enregistrements | Pas de mécanisme général | Non |
| PySpark, Spark SQL, API pandas sur Spark | Le driver a sa propre limite pour les collect, toPandas() et les broadcasts |
Plans lazy, exécutés par stage | Oui : données de shuffle, de tri et d’agrégation | Oui, entre executors |
Les moteurs en un coup d’œil
| Moteur | Modèle d’exécution | Surcoût de démarrage | Modèle mémoire | Montée en charge horizontale | Capacités Delta dans Fabric | Usage idéal |
|---|---|---|---|---|---|---|
| pandas | Un processus, immédiat, surtout un cœur | Faible | Tout en mémoire ; chaînes et objets coûteux | Non | Via delta-rs ou Spark, pas nativement | Petites données, résultats finaux, écosystème Python |
| Polars | Une machine, multithread, en colonnes, optimiseur lazy | Faible | En colonnes ; pushdown ; lots en streaming | Non | Lecture ; append, overwrite et MERGE ; pas d’UPDATE ni de DELETE | ETL rapide en DataFrames sur un nœud |
| DuckDB | Moteur SQL vectorisé embarqué | Faible | Vectorisé ; déverse les opérateurs bloquants | Non | Lecture ; INSERT uniquement | SQL sur fichiers, analyses ad hoc |
| PyArrow | Format en colonnes, E/S et noyaux de calcul | Faible | Buffers Arrow ; lecture par lots | Non | Via deltalake (delta-rs) |
Échanges, E/S Parquet, transfert sans copie |
| API pandas sur Spark | API de style pandas compilée vers Spark | Moyen | Distribuée | Oui | Complète, via Spark | Compétences pandas sur le moteur Spark |
| DataFrame PySpark | Distribué : driver, executors, NEE en option | Moyen | Distribuée ; spill | Oui | Complète | ETL de production, grosses jointures, Delta |
| Spark SQL | Même moteur que PySpark | Moyen | Distribuée ; spill | Oui | Complète | Équipes orientées SQL, à toute échelle |
Ici, le « surcoût de démarrage » inclut la coordination de chaque job en plus du démarrage de la session. Une session Spark déjà chaude ordonnance toujours des tâches pour chaque requête.
Jointures, agrégations et écritures
Jointures
Sur un seul nœud, une jointure est rapide si les deux côtés et le résultat tiennent confortablement en mémoire. Polars et DuckDB y excellent ; pandas convient tant que les DataFrames restent petits. DuckDB peut déverser une grosse jointure sur disque ; pandas, non.
Dans Spark, la stratégie de jointure compte davantage que la taille de l’entrée :
- Broadcast hash join : le petit côté est copié sur chaque executor et le gros côté ne bouge jamais. Spark diffuse automatiquement en dessous de
spark.sql.autoBroadcastJoinThreshold(10 Mo par défaut dans Apache Spark). - Jointures avec shuffle : les deux côtés sont repartitionnés selon la clé de jointure pour que les lignes correspondantes se retrouvent sur le même executor. C’est ce qui rend possibles les jointures entre grandes tables, et c’est aussi là que se concentre l’essentiel du coût.
- Skew : si une clé domine, une seule tâche fait l’essentiel du travail. L’exécution adaptative des requêtes, activée par défaut depuis Spark 3.2, peut scinder les partitions déséquilibrées dans les sort-merge joins, mais elle ne peut pas corriger un modèle de données où un client représente la moitié de la table.
La forme de la jointure peut compter davantage que la taille des fichiers. Lire 100 Go avec un filtre sélectif peut coûter moins cher que joindre deux tables de 5 Go sur une clé à forte cardinalité, car la jointure doit déplacer et apparier chaque ligne des deux côtés. Réduisez les deux côtés avant la jointure (filtrer, projeter, agréger au grain nécessaire), puis mesurez. L’aide-mémoire sur les jointures PySpark présente les modèles.
Agrégations
Une agrégation vectorisée locale dans Polars ou DuckDB est exceptionnellement rapide : pas de shuffle, tous les cœurs travaillent sur un même espace mémoire partagé. Spark agrège en deux phases, une agrégation partielle sur chaque executor puis un shuffle pour combiner les résultats partiels, ce qui ajoute du surcoût sur de petites données et passe à l’échelle sur de grandes.
L’agrégation mono-nœud cesse d’être le meilleur choix quand la table de hachage ne tient plus (clés de regroupement à forte cardinalité), quand l’entrée est trop volumineuse pour être lue en un temps acceptable avec les cœurs d’une machine, quand plusieurs utilisateurs ou jobs partagent la même capacité, ou quand l’agrégation n’est qu’une étape d’un pipeline dont le vrai goulot d’étranglement est dans les écritures et les jointures.
Les écritures comptent plus que ne le laissent croire les benchmarks
Les benchmarks mesurent souvent les lectures, parce qu’elles sont faciles à comparer. Les pipelines de production écrivent aussi, et les écritures départagent davantage les moteurs que les lectures :
- Les écritures Parquet sont bien prises en charge partout. Spark écrit de nombreux fichiers en parallèle (un ou plusieurs par tâche) ; les moteurs mono-nœud en écrivent généralement un seul ou quelques-uns. Aucun n’a tort, mais le nombre et la taille des fichiers pèsent sur chaque lecture ultérieure ; voir la maintenance des tables Delta pour le problème des petits fichiers.
- Les écritures Delta sont là où les moteurs diffèrent le plus : sémantique transactionnelle, MERGE, UPDATE et DELETE, deletion vectors, checkpoints et maintenance. La section suivante donne le détail.
- Le MERGE à grande échelle est une jointure suivie d’une réécriture des fichiers concernés. Spark avec les deletion vectors le traite en merge-on-read ; les modèles de performance MERGE pour Delta s’appliquent alors.
- Les écritures concurrentes exigent une détection des conflits. Spark et delta-rs implémentent un contrôle de concurrence optimiste ; un INSERT DuckDB ne détecte pas les conflits.
Une lecture locale rapide ne fait pas d’un moteur le meilleur choix pour l’ETL de production. Le moteur doit terminer l’écriture correctement, de façon transactionnelle et avec une organisation exploitable par le lecteur suivant.
Compatibilité avec Delta Lake
C’est le facteur décisif de nombreux pipelines Fabric, car les tables du Lakehouse sont des tables Delta. Le tableau ci-dessous résume la matrice de fonctionnalités de Microsoft, qui reflète des tests directs sur Fabric Spark Runtime 1.3 et 2.0 en juin 2026. L’écosystème Delta open source pour Python publie souvent de nouvelles versions ; vérifiez les notes de version de chaque projet avant de compter sur une fonctionnalité.
| Fonctionnalité Delta | Fabric Spark | delta-rs (deltalake) |
DuckDB | Polars |
|---|---|---|---|---|
| Lire des tables Delta | Oui | Oui | Oui | Oui |
| Append et overwrite | Oui | Oui | INSERT uniquement, sans évolution de schéma | Oui |
| MERGE | Oui | Oui | Non | Oui |
| UPDATE et DELETE | Oui | Oui | Non | Non |
| Écrire des deletion vectors | Oui | Non | Non | Non |
| Lire des deletion vectors | Oui | Non | Oui | Oui |
| OPTIMIZE | Oui | Oui | Non (utiliser delta-rs) | Non (utiliser delta-rs) |
| VACUUM | Oui | VACUUM LITE uniquement | Non | Non |
| Écrire le Change Data Feed | Oui | Non | Non | Non |
| Écritures avec Liquid Clustering | Oui | Non | Non | Non |
| Checkpoints | Tous les 10 commits par défaut | Configurable, 100 par défaut | INSERT n’en écrit aucun | Configurable, 100 par défaut |
Les conséquences que souligne Microsoft :
- Les deletion vectors sont activés par défaut pour les nouvelles tables à partir de Runtime 2.0, et aucun moteur Python ne peut les écrire. Écrire avec un moteur Python dans une table où ils sont activés provoque des erreurs de compatibilité.
- Les pipelines multi-moteurs doivent figer la version. Si Polars ou DuckDB lisent et que delta-rs écrit, les deux côtés doivent figer la version de la table pour conserver l’isolation entre lecture et écriture.
- Les tables écrites uniquement par des moteurs Python accumulent de petits fichiers et de longs journaux de transactions si vous n’exécutez pas vous-même la maintenance avec delta-rs ; un INSERT DuckDB n’écrit jamais de checkpoint.
- Les métadonnées de row tracking (
row_id,row_commit_version) ne sont lisibles que dans Spark : une logique de CDC ou de déduplication qui en dépend doit donc lire avec Spark.
Microsoft recommande lui-même de considérer les moteurs Python comme un complément de Spark pour les lectures légères, le développement local et les appends simples, plutôt que comme un remplaçant généraliste. Pour le modèle Delta lui-même, voir les tables Delta pour les ingénieurs SQL Server.
Support
C’est la question d’architecte à laquelle les graphiques de vitesse ne répondent jamais : qui répare quand ça casse ?
Fabric Spark est le fork d’Apache Spark de Microsoft. Microsoft maintient et livre le runtime, assure le support de bout en bout des composants internes de Spark et de Delta, y compris le Native Execution Engine, et accepte les demandes de support sur le comportement de Spark, les plans de requête, les problèmes de mémoire et les bugs du moteur. Les mises à jour du runtime apportent des gains de performance au code existant.
DuckDB et Polars sont des moteurs open source que Fabric met à disposition. Microsoft n’en maintient pas de fork. Son support couvre les intégrations OneLake livrées dans le runtime Fabric, comme l’authentification et l’accès au système de fichiers. Un bug du moteur, une régression de performance ou un changement d’API entre versions de la bibliothèque relèvent de la communauté open source. Microsoft note aussi que les changements d’API entre versions peuvent imposer une refactorisation, qu’aucun des deux moteurs n’a d’équivalent de supervision en direct comparable à la Spark UI, et qu’une pile ELT complète construite dessus assemble généralement plusieurs bibliothèques (DuckDB pour la transformation, delta-rs pour les écritures et la maintenance) dont vous devez ensuite maintenir la compatibilité des versions.
Rien de tout cela n’en fait un mauvais choix. Cela en fait un choix dont vous portez le risque opérationnel. Pour un notebook qu’un analyste exécute à la demande, c’est généralement acceptable. Pour le pipeline qui alimente une clôture financière, cela mérite une décision explicite.
Coût et concurrence
« Spark coûte toujours plus cher » est un mythe, et l’inverse aussi. Fabric facture le calcul en unités de capacité dans le temps ; pour une configuration donnée :
Coût = ressources réservées × temps écoulé.
Le guide de sélection de Microsoft donne les points de repère :
| Configuration | vCores | Unités de capacité pendant l’exécution |
|---|---|---|
| Notebook Python, par défaut | 2 | 1 CU |
| Notebook Python, le plus grand | 64 | 32 CU |
| Spark, mono-nœud de 4 vCores (pool personnalisé, démarrage plus lent) | 4 | 2 CU |
| Spark, mono-nœud de 8 vCores (starter pool) | 8 | 4 CU |
| Starter pool Spark, après mise à l’échelle proactive | Workers de 8 cœurs | 8 CU minimum |
Deux conséquences :
- Pour de petits traitements, un notebook Python de 2 vCores qui termine dans le même temps que Spark consomme une fraction de la capacité. La configuration Spark mono-nœud de 8 vCores existe pour réduire cet écart tout en gardant les fonctionnalités de Spark.
- Pour de gros traitements, un moteur qui termine plusieurs fois plus vite avec plus de cœurs peut consommer moins au total qu’un moteur plus petit qui tourne bien plus longtemps, ou qu’un moteur qui échoue et doit être relancé.
La comptabilité réelle de la capacité comporte plus de nuances (lissage, bursting, opérations en arrière-plan ou interactives) ; consultez la capacité Fabric expliquée avant de promettre des CU à une équipe finance.
La concurrence change encore la donne. Cinq analystes qui exécutent chacun un notebook Python de 64 vCores réservent cinq gros nœuds ; le mode haute concurrence de Spark permet à des notebooks compatibles de partager une session, et les pools Spark isolent les charges. Microsoft cite la haute concurrence et l’ordonnancement des jobs FAIR ou FIFO parmi les raisons de choisir le noyau Spark. Lorsque de nombreux jobs partagent une capacité, choisissez le moteur en fonction de la capacité, pas seulement d’un job.
Spark d’abord, pandas à la fin
La ligne la plus coûteuse de nombreux notebooks Fabric est celle-ci :
pdf = spark_df.toPandas() # on a large DataFrame: every row moves to the drivertoPandas() rapatrie l’intégralité du DataFrame Spark dans la mémoire du driver et la convertit en pandas. Sur une grosse table, cela transforme un job distribué en job mono-machine au pire moment, et le driver manque de mémoire bien avant que les executors ne l’auraient fait. La consigne de Microsoft est claire : ne l’utilisez que pour des résultats petits ou moyens ; filtrez, agrégez ou échantillonnez d’abord dans Spark.
- 2 ToTables du LakehouseRestent dans Spark
- SparkFiltrer et projeterPrédicats poussés à la lecture ; seules les colonnes utiles sont lues
- SparkAgrégerRéduire au grain dont l'analyse a besoin
- 20 MoPetit résultatTient largement dans la mémoire du driver
- toPandas()pandasGraphiques, machine learning, bibliothèques Python
from pyspark.sql import functions as F

monthly = (spark.read.table("sales_orders")
           .where(F.col("order_date") >= "2026-01-01")
           .groupBy("region", F.trunc("order_date", "month").alias("month"))
           .agg(F.sum("amount").alias("revenue")))

pdf = monthly.toPandas() # a few hundred rows, not two terabytesLa même règle vaut dans l’autre sens : ne chargez pas un gros fichier dans pandas dans un notebook Python « pour y jeter un œil ». Réduisez-le avec Polars ou DuckDB, puis convertissez le petit résultat si une bibliothèque a besoin de pandas.
Là où chaque moteur excelle
pandas : le bon dernier kilomètre
pandas n’est pas le méchant de cet article. Il reste excellent pour les petites données, les résultats finaux, le travail de data science et surtout pour sa compatibilité avec l’écosystème : bibliothèques de graphiques, paquets de statistiques et de machine learning, et d’innombrables outils en aval attendent un DataFrame pandas. pandas est souvent le bon dernier kilomètre, pas le bon premier kilomètre pour d’énormes volumes. Ses limites sont l’exécution dans un seul processus et le tout-en-mémoire, pas sa qualité.
Polars : des DataFrames rapides sur un seul nœud
Polars est intéressant pour l’exploration en notebook, les transformations de fichier à fichier, les jeux de données moyens qui tiennent sur une machine et l’ETL mono-nœud haute performance, avec une API de DataFrames qui paraît familière. Utilisez l’API lazy (scan_parquet au lieu de read_parquet) pour que l’optimiseur élague colonnes et row groups avant la lecture.
import polars as pl

top_customers = (pl.scan_parquet("/lakehouse/default/Files/raw/orders/*.parquet")
                 .filter(pl.col("status") == "shipped")
                 .group_by("customer_id")
                 .agg(pl.col("amount").sum().alias("revenue"))
                 .sort("revenue", descending=True)
                 .head(100)
.collect())Ce n’est pas un « mini Spark ». Il ne distribue pas, n’a pas de cluster vers lequel grandir, et quand les données dépassent le plus gros nœud, le code doit migrer.
DuckDB : du SQL sur des fichiers
DuckDB convient à l’analyse orientée SQL : lire du Parquet, joindre des fichiers entre eux, explorer de manière ad hoc et faire du traitement analytique embarqué dans un notebook Python, sans rien charger au préalable dans un DataFrame. Dans un notebook Python auquel un lakehouse par défaut est attaché, les fichiers du Lakehouse sont disponibles sous /lakehouse/default/Files/ :
import duckdb

duckdb.sql("""
    SELECT region, date_trunc('month', order_date) AS month, sum(amount) AS revenue
    FROM read_parquet('/lakehouse/default/Files/raw/orders/*.parquet')
    WHERE status = 'shipped'
    GROUP BY ALL
    ORDER BY ALL
""").df() # convert the small result for pandas-based toolsPour les tables du Lakehouse, partez de l’extrait de code généré par le notebook (glissez la table sur le canevas ou utilisez Load data), qui utilise les bibliothèques Delta fournies avec le runtime. Les écritures Delta de DuckDB se limitent à INSERT ; utilisez delta-rs pour tout le reste.
PySpark et Spark SQL : un moteur, deux langages
PySpark et Spark SQL se compilent vers les mêmes plans et s’exécutent sur le même calcul Spark, Native Execution Engine compris. Microsoft décrit les langages du noyau Spark (PySpark, Spark SQL, Scala, SparkR) comme « tous adossés au même calcul Spark ». Spark SQL ne signifie pas une échelle plus petite que PySpark.
Choisissez selon le style d’expression et les compétences de l’équipe :
- Spark SQL pour les transformations ensemblistes qu’une équipe SQL lira et relira, et pour une logique qui se traduit naturellement en
SELECT … JOIN … GROUP BY. - PySpark pour les pipelines programmatiques : listes de colonnes paramétrées, fonctions réutilisables, schémas dynamiques et transformations testables unitairement (voir les tests unitaires PySpark avec pytest).
Les mélanger dans un même notebook est normal : spark.sql(...) renvoie un DataFrame et createOrReplaceTempView en expose un au SQL.
API pandas sur Spark : une syntaxe familière, un moteur distribué
L’API pandas sur Spark (import pyspark.pandas as ps) offre une syntaxe de style pandas au-dessus du moteur distribué de Spark. Elle a du sens pour les équipes très à l’aise avec pandas, pour porter une logique pandas existante vers de plus gros volumes et comme aide à la migration. Pour l’ingénierie de production exigeante, PySpark natif ou Spark SQL sont généralement plus clairs : transposer la sémantique de pandas (ordre des lignes, alignement des index) vers un moteur distribué peut masquer des opérations coûteuses, et les plans, les jointures et le partitionnement sont plus faciles à raisonner avec les API natives. C’est une option légitime, pas un raccourci pour ne pas comprendre Spark.
Concevoir pour le volume de demain, pas pour l’échantillon d’aujourd’hui
Les choix de moteur se font généralement sur les données d’aujourd’hui :
| Volume quotidien | Ce que donne un pipeline mono-nœud | |
|---|---|---|
| Aujourd’hui | 700 Mo | Rapide, bon marché, simple |
| Dans six mois | 15 Go | Nœud plus gros, exécutions plus longues, OOM occasionnels |
| Dans deux ans | 200 Go | Réécriture |
La réécriture est la partie coûteuse : d’autres API, d’autres chemins d’écriture Delta, d’autres tests, une autre supervision, et une migration menée dans l’urgence parce que le job échoue déjà. Microsoft fait le même constat dans son guide de sélection : migrer du code lorsque les données dépassent les limites d’un moteur non distribué coûte cher, et démarrer avec Spark dans une configuration mono-nœud permet de passer à plusieurs nœuds sans réécrire le pipeline.
Posez-vous donc deux questions, pas une : quelle est la taille des données ? et quelle sera leur taille pendant la durée de vie de ce pipeline ? Si la réponse honnête à la seconde est « grande, ou inconnue », commencez avec Spark, même si un moteur mono-nœud gagne le benchmark d’aujourd’hui.
Un cadre de décision selon le volume de données
La référence est la recommandation de Microsoft : utilisez le noyau Python pour des données d’environ 1 Go compressé au plus lorsque la performance sur une seule machine compte le plus, et le noyau Spark à partir de 1 Go compressé, ou lorsque vous prévoyez que les données atteindront cette taille. Les plages ci-dessous sont mes propres heuristiques de travail autour de cette limite.
| Entrée compressée | Point de départ | Pourquoi |
|---|---|---|
| Moins de ~1 Go, stable | Polars ou DuckDB dans un notebook Python ; pandas pour les DataFrames vraiment petits | Le plus faible surcoût ; la plage du noyau Python selon Microsoft |
| Moins de ~1 Go, en croissance | Spark, mono-nœud de 8 vCores du starter pool | Le même démarrage rapide, pas de réécriture plus tard |
| ~1–10 Go | Benchmark des deux ; Spark par défaut pour les pipelines de production | Microsoft recommande Spark dès 1 Go ; les moteurs mono-nœud peuvent encore gagner en lecture et en travail interactif |
| ~10–100 Go | PySpark ou Spark SQL pour les pipelines de production | La plage de bascule de Microsoft ; jointures, écritures et risque d’OOM favorisent Spark |
| ~100 Go et plus | PySpark ou Spark SQL avec le Native Execution Engine | Microsoft observe que Spark avec NEE est le plus rapide et le plus fiable pour la plupart des charges |
Quelle que soit la taille, deux conditions poussent à elles seules vers Spark : des fonctionnalités Delta que les moteurs Python ne savent pas écrire (deletion vectors, usage intensif de MERGE avec DuckDB, UPDATE et DELETE avec Polars, Change Data Feed, Liquid Clustering) et de grosses jointures ou écritures.
Recommandations par type de charge
Recommandations Javi Builds (pas une exigence de Microsoft). « Très adapté » : un choix par défaut raisonnable. « Possible » : fonctionne, mais ce n’est pas le choix évident. « Benchmark d’abord » : la réponse dépend de vos données et de votre capacité. « À éviter » : mal adapté à cette architecture.
| Charge de travail | pandas | Polars | DuckDB | PySpark | Spark SQL |
|---|---|---|---|---|---|
| Filtre sur 100 Mo | Possible | Très adapté | Très adapté | Possible | Possible |
| Agrégation sur 1 Go | Benchmark d’abord | Très adapté | Très adapté | Possible | Possible |
| Jointure sur 10 Go | À éviter | Benchmark d’abord | Benchmark d’abord | Très adapté | Très adapté |
| Transformation sur 100 Go | À éviter | À éviter | À éviter | Très adapté | Très adapté |
| Gros MERGE Delta | À éviter | À éviter | À éviter | Très adapté | Très adapté |
| Exploration interactive de petites données | Très adapté | Très adapté | Très adapté | Possible | Possible |
| Analyses SQL répétées sur des fichiers modestes | À éviter | Possible | Très adapté | Possible | Très adapté |
| Gros ETL distribué | À éviter | À éviter | À éviter | Très adapté | Très adapté |
Arbre de décision
- Dimensionner la chargeEntrée compressée aujourd'hui et sur la durée de vie du pipeline
- Tient sur un nœud, durablement ?Les trois premières branches supposent que oui
- SQLDuckDBSQL sur Parquet et lectures Delta
- DataFramesPolarsTransformations lazy et multithread
- résultatspandasPetits résultats pour l'écosystème Python
- croissancePySpark ou Spark SQLDémarrer sur un nœud de 8 vCores ; monter en charge plus tard
- DeltaSpark avec NEEMERGE, deletion vectors, OPTIMIZE, grosses jointures
Benchmark réel dans Fabric
Les recommandations de Microsoft et ce benchmark sont des preuves de nature différente. Les plages de benchmark citées plus haut sont une référence documentée par Microsoft. Le benchmark Javi Builds est une expérience observée : une charge de travail réaliste dans un espace de travail Fabric (ws_fabric_engine_benchmark), orchestrée par un pipeline (pl_fabric_engine_benchmark), dont chaque chiffre publié est rattaché à une exécution. Il complète les plages de Microsoft ; il ne les remplace pas.
Les résultats ci-dessous proviennent d’un pilote : le pipeline a exécuté les six configurations de moteur (pandas, Polars, DuckDB, PySpark, Spark SQL et PySpark avec le Native Execution Engine), mais les temps au niveau des moteurs publiés à ce jour sont des exécutions uniques de pandas et de Polars sur une seule taille de jeu de données. Les exécutions contrôlées et répétées décrites dans Méthode sont la prochaine étape. Lorsqu’une valeur n’a pas été mesurée, cette section le dit au lieu de l’estimer.
Trois dimensions de performance, jamais un classement unique
Un benchmark dans Fabric produit trois types de durée. Elles répondent à des questions différentes, et les additionner ou les classer ensemble donne un résultat trompeur.
| Dimension | Ce qu’elle mesure | D’où elle vient | Exemple tiré de cette expérience |
|---|---|---|---|
| Temps de traitement du moteur | Le travail du moteur de la lecture à l’écriture, étape par étape | Chronomètres dans le notebook de benchmark | pandas 2,3387 s, Polars 2,5467 s sur le jeu S (une exécution) |
| Durée de l’activité de notebook | Une activité du pipeline de bout en bout : session du notebook, paramètres, imports, travail du moteur et cycle de vie de l’activité | Colonne Duration de l’onglet Output du pipeline | Activité Polars autonome : 34 s |
| Temps total réel du pipeline (wall-clock) | Du début de la première activité à la fin de la dernière, branches parallèles et attentes comprises | L’exécution du pipeline, ou déduit du tableau des activités | Environ 7 min 54 s pour la dernière exécution |
L’écart entre les deux premières lignes est la principale leçon sur de petites données : une activité autonome de benchmark Python a duré de 34 à 38 secondes, alors que le traitement qu’elle est censée mesurer a pris environ 2,5 secondes dans une exécution mesurée. Une comparaison de moteurs doit utiliser la première ligne. Une comparaison de conceptions de pipeline utilise la deuxième et la troisième.
Jeu de données
L’entrée est constituée de vraies données publiques : les enregistrements de courses des taxis jaunes de la NYC Taxi & Limousine Commission pour 2025, dans les fichiers Parquet mensuels officiels, plus la table officielle des zones de taxi. Les douze fichiers de 2025 totalisent environ 840 Mo compressés et 49,4 millions de lignes, avec des types de colonnes identiques chaque mois.
| Niveau | Entrée | Statut |
|---|---|---|
| XS | Un mois de 2025 | Utilisé par les activités Spark du pilote |
| S | Trois fichiers mensuels | Vérifié : 11 198 026 enregistrements bruts, 1 240 lignes agrégées |
| M | Douze mois | Prévu |
| L, XL | Copies répétées des douze mois, générées avec Spark jusqu’à environ 10 Go et 100 Go | Prévu |
Les niveaux supérieurs sont étiquetés pour ce qu’ils sont : des copies répétées/mises à l’échelle de données TLC réelles pour des tests de performance. Chaque copie porte un benchmark_replica_id : le schéma et les distributions de valeurs sont réels, mais les courses ne sont pas uniques.
Charge de travail
Tous les moteurs exécutent le même pipeline logique sur les mêmes fichiers préparés, de Parquet à Parquet, en six étapes chronométrées : lecture, transformation, agrégation, jointure, tri et écriture.
- mêmes fichiersParquet TLC préparéIdentifié par nom et taille de fichier
- 8 colonnesProjeter et filtrerDistance et montant positifs, dépose après la prise en charge
- zone, paiementAgrégerCourses, recettes, pourboires, tarif moyen, distance, durée
- table des zonesJointure et triLeft join sur la zone de prise en charge, recettes décroissantes
- écritureUn fichier ParquetPuis validé par rapport à tous les autres moteurs
- Transformation : garder les courses dont la distance et le montant total sont positifs et dont la dépose suit la prise en charge, puis calculer la durée de la course en minutes.
- Agrégation : regrouper par zone de prise en charge et type de paiement (1 240 groupes sur le jeu S) et calculer le nombre de courses, les recettes, les pourboires, le tarif moyen, la distance moyenne et la durée moyenne.
- Jointure : un left join de l’agrégat vers la table des zones de taxi sur l’identifiant de la zone de prise en charge, de sorte que les groupes dont la zone est inconnue sont conservés avec des noms de zone vides au lieu d’être écartés.
- Tri et écriture : recettes décroissantes avec des critères de départage déterministes, écrites dans un seul fichier Parquet.
Résultats : pandas et Polars sur le jeu S
| Étape | pandas | Polars |
|---|---|---|
| Lecture | 1,1506 s | 1,0510 s |
| Transformation | 0,2203 s | 0,2103 s |
| Agrégation | 0,7495 s | 1,0863 s |
| Jointure | 0,0752 s | 0,0663 s |
| Tri | 0,0054 s | 0,0065 s |
| Écriture | 0,1377 s | 0,1263 s |
| Total | 2,3387 s | 2,5467 s |
Ce que les chiffres permettent d’affirmer :
- Les deux moteurs ont produit la même réponse. 1 240 lignes en sortie, des recettes totales de 287 431 793,68 $, des pourboires totaux de 31 903 631,09 $ et des checksums SHA-256 identiques.
- Lire et agréger, c’est l’essentiel du travail. Lecture et agrégation représentent 81 % du total de pandas et 84 % du total de Polars. Une fois 11,2 millions de lignes réduites à 1 240 groupes, la jointure, le tri et l’écriture ne coûtent presque rien.
- Polars n’a pas été exécuté dans son meilleur mode. Pour chronométrer par étape, chaque étape doit se terminer avant que la suivante commence : Polars a donc dû matérialiser chaque résultat intermédiaire au lieu de laisser son optimiseur lazy planifier tout le pipeline d’un coup. L’étape d’agrégation, où l’écart est le plus grand, est précisément celle où un plan lazy fusionné ferait une différence. Une exécution lazy de bout en bout est une autre mesure, et la prochaine à faire.
- À cette taille, le choix du moteur se joue à quelques centaines de millisecondes. C’est la même conclusion que la plus petite plage de Microsoft : sur de petites données, tous les moteurs mono-nœud sont rapides, et c’est le surcoût ailleurs qui domine.
Les autres moteurs du pilote
DuckDB, PySpark, Spark SQL et PySpark avec le Native Execution Engine se sont tous exécutés avec succès en tant qu’activités du pipeline. Leurs temps de traitement sur le jeu S ne sont pas publiés, car les mesures qui les rendraient comparables (même jeu de données, exécutions répétées, sortie validée de façon croisée) n’existent pas encore. Leurs durées d’activité dans le pipeline figurent dans la section sur l’orchestration, et ce ne sont pas des temps de moteur : la durée d’une activité Spark inclut l’obtention d’une session Spark, et les activités Spark ont traité le jeu XS.
Méthode
Ce qu’a fait le pilote. pandas, Polars et DuckDB se sont exécutés dans un notebook Python Fabric (nb_fabric_engine_python), paramétré par engine, dataset_scale et run_count ; PySpark, Spark SQL et PySpark avec le Native Execution Engine se sont exécutés dans des notebooks Spark. Un pipeline a préparé les données, puis exécuté les moteurs. Le notebook de chaque moteur a chronométré les six étapes et écrit un checksum de sa sortie.
Ce que feront les exécutions contrôlées. Pour chaque moteur et chaque taille de jeu de données :
- Répétitions : une première exécution dans une session neuve, puis au moins cinq exécutions suivantes, dont on publie la médiane avec le minimum et le maximum. Chaque exécution est conservée, échecs compris. Cinq est le minimum pour publier une affirmation de performance ; avec moins d’exécutions, on ne peut pas distinguer de petits écarts du bruit.
- Chronométrage : une exécution étape par étape (pour voir où passe le temps) et une exécution de bout en bout (le meilleur plan propre à chaque moteur, écriture comprise). Les temps Spark se terminent toujours par une action, pour qu’un plan lazy ne soit jamais pris pour du travail effectué.
- Isolation : un moteur par noyau Python fraîchement redémarré, pour que chaque mesure mémoire soit la sienne ; une session neuve par configuration Spark ; les enfants d’un notebook runner s’exécutent un par un pendant qu’on les chronomètre.
- Le démarrage de la session est enregistré séparément de l’exécution et n’est jamais inclus dans le temps de traitement du moteur.
- L’environnement est relevé depuis la session au moment de l’exécution : capacité, vCores du notebook Python, pool et taille de nœud Spark, runtime, versions des bibliothèques, et présence réelle de l’exécution native dans le plan de requête.
Lire les résultats : ce qui fait bouger les chiffres
- Calcul Python ou calcul Spark. Un notebook Python s’exécute sur un nœud, avec 2 vCores et 16 Go par défaut ; un notebook Spark exécute un driver et des executors issus d’un pool. Les comparer revient à comparer le matériel autant que les moteurs : notez les deux, et recommencez avec des cœurs équivalents quand c’est possible.
- Native Execution Engine. Le NEE accélère les opérateurs Spark pris en charge et revient silencieusement à la JVM pour les autres. Vérifiez le plan (
*Transformer,NativeFileScan) plutôt que de vous fier au nom d’une activité. - Exécution de notebook à froid ou à chaud. Un notebook Python qui ne trouve pas de place dans le live pool de Fabric peut mettre jusqu’à trois minutes à démarrer ; s’il en trouve une, il démarre en quelques secondes. Cette variation se retrouve dans la durée de l’activité, pas dans le temps de traitement du moteur. Dans ce pilote, la première exécution réussie du runner a pris 1 min 21 s, les suivantes 50 et 51 s.
- Cache et mémoire. Relire les mêmes fichiers profite du cache de pages du système d’exploitation, des caches de métadonnées propres à chaque moteur et du cache intelligent de Spark. Une première et une cinquième exécution mesurent des choses différentes ; publiez les deux.
- Lazy ou immédiat. pandas exécute chaque étape dès qu’elle est appelée. L’API lazy de Polars et Spark planifient d’abord et exécutent au collect ou à une action. Chronométrer par étape force l’exécution à chaque étape et pénalise les moteurs lazy ; un chronométrage de bout en bout, non.
- Matérialisation par une action dans Spark.
df.filter(...)rend la main immédiatement parce que rien ne s’est exécuté. Un temps Spark qui ne se termine pas parcount(),collect()ou une écriture mesure la planification, pas le traitement. - Concurrence pour des ressources partagées. Les activités d’une même capacité, les enfants d’un même notebook runner et les jobs d’autres utilisateurs partagent des ressources. Deux activités qui se chevauchent dans le temps peuvent se ralentir mutuellement.
- Exécutions répétées et variabilité statistique. Dans ce pilote, les durées des activités Spark ont varié de plus d’une minute entre deux exécutions du même notebook. Une exécution isolée décrit un instant ; des médianes sur au moins cinq exécutions décrivent le moteur.
Validation
Chaque exécution produit une signature du résultat. Le nombre de lignes, le nombre total de courses et un hachage de chaque groupe avec ses noms de zone et son nombre de courses doivent correspondre exactement d’un moteur à l’autre. Les totaux monétaires doivent concorder au centime et les moyennes à une tolérance relative de 1e-9, car les moteurs additionnent les nombres à virgule flottante dans des ordres différents. Une exécution discordante est marquée VALIDATION_FAILED et son temps est exclu. Les échecs sont conservés comme résultats : un moteur qui manque de mémoire, qui échoue ou que la limite de sécurité de pandas écarte est signalé comme tel, sans être retiré en silence.
Dans le pilote, pandas et Polars ont concordé sur tous les contrôles : nombre de lignes, recettes, pourboires et checksum SHA-256 de la sortie complète.
Éléments de preuve
| Élément | Valeur |
|---|---|
| Jeu de données | Enregistrements de courses des taxis jaunes NYC TLC, 2025 ; jeu S : trois fichiers Parquet |
| Lignes | 11 198 026 enregistrements bruts ; 1 240 lignes agrégées |
| Totaux en sortie | Recettes 287 431 793,68 $ ; pourboires 31 903 631,09 $ |
| Moteurs dont les temps de traitement sont publiés | pandas, Polars |
| Moteurs exécutés dans le pipeline | pandas, Polars, DuckDB, PySpark, Spark SQL, PySpark avec NEE |
| Répétitions | 1 exécution par moteur (pilote) |
| Validation | Checksums SHA-256 identiques pour pandas et Polars |
| Espace de travail et pipeline | ws_fabric_engine_benchmark, pl_fabric_engine_benchmark |
| Exécutions du pipeline présentées | 11 novembre 2026 |
| Capacité Fabric | Non relevée dans les éléments publiés |
| Calcul du notebook Python | Non relevé dans les éléments publiés |
| Runtime et pool Spark | Non relevés dans les éléments publiés |
| Exécution native | Une activité PySpark NEE distincte s’est exécutée ; aucune preuve au niveau du plan n’est encore publiée |
Un benchmark Delta Lake (lecture, append, MERGE, UPDATE, DELETE) est prévu comme expérience distincte. Les moteurs ne prennent pas en charge les mêmes opérations Delta : mêler Delta à cette comparaison la rendrait injuste.
Optimiser l’orchestration des notebooks Microsoft Fabric sans session tags
Le constat le plus utile du pilote ne portait pas sur les moteurs. Il portait sur la façon dont le pipeline démarrait les notebooks Python.
La conception d’origine : une activité de pipeline par moteur
La première version du pipeline exécutait un notebook de préparation, puis une activité Notebook par moteur, l’une après l’autre : Benchmark_Pandas, Benchmark_Polars et Benchmark_DuckDB (chacune appelant nb_fabric_engine_python avec un paramètre engine différent), puis les trois activités Spark.
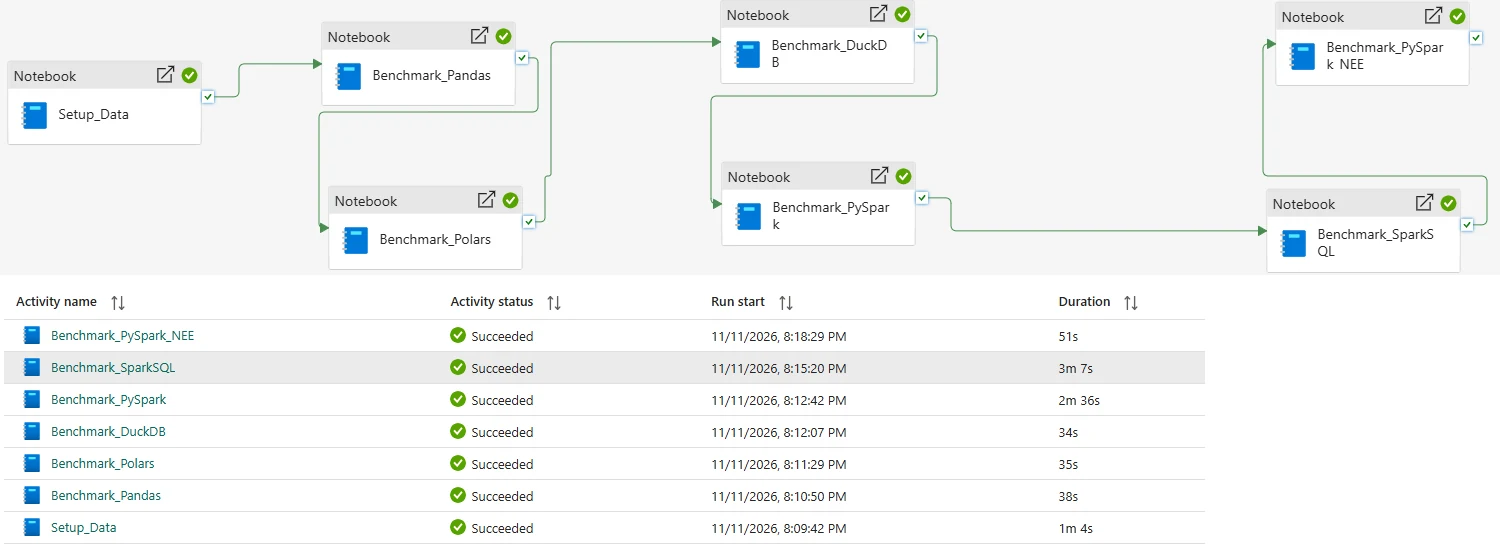
Chaque activité Python a duré de 34 à 38 secondes. Une exécution mesurée de pandas ou de Polars sur le jeu S représente environ 2,5 secondes de travail du moteur : sur de petites données, l’essentiel d’une activité de ce type est donc le coût d’exécution d’un notebook en tant qu’activité de pipeline, payé trois fois.
Le changement : un notebook runner qui appelle un notebook enfant par moteur
Nous avons ajouté un notebook parent Python, nb_fabric_benchmark_runner. Il appelle le notebook de benchmark existant une fois par moteur avec notebookutils.notebook.runMultiple(), en passant à chaque fois un argument engine différent, et échoue si un enfant échoue. Dans le pipeline, il s’exécute sur sa propre branche après Setup_Data, et les trois activités Python autonomes sont passées à Inactive.
- Activités séparéesPipeline d'origine
- Setup_Data
- Benchmark_PandasActivité de 35 s
- Benchmark_PolarsActivité de 34 s
- Benchmark_DuckDBActivité de 35 s
- Activités SparkDémarrent après DuckDB, environ 110 s après la préparation
- Notebook runnerPipeline actuel
- Setup_Data
- benchmark_runnerActivité de 51 s ; notebook Python, runMultiple()
- Enfant pandas
- Enfant Polars
- Enfant DuckDB
- en parallèleActivités SparkDémarrent 2 s après la préparation
Un runner de ce type est court. Les valeurs ci-dessous sont indicatives, ce n’est pas une copie de notre notebook ; dataset_scale et run_count proviennent de la cellule de paramètres du runner :
# Fabric Python notebook (the runner). Children must also be Python notebooks.
from time import perf_counter
from notebookutils.common.exceptions import RunMultipleFailedException

dag = {
    "activities": [
        {
            "name": f"benchmark_{engine}",
            "path": "nb_fabric_engine_python",           # the existing benchmark notebook
            "args": {"engine": engine, "dataset_scale": dataset_scale, "run_count": run_count},
            "timeoutPerCellInSeconds": 1800,              # default is 90 seconds per cell
        }
        for engine in ["pandas", "polars", "duckdb"]
    ],
    "concurrency": 1,  # run children one at a time while they are being timed
}

notebookutils.notebook.validateDAG(dag)  # catches structural and compute-type errors early
start = perf_counter()
try:
    results = notebookutils.notebook.runMultiple(dag)
except RunMultipleFailedException as error:
    results = error.result
print(f"Runner wall time: {perf_counter() - start:.2f} s")

failures = {name: str(info["exception"]) for name, info in results.items() if info["exception"] is not None}
if failures:
raise RuntimeError(f"Benchmark failures: {failures}")Deux réglages comptent pour un benchmark. concurrency vaut par défaut trois fois le nombre de cœurs CPU du nœud : sans lui, les enfants s’exécutent en même temps et leurs temps de moteur incluent la charge des autres. timeoutPerCellInSeconds vaut par défaut 90 secondes, ce qu’un jeu de données plus gros dépassera.
Ce qu’ont montré les exécutions du pipeline
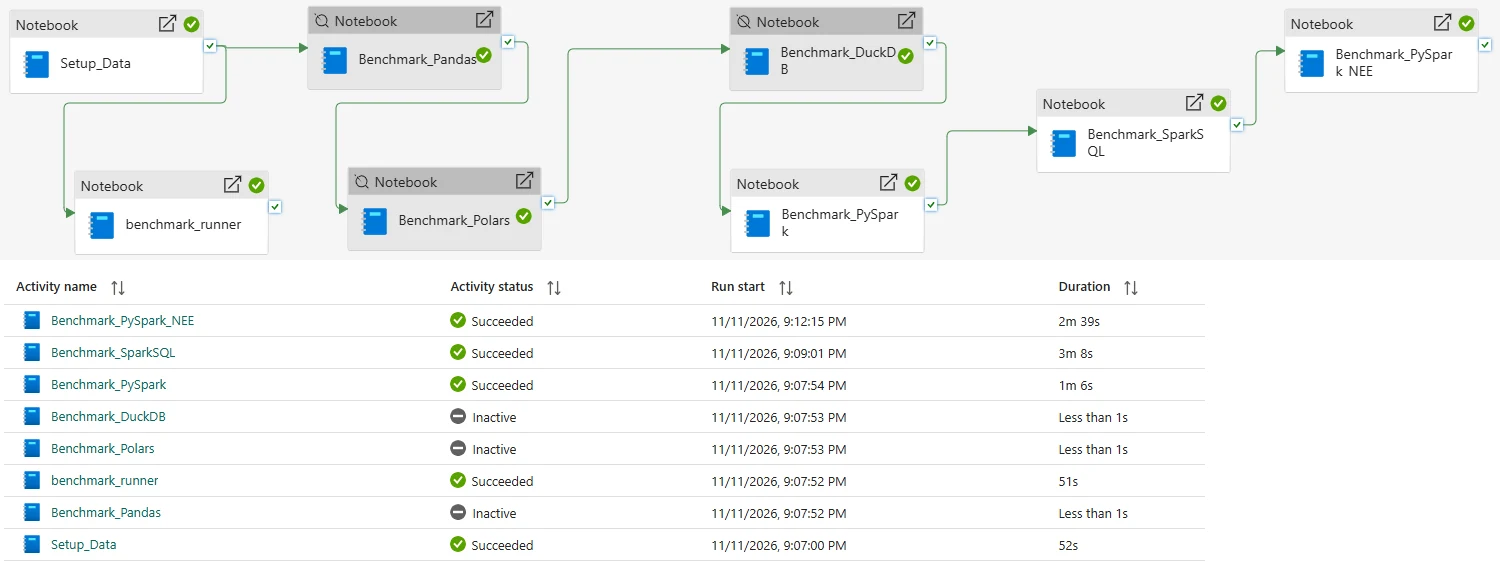
Trois exécutions du pipeline du 11 novembre 2026 retracent le changement. L’exécution B est une exécution de transition dans laquelle le runner et les activités autonomes ont tourné en même temps : ses durées d’activité ont donc été mesurées sous charge partagée.
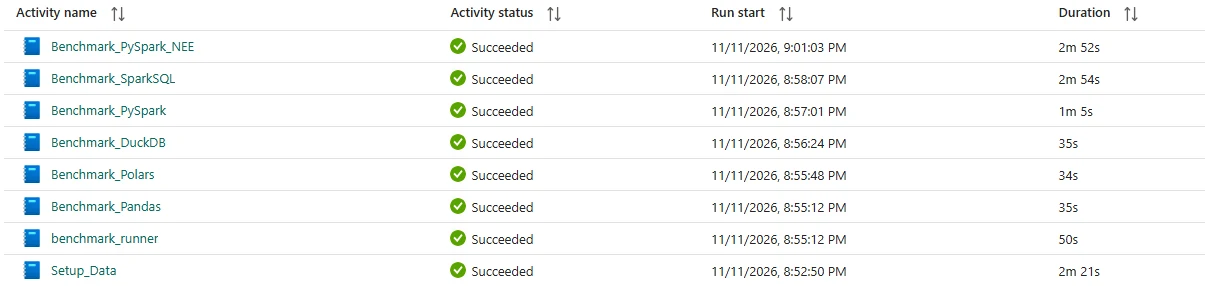
| Exécution A : activités séparées | Exécution B : les deux | Exécution C : runner seul | |
|---|---|---|---|
| pandas, Polars, DuckDB autonomes | 38 s, 35 s, 34 s | 35 s, 34 s, 35 s | Inactives |
| Somme des trois | 107 s | 104 s | — |
benchmark_runner |
Absent du pipeline | 50 s, en même temps que les activités autonomes | 51 s |
| Démarrage de la chaîne Spark après la préparation | Environ 116 s plus tard | Environ 110 s plus tard | Environ 2 s plus tard |
| PySpark, Spark SQL, PySpark NEE | 2m 36s, 3m 7s, 51s | 1m 5s, 2m 54s, 2m 52s | 1m 6s, 3m 8s, 2m 39s |
| Temps total réel du pipeline (déduit) | Environ 9 min 38 s | Environ 11 min 5 s | Environ 7 min 54 s |
Les lignes déduites sont calculées à partir des heures de début et des durées en secondes entières du tableau des activités ; elles sont donc précises à quelques secondes près et ne sont pas des durées de pipeline mesurées séparément.
Ce que signifie le 51 %, et ce qu’il ne signifie pas
Les 51 secondes du runner représentent environ 51 % de moins que la somme des durées des trois activités séparées (104 secondes). C’est la seule comparaison que ces exécutions permettent directement, avec trois réserves :
- Ce n’est pas une comparaison du temps total réel du pipeline. Dans le pipeline d’origine, les trois activités s’exécutaient l’une après l’autre : leur somme est donc proche du temps qu’elles ont occupé (107 secondes entre le début de Pandas et la fin de DuckDB dans l’exécution B). Un pipeline qui exécuterait les trois activités en parallèle durerait à peu près autant que la plus lente, pas 104 secondes. Nous n’avons pas exécuté cette variante ; nous ne pouvons donc pas dire que le runner fait mieux.
- Elle n’isole pas la réutilisation du runtime. Les notebooks enfants appelés avec
runMultiple()s’exécutent dans la session de l’appelant et partagent son calcul ; Microsoft documente que l’API « utilise une implémentation multithread au sein d’une session Spark, ce qui signifie que les exécutions de notebooks référencés partagent les ressources de calcul ». Démarrer une session de notebook au lieu de trois est l’explication plausible de la durée plus courte du runner, mais nous n’avons relevé séparément ni le démarrage de la session, ni la durée de chaque enfant, ni leur chevauchement : la part du gain due aux démarrages de session évités n’est pas mesurée. - Elle compare des exécutions différentes dans des conditions différentes. Les durées autonomes de l’exécution B ont été mesurées pendant que le runner tournait aussi, et le runner de l’exécution C a tourné en même temps que PySpark. Deux exécutions dans une même soirée ne font pas une distribution.
L’effet au niveau du pipeline est plus facile à voir, et ce n’est pas le 51 %. Dans les exécutions A et B, les activités Spark ont attendu environ 110 à 116 secondes la chaîne Python ; dans l’exécution C, elles ont démarré 2 secondes après la préparation, parce que les benchmarks Python sont passés sur une branche parallèle. La durée cumulée des activités Spark était similaire dans les trois exécutions (394, 411 et 413 secondes) : le pipeline plus court de la dernière exécution reflète donc surtout cette attente supprimée, pas des moteurs plus rapides. Les activités Spark prises une à une ont beaucoup plus varié que le runner : l’activité NEE a duré 51 secondes dans une exécution et plus de 2,5 minutes dans les deux autres.
Les types de calcul du parent et des enfants doivent correspondre
Le premier runner était un notebook Spark. La validation de son DAG a échoué avant l’exécution du moindre enfant :
ChildNotebook compute type JupyterCompute does not match to main notebook compute type SparkComputeJupyterCompute désigne le notebook Python (l’enfant, nb_fabric_engine_python) ; SparkCompute, le notebook Spark qui l’appelait. Un notebook référencé s’exécute sur le calcul de l’appelant, et Fabric vérifie que les types de calcul du parent et de l’enfant correspondent avant d’exécuter quoi que ce soit. La solution a été de transformer le runner en notebook Python, ce que Microsoft documente comme pris en charge : les notebooks Python peuvent exécuter par référence d’autres notebooks Python avec notebookutils.notebook.run() ou runMultiple(). Appelez d’abord validateDAG() et cette erreur apparaîtra en une seconde, pas au bout d’une longue exécution.
La règle se généralise : regroupez les notebooks enfants par type de calcul. Des enfants Python sous un runner Python, des enfants Spark sous un runner Spark (ou comme activités de pipeline distinctes). C’est pourquoi les moteurs Spark de ce pipeline sont restés des activités à part entière.
Quand l’orchestration de notebook à notebook aide
- De nombreux notebooks courts dont le démarrage de session pèse lourd dans chaque activité, comme ici les activités Python de 34 à 38 secondes qui faisaient 2,5 secondes de travail.
- Le même notebook exécuté avec des paramètres différents (un moteur, une table, une date) : un enfant paramétré et un DAG d’arguments.
- Des enfants avec le même type de calcul et le même lakehouse par défaut. Une exécution par référence est bloquée si l’enfant déclare un lakehouse par défaut différent de celui du parent.
- Quand une activité de pipeline est la bonne unité de supervision et de nouvelle tentative, le runner levant une erreur si un enfant a échoué.
Quand elle risque de ne pas aider
- Des enfants de longue durée. Si chaque enfant tourne vingt minutes, quelques secondes de démarrage de session ne sont que du bruit, et vous perdez pour rien la visibilité par activité dans le pipeline.
- Des enfants qui se disputent un même nœud. Les enfants partagent le calcul du runner. Sur un notebook Python de 2 vCores par défaut, trois enfants gourmands en mémoire exécutés en même temps peuvent être plus lents que trois activités séparées, ou manquer de mémoire ensemble.
- Des types ou tailles de calcul mélangés. Des enfants Spark et Python ne peuvent pas partager un runner, et chaque enfant reçoit la taille de nœud du runner.
- Un contrôle par activité dans le pipeline. Des activités séparées donnent à chaque notebook sa propre stratégie de nouvelle tentative, son délai d’expiration, ses conditions de dépendance et son statut dans le hub de surveillance (Monitoring hub). Un runner déplace cette logique dans Python.
- Des notebooks Spark qui pourraient partager une session autrement. Pour les activités Spark, le mode haute concurrence pour les pipelines et les session tags sont le mécanisme documenté de partage de session ; ils n’ont pas été utilisés ici et relèvent d’une autre expérience.
Comment mesurer la différence
Pour transformer cette observation en résultat contrôlé, exécutez le même pipeline dans chaque conception, avec le même jeu de données et la même capacité :
- Variantes : activités séparées en séquence, activités séparées en parallèle, et un runner avec
concurrency: 1(et, séparément, avec uneconcurrencynon restreinte). - Exécutions : au moins cinq par variante, en alternant l’ordre des variantes pour répartir équitablement les effets de l’heure de la journée.
- Relevez trois chiffres par exécution : la durée de chaque activité dans l’onglet Output, le temps total réel du pipeline et, dans le runner, la durée de chaque enfant (chronométrez chaque activité de
runMultiple, ou faites renvoyer ses temps par chaque enfant avecnotebookutils.notebook.exit()). - Relevez le démarrage de la session de chaque variante dans le Monitoring hub, pour que la réutilisation des sessions soit mesurée et non déduite.
- Comparez des médianes avec minimum et maximum, métrique par métrique. Ne combinez jamais durée d’activité, temps total réel et temps de traitement du moteur en un seul score.
Le guide sur le démarrage des notebooks montre comment séparer le temps de file d’attente, de session et d’exécution, et la supervision des pipelines et notebooks Fabric indique où chaque durée est remontée. Pour passer des arguments comme engine, voir les paramètres de notebook dans Fabric ; pour l’arbitrage plus général, pipelines ou notebooks dans Fabric.
Faire ce benchmark sur votre propre capacité Fabric
Les plages de Microsoft vous disent où regarder. Vos propres chiffres vous disent quoi choisir. La méthode ci-dessous compare Polars, DuckDB et pandas dans un notebook Python avec PySpark et Spark SQL dans un notebook Spark, sur les mêmes fichiers et la même charge de travail.
Que tester
Générez (ou copiez) la même entrée en plusieurs tailles, par exemple ~100 Mo, ~1 Go et ~10 Go compressés, et davantage si votre capacité le permet. Exécutez un pipeline réaliste, pas une opération isolée :
- lire du Parquet ;
- filtrer ;
- joindre une dimension ;
- regrouper et agréger ;
- trier ;
- écrire le résultat.
Ne faites pas un benchmark sur un simple count() : Spark peut répondre à certains comptages à partir des métadonnées, Polars et DuckDB peuvent ignorer l’essentiel des données, et rien de tout cela ne dit quoi que ce soit des jointures ou des écritures.
Que relever
- Le temps de démarrage de la session, séparément de l’exécution (barre d’état du notebook ou Monitoring hub).
- Le temps d’exécution de tout le pipeline, écriture comprise.
- Le pic de mémoire du processus pour les moteurs mono-nœud ; la mémoire des executors et le spill pour Spark (voir les réserves plus bas).
- La sortie : nombre de fichiers et un checksum (nombre de lignes et totaux) prouvant que tous les moteurs ont produit le même résultat.
- Succès, erreur ou OOM, pour chaque exécution.
- La répétabilité : au moins cinq exécutions par moteur et par taille, publiées sous forme de médiane avec minimum et maximum.
- La durée d’activité et le temps total réel du pipeline, séparément du temps de traitement du moteur, si le benchmark tourne dans un pipeline.
- L’environnement : SKU de la capacité, vCores du notebook Python ou pool et taille de nœud Spark, runtime Spark, activation ou non du NEE, versions des bibliothèques, format source et taille d’entrée compressée.
Règles d’un benchmark équitable
- Mêmes fichiers source, mêmes colonnes et filtres, même sémantique de sortie, vérifiée par checksum.
- Séparez la première exécution d’une session des suivantes ; les caches (celui de DuckDB, le cache intelligent de Spark, celui du système d’exploitation) favorisent les lectures répétées, et une lecture vraiment à froid est difficile à garantir.
- Donnez aux moteurs des cœurs comparables quand c’est possible : un notebook Python de 2 vCores face à un nœud Spark de 8 vCores compare du matériel, pas des moteurs. Recommencez avec le notebook Python à 8 vCores (
%%configure). - Mesurez le démarrage séparément de l’exécution.
- Exécutez chaque cas plusieurs fois et publiez la médiane, en conservant toutes les exécutions. Ne choisissez pas la plus rapide.
- N’incluez pandas qu’aux tailles qu’il peut supporter, et ne faites jamais un benchmark en faisant tomber volontairement une capacité partagée.
Harness pour notebook Python : Polars, DuckDB, pandas
Exécutez ceci dans un notebook Python auquel un lakehouse par défaut est attaché. Il génère des commandes et des clients synthétiques avec DuckDB, puis exécute la même charge de travail cinq fois par moteur, en échantillonnant le pic de mémoire du processus et en écrivant une ligne JSON par exécution. pandas est ignoré au-delà de PANDAS_MAX_BYTES, si bien que le benchmark n’épuise jamais volontairement la mémoire. Augmentez ORDER_ROWS et changez SIZE_LABEL pour chaque taille, et notez la taille compressée affichée plutôt que le nombre de lignes. Les API des bibliothèques évoluent d’une version à l’autre (DuckDB 2.0 a par exemple retiré fetchone() des relations) : c’est pourquoi le harness enregistre les versions et s’en tient à des appels établis de longue date.
# Fabric Python notebook (pure Python kernel), default lakehouse attached.
# Cell 1: configuration and synthetic data. Same files are read by every engine.
import json, os, platform, statistics, threading, time
from datetime import date

BASE = os.environ.get("BENCH_BASE", "/lakehouse/default/Files/engine-bench")
SIZE_LABEL = "s1"                 # one folder per dataset size: s1, s2, s3 ...
ORDER_ROWS = 2_000_000            # raise step by step: compressed size is what you report
CUSTOMERS = 200_000
RUNS = 5                          # report the median, keep every run
ENGINES = ["polars", "duckdb", "pandas"]  # one engine per fresh kernel gives clean peak-memory numbers
PANDAS_MAX_BYTES = 500 * 1024**2  # skip pandas above this compressed input size
DATA = f"{BASE}/data/{SIZE_LABEL}"
RESULTS = f"{BASE}/results/results.jsonl"

import duckdb

def generate():
    os.makedirs(DATA, exist_ok=True)
    con = duckdb.connect()
    con.execute(f"""
        COPY (SELECT i AS order_id,
                     (hash(i) % {CUSTOMERS})::INTEGER AS customer_id,
                     DATE '2024-01-01' + (hash(i * 7) % 730)::INTEGER AS order_date,
                     ['open', 'shipped', 'cancelled', 'returned'][1 + (hash(i * 13) % 4)::INTEGER] AS status,
                     round((hash(i * 31) % 100000) / 100.0, 2) AS amount
              FROM range({ORDER_ROWS}) t(i))
        TO '{DATA}/orders' (FORMAT parquet, PER_THREAD_OUTPUT true, OVERWRITE_OR_IGNORE true)""")
    con.execute(f"""
        COPY (SELECT i::INTEGER AS customer_id,
                     ['north', 'south', 'east', 'west'][1 + (i % 4)::INTEGER] AS region,
                     ['retail', 'smb', 'enterprise'][1 + (i % 3)::INTEGER] AS segment
              FROM range({CUSTOMERS}) t(i))
        TO '{DATA}/customers' (FORMAT parquet, PER_THREAD_OUTPUT true, OVERWRITE_OR_IGNORE true)""")

def folder_bytes(path):
    return sum(os.path.getsize(os.path.join(root, f)) for root, _, files in os.walk(path) for f in files)

if not os.path.exists(f"{DATA}/orders"):
    generate()
INPUT_BYTES = folder_bytes(f"{DATA}/orders") + folder_bytes(f"{DATA}/customers")
print(f"compressed input: {INPUT_BYTES / 1024**2:.1f} MB")

# Cell 2: one workload, three engines. Filter, join, aggregate by month, sort, write Parquet.
SINCE = date(2025, 1, 1)
STATUSES = ["shipped", "returned"]

def run_polars(out):
    import polars as pl
    orders = pl.scan_parquet(f"{DATA}/orders/*.parquet")
    customers = pl.scan_parquet(f"{DATA}/customers/*.parquet")
    result = (orders.filter(pl.col("status").is_in(STATUSES) & (pl.col("order_date") >= SINCE))
              .join(customers, on="customer_id", how="inner")
              .group_by("region", "segment", pl.col("order_date").dt.truncate("1mo").alias("order_month"))
              .agg(pl.col("amount").sum().alias("revenue"), pl.len().alias("orders"))
              .sort("region", "segment", "order_month")
              .collect())
    result.write_parquet(f"{out}/part-0.parquet")

def run_duckdb(out):
    con = duckdb.connect()
    con.execute(f"""
        COPY (SELECT c.region, c.segment, date_trunc('month', o.order_date) AS order_month,
                     sum(o.amount) AS revenue, count(*) AS orders
              FROM read_parquet('{DATA}/orders/*.parquet') o
              JOIN read_parquet('{DATA}/customers/*.parquet') c USING (customer_id)
              WHERE o.status IN ('shipped', 'returned') AND o.order_date >= DATE '{SINCE}'
              GROUP BY ALL ORDER BY region, segment, order_month)
        TO '{out}/part-0.parquet' (FORMAT parquet)""")

def run_pandas(out):
    import pandas as pd
    orders = pd.read_parquet(f"{DATA}/orders")
    orders["order_date"] = pd.to_datetime(orders["order_date"])
    orders = orders[orders["status"].isin(STATUSES) & (orders["order_date"] >= pd.Timestamp(SINCE))]
    joined = orders.merge(pd.read_parquet(f"{DATA}/customers"), on="customer_id", how="inner")
    joined["order_month"] = joined["order_date"].dt.to_period("M").dt.to_timestamp()
    result = (joined.groupby(["region", "segment", "order_month"], as_index=False)
              .agg(revenue=("amount", "sum"), orders=("amount", "size"))
              .sort_values(["region", "segment", "order_month"]))
    result.to_parquet(f"{out}/part-0.parquet", index=False)

# Cell 3: harness. Wall time, peak process memory (RSS, sampled), output files, a checksum, success or error.
def peak_rss(fn):
    try:
        import psutil
    except ImportError:
        return fn(), None
    proc, peak, done = psutil.Process(), [0], threading.Event()
    def sample():
        while not done.is_set():
            peak[0] = max(peak[0], proc.memory_info().rss)
            time.sleep(0.05)
    sampler = threading.Thread(target=sample, daemon=True)
    sampler.start()
    try:
        return fn(), peak[0]
    finally:
        done.set()
        sampler.join()

def checksum(out):
    row = duckdb.connect().execute(f"SELECT count(*), round(sum(revenue), 2), sum(orders) FROM read_parquet('{out}/*.parquet')").fetchone()
    return {"rows": row[0], "revenue": float(row[1]), "orders": int(row[2])}

def versions():
    import importlib.metadata as md
    found = {}
    for name in ("pandas", "polars", "duckdb", "pyarrow", "deltalake"):
        try:
            found[name] = md.version(name)
        except md.PackageNotFoundError:
            found[name] = None
    return found

def bench(engine, fn):
    if engine == "pandas" and INPUT_BYTES > PANDAS_MAX_BYTES:
        return [{"engine": engine, "status": "skipped", "reason": "input above PANDAS_MAX_BYTES"}]
    runs = []
    for run in range(1, RUNS + 1):
        out = f"{BASE}/out/{SIZE_LABEL}/{engine}/run{run}"
        os.makedirs(out, exist_ok=True)
        for f in os.listdir(out):
            os.remove(os.path.join(out, f))
        start = time.perf_counter()
        try:
            _, rss = peak_rss(lambda: fn(out))
            record = {"status": "ok", "seconds": round(time.perf_counter() - start, 3),
                      "peak_rss_mb": rss and round(rss / 1024**2), "files": len(os.listdir(out)), **checksum(out)}
        except MemoryError as error:
            record = {"status": "oom", "error": repr(error)[:200]}
        except Exception as error:
            record = {"status": "error", "error": repr(error)[:200]}
        runs.append({"engine": engine, "run": run, **record})
    return runs

env = {"kernel": "python", "python": platform.python_version(), "vcores": os.cpu_count(),
       "size": SIZE_LABEL, "input_mb": round(INPUT_BYTES / 1024**2, 1), "libraries": versions()}
os.makedirs(os.path.dirname(RESULTS), exist_ok=True)
with open(RESULTS, "a") as log:
    for engine in ENGINES:
        records = bench(engine, {"polars": run_polars, "duckdb": run_duckdb, "pandas": run_pandas}[engine])
        for record in records:
            log.write(json.dumps({**env, **record}) + "\n")
        ok = [r["seconds"] for r in records if r["status"] == "ok"]
print(engine, "median s:", statistics.median(ok) if ok else None, [r["status"] for r in records])Harness pour notebook Spark : PySpark et Spark SQL
Exécutez ceci dans un notebook Spark attaché au même lakehouse, avec le même SIZE_LABEL. Exécutez-le une fois avec le Native Execution Engine activé et une fois sans, si vous voulez voir son effet sur votre charge.
# Fabric Spark notebook (PySpark kernel), same default lakehouse, same SIZE_LABEL as the Python run.
# Record the session start time separately (notebook status bar or Monitoring hub): it is not part of `seconds`.
import json, os, statistics, time
from pyspark.sql import functions as F

BASE = os.environ.get("BENCH_BASE", "/lakehouse/default/Files/engine-bench")  # local mount, for result files
SPARK_BASE = os.environ.get("BENCH_SPARK_BASE", "Files/engine-bench")          # same folder, as Spark sees it
SIZE_LABEL = "s1"
RUNS = 5
DATA = f"{SPARK_BASE}/data/{SIZE_LABEL}"

def run_dataframe(out):
    orders = spark.read.parquet(f"{DATA}/orders")
    customers = spark.read.parquet(f"{DATA}/customers")
    result = (orders.where(F.col("status").isin("shipped", "returned") & (F.col("order_date") >= F.lit("2025-01-01").cast("date")))
              .join(customers, "customer_id")
              .groupBy("region", "segment", F.trunc("order_date", "month").alias("order_month"))
              .agg(F.sum("amount").alias("revenue"), F.count(F.lit(1)).alias("orders"))
              .orderBy("region", "segment", "order_month"))
    result.write.mode("overwrite").parquet(out)

def run_sql(out):
    spark.read.parquet(f"{DATA}/orders").createOrReplaceTempView("orders")
    spark.read.parquet(f"{DATA}/customers").createOrReplaceTempView("customers")
    spark.sql("""
        SELECT c.region, c.segment, trunc(o.order_date, 'month') AS order_month,
               sum(o.amount) AS revenue, count(*) AS orders
        FROM orders o JOIN customers c USING (customer_id)
        WHERE o.status IN ('shipped', 'returned') AND o.order_date >= DATE '2025-01-01'
        GROUP BY ALL ORDER BY region, segment, order_month
    """).write.mode("overwrite").parquet(out)

def checksum(out):
    row = spark.read.parquet(out).agg(F.count(F.lit(1)), F.round(F.sum("revenue"), 2), F.sum("orders")).first()
    return {"rows": row[0], "revenue": float(row[1]), "orders": int(row[2])}

env = {"kernel": "spark", "spark": spark.version, "size": SIZE_LABEL,
       "native_engine": spark.conf.get("spark.native.enabled", "unset"),
       "default_parallelism": spark.sparkContext.defaultParallelism}
os.makedirs(f"{BASE}/results", exist_ok=True)
with open(f"{BASE}/results/results.jsonl", "a") as log:
    for engine, fn in (("pyspark", run_dataframe), ("spark-sql", run_sql)):
        records = []
        for run in range(1, RUNS + 1):
            out = f"{SPARK_BASE}/out/{SIZE_LABEL}/{engine}/run{run}"
            start = time.perf_counter()
            try:
                fn(out)
                record = {"status": "ok", "seconds": round(time.perf_counter() - start, 3),
                          "files": len([f for f in os.listdir(f"{BASE}/out/{SIZE_LABEL}/{engine}/run{run}") if f.endswith(".parquet")]),
                          **checksum(out)}
            except Exception as error:  # executor OOM surfaces as a failed job, not a MemoryError
                record = {"status": "error", "error": repr(error)[:200]}
            records.append({"engine": engine, "run": run, **record})
            log.write(json.dumps({**env, **records[-1]}) + "\n")
        ok = [r["seconds"] for r in records if r["status"] == "ok"]
        print(engine, "median s:", statistics.median(ok) if ok else None, [r["status"] for r in records])
# Memory: read peak executor memory and spill from the Spark UI (Executors and Stages tabs), not from the driver.Les deux harnesses ajoutent leurs résultats à Files/engine-bench/results/results.jsonl : une seule requête DuckDB compare donc l’ensemble :
import duckdb

duckdb.sql("""
    SELECT size, engine, count(*) FILTER (status = 'ok') AS ok_runs,
           median(seconds) AS median_seconds, max(peak_rss_mb) AS peak_rss_mb,
           any_value(rows) AS rows, any_value(revenue) AS revenue
    FROM read_json_auto('/lakehouse/default/Files/engine-bench/results/results.jsonl')
    GROUP BY ALL ORDER BY size, median_seconds
""").show()Des rows et revenue identiques d’un moteur à l’autre prouvent que vous avez comparé le même travail.
Avant publication, j’ai exécuté le harness Python hors de Fabric avec Python 3.12 et de petites données synthétiques (environ 28 Mo compressés) : Polars, DuckDB et pandas ont produit les mêmes nombres de lignes et les mêmes checksums, la limite de taille de pandas a correctement écarté l’exécution, et la requête de synthèse ci-dessus a fonctionné sur les résultats. Le harness Spark a été compilé et relu, mais pas exécuté hors de Fabric. Il s’agissait de contrôles d’exactitude, pas de résultats de performance ; des temps mesurés sur un portable ne disent rien d’une capacité Fabric, je ne les publie donc pas.
Deux effets sont apparus même dans ce petit test, et vous les verrez aussi dans Fabric :
- La première exécution est plus lente. Les imports, les métadonnées des fichiers et les caches font de l’exécution 1 une exécution à froid. Conservez-la, mais ne comparez pas l’exécution à froid d’un moteur avec l’exécution à chaud d’un autre.
- Le pic de mémoire s’accumule dans un même processus. L’échantillonneur RSS mesure tout le processus du notebook : un moteur qui s’exécute après un autre hérite de ce que le premier a laissé alloué. Pour des mesures de mémoire propres, mettez un seul moteur dans
ENGINESet redémarrez le noyau entre deux moteurs (notebookutils.session.restartPython()).
Réserves sur la mesure de la mémoire
La mémoire d’un processus Python est facile à observer : le harness échantillonne la mémoire résidente (RSS) du processus du notebook, qui inclut la mémoire allouée nativement par Polars et DuckDB. C’est un pic raisonnable pour un seul nœud, même si l’échantillonnage peut manquer des pics très brefs.
La mémoire de Spark ne se résume pas à un chiffre. Elle se trouve dans le driver, dans le tas JVM de chaque executor, hors tas et dans la mémoire native utilisée par le Native Execution Engine, ainsi que dans les fichiers de shuffle et de spill sur disque. Ne présentez pas le RSS du driver comme la consommation mémoire de Spark : il mesure le processus qui travaille le moins. Utilisez plutôt la Spark UI : l’onglet Executors pour le pic de mémoire par executor, et l’onglet Stages pour le spill (mémoire et disque) et les lectures et écritures de shuffle. Comparez si chaque moteur est resté dans ses limites et à quel point il s’en est approché, plutôt que de mettre côte à côte un RSS mono-nœud et un total de cluster comme s’il s’agissait de la même mesure.
Anti-patterns
- Choisir pandas uniquement parce que l’équipe connaît pandas. La familiarité est un vrai facteur de coût, pas un modèle d’exécution.
- Choisir Spark uniquement parce que les données sont dans un Lakehouse. Des données petites et stables se lisent parfaitement depuis un notebook Python.
- Appeler
toPandas()trop tôt. Réduisez d’abord dans Spark. - Comparer le temps d’exécution en ignorant le démarrage, ou le démarrage en ignorant l’exécution.
- Ignorer la mémoire. Le moteur 20 % plus rapide qui manque de mémoire avec deux fois plus de données n’est pas plus rapide.
- Faire le benchmark d’une seule opération, surtout d’un
count(). - Choisir une architecture de production à partir d’un minuscule échantillon.
- Ignorer la croissance. Les 700 Mo d’aujourd’hui sont un point de mesure, pas une taille.
- Ignorer les besoins en fonctionnalités Delta, jusqu’à ce qu’un moteur Python tombe sur une table avec des deletion vectors.
- Ignorer le support. Sachez qui vous appellerez quand le moteur se comportera mal.
- Supposer que la lecture la plus rapide fait le pipeline le plus rapide. Ce sont les jointures et les écritures qui décident de la plupart des exécutions.
- Supposer qu’un seul nœud coûte moins cher. Le coût, ce sont les ressources multipliées par le temps, relances comprises.
- Supposer que Spark passe automatiquement à l’échelle. Le skew, les partitions trop grosses, les broadcasts et les collect vers le driver échouent toujours ; voir le dépannage des performances dans Fabric.
Matrice de recommandations
Recommandation Javi Builds : faites un benchmark de votre charge de travail.
| Situation | Point de départ recommandé |
|---|---|
| Données exploratoires de 100 Mo | Polars ou DuckDB |
| Petit DataFrame attendu par l’écosystème Python | pandas |
| Notebook analytique de 1 à 2 Go | Polars ou DuckDB ; benchmark de Spark mono-nœud s’il devient un pipeline |
| Transformation de production de 10 Go | Benchmark mono-nœud contre Spark ; pencher pour Spark si une croissance est attendue |
| ETL de 100 Go et plus | PySpark ou Spark SQL avec le Native Execution Engine |
| Grosse charge Delta (MERGE, UPDATE, DELETE, maintenance) | Spark |
| Grosses jointures | Spark |
| Exploration de fichiers orientée SQL | DuckDB |
| Travail rapide en DataFrames sur un seul nœud | Polars |
| Petit résultat après une agrégation Spark | pandas |
| Équipe experte en pandas, données qui dépassent un nœud | API pandas sur Spark, puis PySpark natif pour les chemins critiques |
À lire aussi sur Javi Builds
- Microsoft Fabric Runtime 2.0 vs 1.3 vs 1.2 : les versions du runtime Spark, le Native Execution Engine et les risques de migration.
- Accélérer les notebooks Microsoft Fabric : diagnostiquer des notebooks Spark lents.
- Réduire le temps de démarrage des notebooks Fabric : temps de file d’attente, de session et d’exécution.
- Utiliser les session tags dans les pipelines Fabric : le mécanisme de partage de sessions Spark que cette expérience n’a pas utilisé.
- Les paramètres de notebook dans Fabric et la supervision des pipelines et notebooks Fabric.
- La haute concurrence dans Microsoft Fabric : partager des sessions Spark entre notebooks.
- La capacité Microsoft Fabric expliquée : CU, lissage et limitation.
- Les modèles de performance MERGE pour Delta Lake et la maintenance des tables Delta.
- Checklist de performance des notebooks Fabric (en anglais).
- Le hub Data Engineering et le parcours d’apprentissage Microsoft Fabric.
Sources
Microsoft Learn, consulté en novembre 2026 :
- Choosing a notebook kernel in Microsoft Fabric : options de calcul et CU, plages de benchmark, matrice de fonctionnalités Delta Lake (en juin 2026), maturité et support des moteurs, aide à la décision.
- Use Python experience on Notebook : noyaux, calcul par défaut, bibliothèques préinstallées, delta-rs et DuckDB, conseil en cas d’OOM,
%%configure, exécutions par référence entre notebooks Python, temps de démarrage du live pool. - Python notebook runtime and kernel lifecycle : versions des noyaux et dates de fin de support.
- Apache Spark runtime in Fabric et Runtime 2.0 : runtime GA, versions des composants, le benchmark TPC-DS du Native Execution Engine.
- Native execution engine for Fabric Data Engineering : Velox et Gluten, activation, repli, limitations.
- Read and write data with pandas : chemins du Lakehouse et recommandations sur
toPandas(). - Load data into your lakehouse with a notebook : chemins relatifs, ABFS et
/lakehouse/default/utilisés par le benchmark. - Intelligent cache in Microsoft Fabric : pourquoi les lectures suivantes des mêmes fichiers dans Spark sont plus rapides.
- NotebookUtils notebook run and orchestration :
run(),runMultiple(), champs et valeurs par défaut du DAG (concurrence, délai par cellule), calcul partagé, règle du lakehouse par défaut. - Configure high concurrency mode for notebooks in pipelines : session tags et partage de sessions Spark, que cette expérience n’a pas utilisés.
Données du benchmark :
- NYC TLC Trip Record Data : fichiers Parquet mensuels des taxis jaunes et table des zones de taxi.
- Yellow Taxi trip records data dictionary.
Documentation des projets :
- Apache Spark SQL performance tuning : seuil de broadcast, exécution adaptative des requêtes, jointures déséquilibrées.
- Polars streaming engine.
- DuckDB: tuning workloads, traitement plus grand que la mémoire et spill.
- pandas API on Spark.
Ce contenu vous a-t-il été utile ?
Que pourrions-nous améliorer ?
Merci — cela m’aide à améliorer Javi Builds.
Continuer à apprendre
- Aide-mémoirePerformance des notebooks FabricDiagnostiquez et améliorez les performances des notebooks Microsoft Fabric en distinguant les goulots d’étranglement liés au démarrage de la session Spark, au scan des données, au shuffle, au skew, à la pression sur le driver, à la concurrence et à l’écriture.Ouvrir l’aide-mémoire
- Feuille de routeFabric Performance at ScaleComparez pandas, Polars, DuckDB, PySpark et Spark SQL dans Microsoft Fabric selon la vitesse, la mémoire, le volume de données, la prise en charge de Delta et la montée en charge, avec les résultats mesurés d'un vrai benchmark dans Fabric et des conseils pratiques pour choisir le bon moteur.Voir la feuille de route
Que devrais-je créer ensuite ?
Je développe Javi Builds autour des problèmes concrets rencontrés par les data engineers. Dites-moi quel sujet vous aimeriez voir ensuite.
Restez au courant
Recevez uniquement les nouvelles de Javi Builds qui vous intéressent.
Consultez votre boîte de réception
Je vous ai envoyé un lien de confirmation. Votre abonnement sera actif après confirmation.