Microsoft Fabric
Reducir el tiempo de inicio de los notebooks de Fabric
Diagnostica la adquisición de sesiones Spark de Microsoft Fabric y reduce el tiempo de inicio evitable mediante pools, entornos y reutilización compatibles.
En este artículo
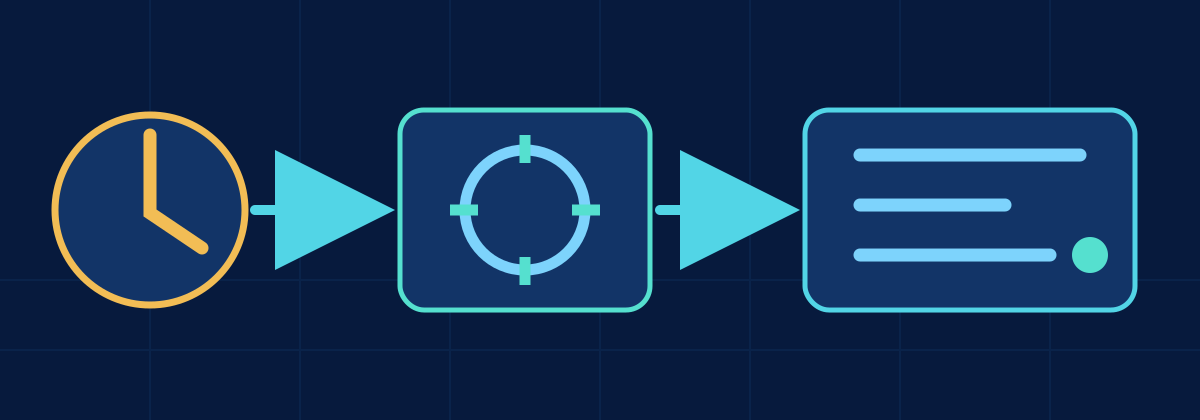
Respuesta corta: el tiempo que pasa antes de que se ejecute tu código tiene dos causas distintas, y una tercera fase suele confundirse con ellas. El tiempo de cola es la espera de capacidad. El inicio de sesión es Fabric creando o adjuntando una sesión de Spark, incluidas las bibliotecas del entorno. La ejecución del código empieza con tu primera celda. Mide cuál creció antes de cambiar nada: solo los ajustes de pool, entorno y reutilización de este artículo actúan sobre el inicio de sesión.
- Inicio de la actividadPipeline, programación o ejecución interactiva
- CapacidadTiempo de colaLos trabajos de pipeline y programados esperan mientras los núcleos de Spark están ocupados
- Este artículoInicio de sesiónStarter pool o clúster a petición, entorno, bibliotecas
- Tu notebookEjecución del códigoDe la primera a la última celda
Problema
El código Spark de un notebook termina en menos de un minuto, pero la actividad del pipeline tarda mucho más. Algunas ejecuciones obtienen una sesión enseguida y otras esperan. Aumentar los executors no arregla el tiempo anterior al inicio de los jobs Spark, así que primero separa la adquisición de sesión de la ejecución.
Tiempo de cola, inicio de sesión y ejecución del código
Tiempo de cola
Cuando todos los núcleos de Spark de la capacidad están en uso, los notebooks lanzados por pipelines o por el programador, y las definiciones de trabajos de Spark, se ponen en cola (primero en entrar, primero en salir) y se reintentan automáticamente. Las entradas de la cola caducan 24 horas después de su admisión. Las ejecuciones interactivas y los notebooks enviados mediante la API pública no se ponen en cola: fallan con TooManyRequestsForCapacity (HTTP 430). Los ajustes de pool y de bibliotecas no reducen el tiempo de cola; la capacidad, la programación y las cargas que compiten, sí. Si la cola es habitual, sigue el runbook de saturación de capacidad de Fabric (en inglés) y dimensiona a partir del uso medido con el Fabric Capacity Planner (en inglés).
Inicio de sesión
- Los starter pools están precalentados y los gestiona Microsoft. Sin bibliotecas adicionales ni propiedades de Spark personalizadas, una sesión suele iniciarse en 5 a 10 segundos, pero es de mejor esfuerzo: la capacidad precalentada no está garantizada y una alta demanda regional puede recurrir a un clúster a petición.
- El cómputo personalizado (tamaño de nodo, pools personalizados, algunas configuraciones de red) puede impedir la ruta precalentada e iniciar un clúster a petición.
- Las bibliotecas del entorno dependen del modo de publicación: en modo completo, la instantánea de bibliotecas se despliega al iniciar la sesión y suele añadir de 1 a 3 minutos; en modo rápido, se instalan al ejecutarse la primera celda, por lo que el retraso parece «código» lento.
- Los custom live pools mantienen clústeres dedicados en caliente durante un horario que tú defines, con las bibliotecas del entorno preinstaladas, así que las sesiones se inician en unos 5 segundos durante esa ventana. El cómputo en caliente consume capacidad: resérvalo para trabajos sensibles a la latencia.
La información de inicio de sesión, en los detalles de la sesión, muestra si la sesión vino de un starter pool o de un clúster a petición, y por qué no se usó la ruta rápida.
Ejecución del código
La ejecución empieza en la primera celda. El tiempo de un %pip install en línea cuenta aquí, igual que una instalación en modo rápido. Todo lo demás (lecturas, shuffles, escrituras) corresponde a acelerar el propio notebook.
Sesiones en caliente, caducidad y reutilización
Una sesión interactiva permanece en caliente hasta que caduca; por defecto, 20 minutos, ajustable en la configuración de Spark del área de trabajo. La siguiente ejecución tras la caducidad vuelve a pagar el inicio.
Los pipelines pueden reutilizar una sesión en curso en lugar de iniciar una por notebook. Con la alta concurrencia habilitada para pipelines, las actividades compatibles que comparten un session tag se unen a una misma sesión; por defecto, hasta cinco notebooks la comparten, y el límite puede elevarse a 50 (en inglés).
Cuidado con encadenar notebooks innecesariamente. Un pipeline que llama a diez notebooks cortos como diez actividades separadas puede pagar diez veces la cola y el inicio. Agrupa las actividades compatibles con un mismo session tag, fusiona los notebooks que siempre se ejecutan juntos o llámalos desde un notebook orquestador: Microsoft documenta que un notebook iniciado con notebook.run() (NotebookUtils, antes MSSparkUtils) se ejecuta en el pool de Spark del notebook que lo llama. runMultiple() ejecuta varios en paralelo y figura como versión preliminar en esa documentación.
Recomendaciones prácticas
Mide el inicio por separado. Registra el comienzo de la actividad del pipeline, el momento en que la sesión está lista si está disponible, el inicio del primer job Spark y el fin del notebook. Usa los detalles de sesión o la experiencia de monitoreo para identificar el origen y el motivo de la demora. Sin esa separación, una primera lectura lenta puede confundirse con un inicio lento.
Prefiere la configuración predeterminada compatible con starter pools cuando satisfaga la carga. No personalices de antemano el tamaño de nodo ni las propiedades Spark. Una configuración personalizada puede ser correcta para un job pesado y sostenido, pero quizá cambie una ejecución más rápida por una adquisición más larga. Evalúa la duración total y la fiabilidad.
Mueve las dependencias estables y compartidas a un Fabric Environment gobernado en lugar de ejecutar %pip install en cada notebook. Elige el comportamiento de publicación del entorno según la velocidad de desarrollo, la reproducibilidad y las necesidades de sesión. Evita importar paquetes pesados que el notebook nunca usa. El trabajo de los paquetes forma parte del costo de ejecución aunque no aparezca como una etapa Spark.
Ejemplo de medición
El código del notebook no puede medir el tiempo anterior al inicio de su propio proceso, pero sí marcar el primer punto ejecutable y cada etapa posterior. Combina esos registros con las marcas de tiempo del pipeline y de la sesión Fabric.
from datetime import datetime, timezone
from time import perf_counter

notebook_started_at = datetime.now(timezone.utc).isoformat()
clock = perf_counter()

print({"event": "notebook_code_started", "at": notebook_started_at})

orders = (
    spark.read.table("SalesLakehouse.silver.orders")
    .select("order_id", "order_date", "amount")
    .where("order_date >= '2026-10-01'")
)

row_count = orders.count()
print({
    "event": "input_materialized",
    "elapsed_seconds": round(perf_counter() - clock, 3),
    "rows": row_count,
})Si el tiempo entre el pipeline y el inicio del código es alto, pero el intervalo entre el código y la primera acción es normal, investiga la adquisición y la inicialización del entorno. Si el notebook empieza rápido pero la primera acción tarda, revisa el acceso a la tabla, el listado de archivos, la creación del plan y el job Spark.
Crea una tabla pequeña de comparación con varias ejecuciones representativas:
| Ejecución | Origen de la sesión | Adquisición | Primera acción | Trabajo restante |
|---|---|---|---|---|
| Referencia | Starter o reutilizada | medido | medido | medido |
| Lenta | Bajo demanda o personalizada | medido | medido | medido |
No inventes valores objetivo. Establece una referencia para el workspace, la capacidad, la configuración y el intervalo. La demanda regional y el uso concurrente de capacidad pueden cambiar los resultados.
Errores frecuentes
- Ajustar transformaciones Spark cuando la demora ocurre antes del primer job.
- Suponer que el inicio mediante starter pool está garantizado en cada ejecución.
- Añadir cálculo o propiedades personalizadas sin medir su costo de adquisición.
- Instalar los mismos paquetes en línea en cada notebook.
- Tratar un live pool como una reducción gratuita de latencia sin considerar el consumo de capacidad.
- Usar session tags únicos que impiden reutilizar una sesión entre actividades relacionadas del pipeline.
- Forzar cargas incompatibles a compartir recursos y perder fiabilidad o aislamiento.
- Medir una ejecución y presentarla como benchmark estable.
Lista de comprobación del inicio
- ¿El notebook estuvo en cola? Revisa el tiempo de cola antes que nada.
- ¿Se creó una sesión nueva o se adjuntó a una sesión en caliente o compartida?
- ¿La sesión vino de un starter pool o de un clúster a petición, y qué motivo da la información de inicio de sesión?
- ¿Cambió o se volvió a publicar el entorno, y qué modo de publicación de bibliotecas usa?
- ¿Se instalan bibliotecas personalizadas con
%pipen cada ejecución? - ¿Está disponible la reutilización de sesión: alta concurrencia habilitada, ajustes compatibles, un session tag común?
- ¿Se invocan muchos notebooks cortos como actividades separadas?
- ¿Es la concurrencia en la capacidad el verdadero cuello de botella?
Si la adquisición es normal, lleva la investigación a la primera acción de Spark y al plan ejecutado. La optimización del inicio termina cuando empieza el código; no debe convertirse en una explicación cómoda para lecturas, shuffles o escrituras Delta lentas.
Fuentes
- Microsoft Learn: starter pools, cómputo de Spark en Fabric, información de inicio de sesión, cola de trabajos de Spark, configuración de Spark del área de trabajo, gestión de bibliotecas del entorno, modo de alta concurrencia, utilidades MSSparkUtils
Los tiempos son los valores típicos documentados por Microsoft, revisados en noviembre de 2026; mide tu propia referencia.
¿Te resultó útil este contenido?
¿Qué podríamos mejorar?
Gracias — esto me ayuda a mejorar Javi Builds.
Sigue aprendiendo
- Guía rápidaSession tags en FabricUsa los session tags de Microsoft Fabric para reutilizar sesiones Spark compatibles entre actividades de notebook, reducir el tiempo de inicio y evitar una fragmentación innecesaria de sesiones.Abrir guía rápida
- Hoja de rutaMicrosoft Fabric Notebook PerformanceDiagnostica la adquisición de sesiones Spark de Microsoft Fabric y reduce el tiempo de inicio evitable mediante pools, entornos y reutilización compatibles.Ver hoja de ruta
¿Qué debería crear después?
Estoy construyendo Javi Builds alrededor de problemas reales que enfrentan los ingenieros de datos. Dime qué tema te gustaría ver después.
Mantente al día
Recibe solo las novedades de Javi Builds que realmente te interesan.
Revisa tu bandeja de entrada
Te he enviado un enlace de confirmación. Tu suscripción se activará cuando la confirmes.