Microsoft Fabric
Réduire le temps de démarrage des notebooks Fabric
Diagnostiquez l’acquisition des sessions Spark Fabric et réduisez le délai évitable au démarrage grâce aux pools, environnements et possibilités de réutilisation adaptés.
Dans cet article
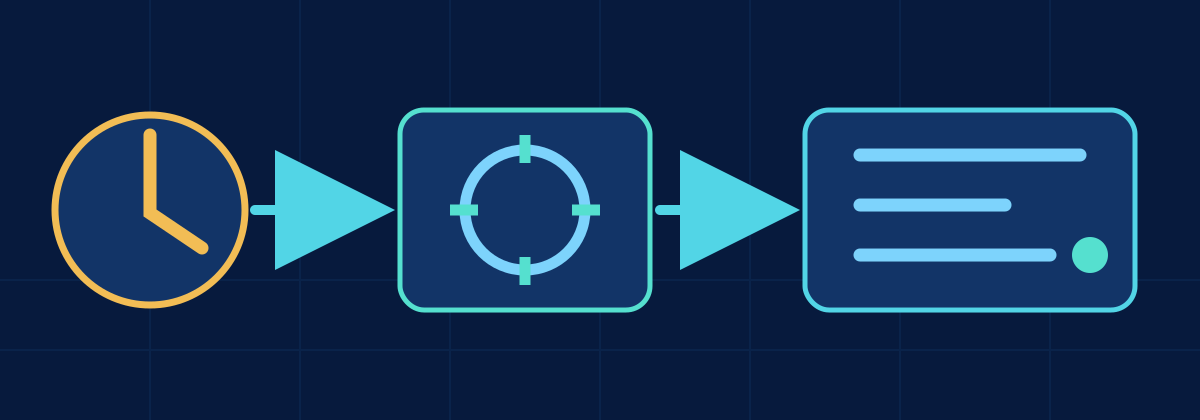
Réponse courte : le temps qui précède l’exécution de votre code a deux causes différentes, et une troisième phase est souvent confondue avec elles. Le temps de file est l’attente de capacité. Le démarrage de session est la création ou l’attachement d’une session Spark par Fabric, bibliothèques de l’environnement comprises. L’exécution du code commence avec votre première cellule. Mesurez celle qui s’est allongée avant de changer quoi que ce soit : seuls les réglages de pool, d’environnement et de réutilisation présentés ici agissent sur le démarrage de session.
- Début de l’activitéPipeline, planification ou exécution interactive
- CapacitéTemps de fileLes tâches de pipeline et planifiées attendent tant que les cœurs Spark sont occupés
- Cet articleDémarrage de sessionStarter pool ou cluster à la demande, environnement, bibliothèques
- Votre notebookExécution du codeDe la première à la dernière cellule
Problème
Le code Spark d’un notebook s’exécute en moins d’une minute, mais l’activité du pipeline dure beaucoup plus longtemps. Certaines exécutions obtiennent rapidement une session, tandis que d’autres attendent. Augmenter le nombre d’executors ne corrigera pas le temps passé avant le démarrage des jobs Spark : commencez donc par isoler l’acquisition de la session de l’exécution.
Temps de file, démarrage de session et exécution du code
Temps de file
Quand les cœurs Spark de la capacité sont tous utilisés, les notebooks lancés par des pipelines ou le planificateur, ainsi que les définitions de jobs Spark, sont mis en file (premier entré, premier sorti) et relancés automatiquement. Les entrées de la file expirent 24 heures après leur admission. Les exécutions interactives et les notebooks soumis par l’API publique ne sont pas mis en file : ils échouent avec TooManyRequestsForCapacity (HTTP 430). Les réglages de pool et de bibliothèques ne réduisent pas le temps de file ; la capacité, la planification et les charges concurrentes, si. Si la mise en file devient courante, suivez le runbook de saturation de capacité Fabric (en anglais) et dimensionnez à partir de l’utilisation mesurée avec le Fabric Capacity Planner (en anglais).
Démarrage de session
- Les starter pools sont préchauffés et gérés par Microsoft. Sans bibliothèques supplémentaires ni propriétés Spark personnalisées, une session démarre en général en 5 à 10 secondes, mais au mieux : la capacité préchauffée n’est pas garantie, et une forte demande régionale peut basculer vers un cluster à la demande.
- Le calcul personnalisé (taille de nœud, pools personnalisés, certaines configurations réseau) peut empêcher le chemin préchauffé et démarrer un cluster à la demande.
- Les bibliothèques d’environnement dépendent du mode de publication : en mode complet, l’instantané des bibliothèques est déployé au démarrage de la session, ce qui ajoute en général 1 à 3 minutes ; en mode rapide, elles s’installent à l’exécution de la première cellule, et le délai ressemble alors à du « code » lent.
- Les custom live pools gardent des clusters dédiés au chaud pendant une plage que vous définissez, bibliothèques préinstallées, si bien que les sessions démarrent en environ 5 secondes pendant cette plage. Le calcul gardé au chaud consomme de la capacité : réservez-le aux traitements sensibles à la latence.
Les informations de démarrage de session, dans les détails de session, indiquent si la session vient d’un starter pool ou d’un cluster à la demande, et pourquoi le chemin rapide n’a pas été utilisé.
Exécution du code
L’exécution commence à la première cellule. Le temps d’un %pip install en ligne y est compté, comme une installation en mode rapide. Tout le reste (lectures, shuffles, écritures) relève de l’accélération du notebook lui-même.
Sessions chaudes, expiration et réutilisation
Une session interactive reste chaude jusqu’à son expiration ; par défaut 20 minutes, réglable dans les paramètres Spark de l’espace de travail. L’exécution suivante paie de nouveau le démarrage.
Les pipelines peuvent réutiliser une session en cours au lieu d’en démarrer une par notebook. Avec la haute concurrence activée pour les pipelines, les activités compatibles qui partagent un session tag rejoignent une même session ; par défaut, jusqu’à cinq notebooks la partagent, et la limite peut être portée à 50 (en anglais).
Méfiez-vous de l’enchaînement inutile de notebooks. Un pipeline qui appelle dix petits notebooks comme dix activités distinctes peut payer dix fois la file et le démarrage. Regroupez les activités compatibles sous un même session tag, fusionnez les notebooks toujours exécutés ensemble, ou appelez-les depuis un notebook orchestrateur : Microsoft indique qu’un notebook lancé avec notebook.run() (NotebookUtils, anciennement MSSparkUtils) s’exécute sur le pool Spark du notebook appelant. runMultiple() en exécute plusieurs en parallèle et est signalé en préversion dans cette documentation.
Recommandations pratiques
Mesurez séparément le démarrage. Consignez le début de l’activité du pipeline, le moment où la session est prête si cette information est disponible, le démarrage du premier job Spark et la fin du notebook. Utilisez les détails de session ou l’interface de supervision pour identifier la source et la raison du délai. Sans cette séparation, une première lecture lente peut être attribuée à tort au démarrage.
Privilégiez la configuration par défaut compatible avec les starter pools lorsqu’elle convient à la charge. Ne personnalisez pas à l’avance la taille des nœuds ni les propriétés Spark. Une configuration personnalisée peut convenir à un traitement lourd et soutenu, mais ralentir l’acquisition. Évaluez la durée totale et la fiabilité.
Déplacez les dépendances stables et partagées dans un Fabric Environment gouverné au lieu d’exécuter %pip install dans chaque notebook. Choisissez le mode de publication de l’environnement en fonction de la vitesse de développement, de la reproductibilité et des besoins de session. Évitez d’importer des packages lourds que le notebook n’utilise pas. La préparation des packages fait partie du coût d’exécution, même si elle n’apparaît pas comme une étape Spark.
Exemple de mesure
Le code d’un notebook ne peut pas mesurer le temps précédant le démarrage de son propre processus, mais il peut marquer le premier point exécutable et chaque étape suivante. Associez ces enregistrements aux horodatages du pipeline et de la session Fabric.
from datetime import datetime, timezone
from time import perf_counter

notebook_started_at = datetime.now(timezone.utc).isoformat()
clock = perf_counter()

print({"event": "notebook_code_started", "at": notebook_started_at})

orders = (
    spark.read.table("SalesLakehouse.silver.orders")
    .select("order_id", "order_date", "amount")
    .where("order_date >= '2026-10-01'")
)

row_count = orders.count()
print({
    "event": "input_materialized",
    "elapsed_seconds": round(perf_counter() - clock, 3),
    "rows": row_count,
})Si le délai entre le pipeline et le début du code est élevé, mais que le délai entre le code et la première action est normal, examinez l’acquisition et l’initialisation de l’environnement. Si le notebook démarre rapidement mais que la première action est lente, examinez plutôt l’accès à la table, le listing des fichiers, la construction du plan et le job Spark.
Créez un petit tableau de comparaison sur plusieurs exécutions représentatives :
| Exécution | Source de session | Acquisition | Première action | Travail restant |
|---|---|---|---|---|
| Référence | Starter ou réutilisée | mesurée | mesurée | mesuré |
| Exécution lente | À la demande ou personnalisée | mesurée | mesurée | mesuré |
N’inventez pas de valeurs cibles. Établissez une référence pour l’espace de travail, la capacité, la configuration et la période concernés. La demande régionale et l’utilisation concurrente de la capacité peuvent modifier les résultats.
Erreurs fréquentes
- Optimiser les transformations Spark alors que le délai se produit avant le premier job.
- Supposer que le démarrage par starter pool est garanti à chaque exécution.
- Ajouter des paramètres de calcul personnalisés sans mesurer leur coût d’acquisition.
- Installer les mêmes packages en ligne dans chaque notebook.
- Considérer un live pool comme une réduction gratuite de la latence sans tenir compte de la capacité utilisée.
- Utiliser des session tags uniques qui empêchent les activités apparentées du pipeline de réutiliser une session.
- Forcer des charges incompatibles à partager une session et perdre en fiabilité ou en isolation.
- Mesurer une seule exécution et la présenter comme un benchmark stable.
Liste de vérification du démarrage
- Le notebook a-t-il été mis en file ? Vérifiez le temps de file avant tout.
- Une nouvelle session a-t-elle été créée, ou s’est-il rattaché à une session chaude ou partagée ?
- La session vient-elle d’un starter pool ou d’un cluster à la demande, et quelle raison donnent les informations de démarrage ?
- L’environnement a-t-il changé ou été republié, et quel mode de publication des bibliothèques utilise-t-il ?
- Des bibliothèques personnalisées sont-elles installées avec
%pipà chaque exécution ? - La réutilisation de session est-elle possible : haute concurrence activée, réglages compatibles, session tag commun ?
- De nombreux petits notebooks sont-ils lancés comme activités séparées ?
- La concurrence sur la capacité est-elle le vrai goulet d’étranglement ?
Si l’acquisition est normale, poursuivez l’investigation sur la première action Spark et le plan exécuté. L’optimisation du démarrage s’arrête quand le code commence ; elle ne doit pas devenir une explication commode pour des lectures, des shuffles ou des écritures Delta lentes.
Sources
- Microsoft Learn : starter pools, calcul Spark dans Fabric, informations de démarrage de session, mise en file des jobs Spark, paramètres Spark de l’espace de travail, gestion des bibliothèques d’environnement, mode haute concurrence, utilitaires MSSparkUtils
Les durées sont les valeurs typiques documentées par Microsoft, vérifiées en novembre 2026 ; mesurez votre propre référence.
Ce contenu vous a-t-il été utile ?
Que pourrions-nous améliorer ?
Merci — cela m’aide à améliorer Javi Builds.
Continuer à apprendre
- Aide-mémoireSession tags dans FabricUtilisez les session tags de Microsoft Fabric pour réutiliser des sessions Spark compatibles entre activités de notebook, réduire le temps de démarrage et éviter une fragmentation inutile des sessions.Ouvrir l’aide-mémoire
- Feuille de routeMicrosoft Fabric Notebook PerformanceDiagnostiquez l’acquisition des sessions Spark Fabric et réduisez le délai évitable au démarrage grâce aux pools, environnements et possibilités de réutilisation adaptés.Voir la feuille de route
Que devrais-je créer ensuite ?
Je développe Javi Builds autour des problèmes concrets rencontrés par les data engineers. Dites-moi quel sujet vous aimeriez voir ensuite.
Restez au courant
Recevez uniquement les nouvelles de Javi Builds qui vous intéressent.
Consultez votre boîte de réception
Je vous ai envoyé un lien de confirmation. Votre abonnement sera actif après confirmation.