DevOps et observabilité
Superviser une plateforme de données : que faut-il vraiment mesurer ?
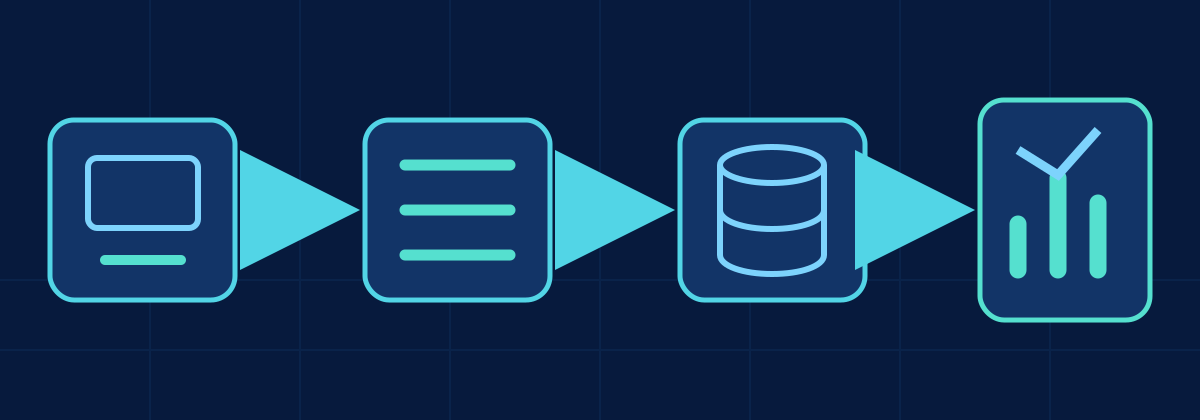
Un modèle pratique de supervision qui relie clients, applications, API, moteurs de rapports, plateformes de données, calcul et stockage.
Dans cet article
Réponse courte : mesurez chaque couche traversée par une demande (client, application, API, service de rapports ou de requêtes, plateforme de données, calcul et stockage) avec les mêmes quatre questions : quelle quantité de travail est arrivée, quelle part a échoué, combien de temps cela a pris en P50/P95/P99 et à quel point la couche approche de la saturation. Ajoutez ensuite la fraîcheur des données, qu’aucune métrique d’infrastructure ne vous donnera. Reliez le tout avec un identifiant de corrélation unique, pour suivre un incident d’une couche à l’autre au lieu de le deviner.
Couches de supervision
Suivez la demande depuis l’utilisateur ou le client jusqu’à l’application, l’API, le moteur de rapports, la plateforme de données puis, enfin, le calcul et le stockage. Conservez un même identifiant de corrélation à travers toutes ces frontières. La vue client fournit la latence perçue ; l’application, le contexte fonctionnel et les erreurs ; l’API, le débit et les codes de statut ; le moteur de rapports distingue la validation, le cache et le travail de requête ; la plateforme expose l’exécution SQL, des pipelines et des notebooks ; le calcul et le stockage révèlent la saturation et les E/S.
- ClientLatence perçue, erreurs vues par l’utilisateur
- ApplicationFonctionnalité, action, contexte de l’exception
- APIDébit, codes de statut, limitation
- Service de rapportsValidation, cache trouvé ou non, temps de requête
- Plateforme de donnéesRequêtes SQL, exécutions de pipelines et notebooks
- Calcul et stockageCPU, mémoire, unités de capacité, E/S
Types d’éléments de preuve
Les métriques sont des séries temporelles numériques adaptées à l’agrégation et aux alertes. Les journaux décrivent des occurrences individuelles. Les événements enregistrent des changements significatifs, comme des déploiements ou des nouvelles tentatives. Les traces relient des intervalles chronométrés entre services. Les données d’audit indiquent qui a demandé ou modifié quoi. Leurs besoins de rétention et d’accès diffèrent, mais des identifiants partagés et des horodatages UTC permettent de les exploiter ensemble.
Quoi mesurer
Mesurez le volume de requêtes, le taux d’erreur, la latence P50, P95 et P99, les requêtes simultanées, la profondeur de file d’attente, le taux de réussite du cache, le CPU, la mémoire, les lectures, les écritures, les attentes, la durée des requêtes, des pipelines et des notebooks, les échecs, les nouvelles tentatives, les lignes traitées et la fraîcheur des données. Associez chaque taux à son dénominateur et chaque durée à la taille et à la classe de la charge.
Les quatre premiers sont les « quatre signaux clés » du SRE de Google (latence, trafic, erreurs, saturation). La fraîcheur est celui qu’ajoutent les plateformes de données : un pipeline qui réussit à l’heure mais charge le fichier de la veille est sain selon toutes les métriques d’infrastructure, et faux pour tous les utilisateurs.
Chaque couche fait l’objet d’un article de cette série : Superviser les pipelines et notebooks Microsoft Fabric, Superviser les charges SQL Server en temps réel, Concevoir un journal d’exécution pour les pipelines de données et Mesurer le volume de requêtes API et de rapports.
Pourquoi les moyennes trompent
Si la plupart des requêtes se terminent en quelques millisecondes alors que quelques-unes prennent des dizaines de secondes, la moyenne ne décrit presque personne. Le P50 montre le comportement typique, le P95 expose la frange lente et le P99 révèle le comportement plus rare de la queue de distribution. Indiquez le nombre d’échantillons et segmentez par type de rapport, résultat du cache, classe de tenant, taille du résultat et statut de réussite.
Où trouver ces signaux dans une plateforme Microsoft
Il faut rarement un nouvel outil pour commencer : la plupart de ces signaux existent déjà. Le travail consiste à choisir ceux que vous conservez, pendant combien de temps, et comment ils se relient.
| Couche | Signaux à conserver | D’où ils viennent |
|---|---|---|
| Client et application | Latence des pages ou actions, requêtes en échec, exceptions, appels de dépendances | Application Insights (Azure Monitor) |
| API | Requêtes par consommateur, taux de 4xx/5xx et de 429, latence du backend | Analytique et journaux de diagnostic d’Azure API Management |
| Service de rapports ou de requêtes | Taux de cache trouvé, rejets de validation, attente en file vs temps de requête | Votre propre journal structuré, une ligne par demande |
| SQL Server | Attentes, blocages, CPU, lectures, régressions de plan | DMV (sys.dm_exec_requests), Query Store, Extended Events |
| Fabric Warehouse / point de terminaison SQL | Durée des requêtes, requêtes fréquentes et longues | queryinsights.exec_requests_history, queryinsights.long_running_queries |
| Pipelines et notebooks Fabric | Statut, durée, échecs, nouvelles tentatives | Hub de supervision, supervision Spark, votre journal d’exécution |
| Capacité Fabric | Consommation de CU, lissage, limitation et rejet | Application Microsoft Fabric Capacity Metrics |
Deux d’entre eux méritent une conception délibérée plutôt que des valeurs par défaut : le journal des demandes de votre propre service et le journal d’exécution de vos pipelines. Les outils de la plateforme montrent ce qui s’est exécuté ; seuls vos journaux disent pour quel client, locataire, rapport ou chargement métier. Concevoir un journal d’exécution pour les pipelines de données traite le côté pipelines.
Alertes ou tableaux de bord
Un tableau de bord sert à observer ; une alerte demande à quelqu’un d’agir. N’alertez que si le destinataire dispose d’une réponse documentée, et écrivez la réponse avant la règle.
| Condition d’alerte | Pourquoi c’est important | Première réponse |
|---|---|---|
| Latence P95 de l’API au-dessus de l’objectif pendant 10 minutes, avec un trafic normal | Les utilisateurs attendent et ce n’est pas seulement la charge | Ventiler par résultat de cache et par dépendance ; suivre les identifiants de corrélation les plus lents |
| Taux de 429 ou de 5xx au-dessus de la normale pour un consommateur | Un client est limité ou un backend échoue | Comparer le volume de ce consommateur à son quota ; voir Mesurer le volume de requêtes API et de rapports |
| Chaîne de blocage de plus de quelques minutes sur SQL Server | Le travail attend derrière une seule session | Runbook de blocage SQL Server (en anglais) |
| Capacité Fabric en retard interactif ou en rejet | Toutes les charges de la capacité sont touchées | Runbook de saturation de capacité Fabric (en anglais) |
| Fraîcheur : dernier chargement réussi plus ancien que sa planification plus la tolérance | Les rapports affichent des données périmées alors que tous les traitements sont au vert | Chercher dans le journal d’exécution le dernier lot réussi et son repère de source |
| Pipeline en échec après épuisement des nouvelles tentatives | Le budget de nouvelles tentatives n’a pas absorbé une panne transitoire | Lire la première erreur, pas la dernière ; vérifier si des données partielles ont été écrites |
Tout le reste (CPU, mémoire, taux de cache, profondeur de file, nombre de lignes) va d’abord sur un tableau de bord. Ne transformez un signal en alerte qu’après l’avoir vu annoncer un problème visible par les utilisateurs.
Un socle minimal pour la première charge
Choisissez une charge importante et faites fonctionner ceci de bout en bout avant d’en ajouter d’autres :
- Un identifiant de corrélation créé en entrée et transmis à chaque ligne de journal, étiquette de requête et paramètre de pipeline.
- Un journal structuré des demandes ou des exécutions : début et fin en UTC, statut, durée, lignes ou octets, code d’erreur.
- Latence P50/P95/P99 et taux d’erreur de cette charge, ventilés par sa classe principale (type de rapport, pipeline, niveau de locataire).
- Un contrôle de fraîcheur par jeu de données publié : dernier chargement réussi, et à partir de quel lot source.
- La saturation du calcul utilisé : attentes et CPU SQL Server, ou utilisation de la capacité Fabric.
- Deux ou trois alertes du tableau ci-dessus, chacune avec un responsable et une première réponse écrite.
Passez à la charge suivante seulement quand une personne d’astreinte qui n’a pas construit la première peut aller de « le rapport est lent » à une demande, une requête ou une exécution de notebook précise avec ces seuls signaux.
Pour aller plus loin
- Superviser les pipelines et notebooks Microsoft Fabric
- Superviser les charges SQL Server en temps réel
- Capacité et consommation de calcul Fabric (en anglais), et le Fabric Capacity Planner (en anglais) pour dimensionner à partir de l’utilisation déjà mesurée
- Trouver les régressions de performance SQL Server avec Query Store
Sources
- Livre SRE de Google : Monitoring distributed systems (les quatre signaux clés)
- W3C : Trace Context (propager un même identifiant de trace entre services) ; OpenTelemetry : Signals
- Microsoft Learn : Application Insights, Query Store, Extended Events
- Microsoft Learn (Fabric) : Query insights, Hub de supervision, Supervision Spark, Application Capacity Metrics
Sources produit vérifiées en novembre 2026. Les écrans de supervision de Fabric évoluent souvent ; vérifiez les noms de fonctionnalités dans les pages citées.
Ce contenu vous a-t-il été utile ?
Que pourrions-nous améliorer ?
Merci — cela m’aide à améliorer Javi Builds.
Continuer à apprendre
- Aide-mémoireSuperviser les pipelines et notebooks FabricSupervisez les pipelines et notebooks Microsoft Fabric avec le Monitoring hub, Workspace Monitoring, la supervision Spark, KQL, les alertes et la télémétrie de capacité afin de rendre observables les échecs et les régressions de performances.Ouvrir l’aide-mémoire
- ArticleSuperviser les pipelines et notebooks Microsoft Fabric en productionComment superviser les pipelines et notebooks Fabric assez bien pour détecter échecs, lenteurs, nouvelles tentatives, pression sur la capacité et données incorrectes avant les utilisateurs, grâce à la corrélation des exécutions, aux journaux d’exécution, aux références de durée et aux alertes.Lire l’article
Que devrais-je créer ensuite ?
Je développe Javi Builds autour des problèmes concrets rencontrés par les data engineers. Dites-moi quel sujet vous aimeriez voir ensuite.
Restez au courant
Recevez uniquement les nouvelles de Javi Builds qui vous intéressent.
Consultez votre boîte de réception
Je vous ai envoyé un lien de confirmation. Votre abonnement sera actif après confirmation.