DevOps y observabilidad
Monitoreo de una plataforma de datos: ¿qué conviene medir realmente?
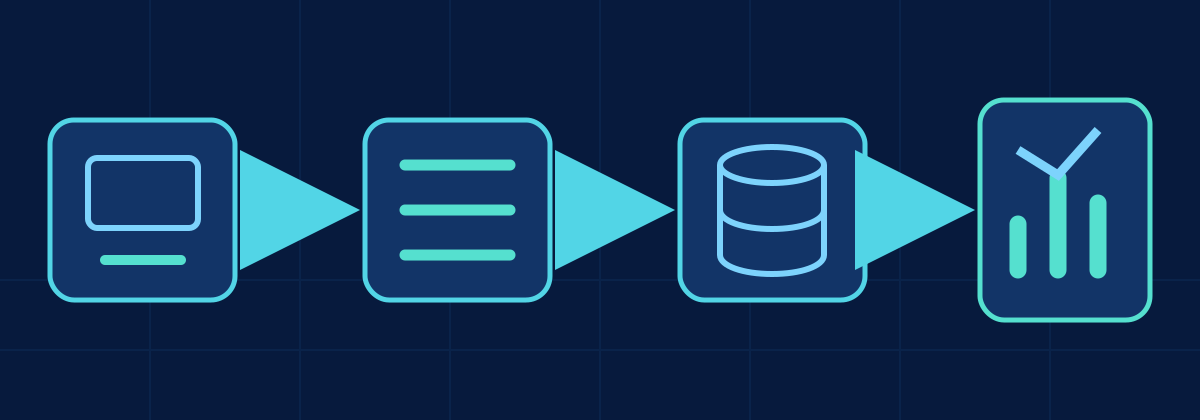
Un modelo práctico de monitoreo que conecta clientes, aplicaciones, API, motores de informes, plataformas de datos, cómputo y almacenamiento.
En este artículo
Respuesta corta: mide cada capa que cruza una solicitud (cliente, aplicación, API, servicio de informes o de consultas, plataforma de datos, cómputo y almacenamiento) con las mismas cuatro preguntas: cuánto trabajo llegó, cuánto falló, cuánto tardó en P50/P95/P99 y qué tan cerca está la capa de la saturación. Después añade la frescura de los datos, que ninguna métrica de infraestructura te dará. Une todo con un único ID de correlación, para seguir un incidente de una capa a otra en lugar de adivinar.
Capas de monitoreo
Sigue la solicitud desde el usuario o cliente hasta la aplicación, la API, el motor de informes, la plataforma de datos y, por último, el cómputo y el almacenamiento. Mantén un mismo ID de correlación a través de todas esas fronteras. La vista del cliente aporta la latencia percibida; la aplicación, el contexto de la funcionalidad y de los errores; la API, la tasa de solicitudes y los códigos de estado; el motor de informes separa la validación, la caché y el trabajo de consulta; la plataforma expone la ejecución de SQL, pipelines y notebooks; y el cómputo y el almacenamiento muestran la saturación y la E/S.
- ClienteLatencia percibida, errores que vio el usuario
- AplicaciónFuncionalidad, acción, contexto de la excepción
- APITasa de solicitudes, códigos de estado, limitación
- Servicio de informesValidación, acierto o fallo de caché, tiempo de consulta
- Plataforma de datosConsultas SQL, ejecuciones de pipelines y notebooks
- Cómputo y almacenamientoCPU, memoria, unidades de capacidad, E/S
Tipos de evidencia
Las métricas son series temporales numéricas adecuadas para agregaciones y alertas. Los logs describen sucesos individuales. Los eventos registran cambios significativos, como despliegues o reintentos. Las trazas conectan intervalos temporizados entre servicios. Los datos de auditoría registran quién solicitó o cambió qué. Cada tipo tiene necesidades distintas de retención y acceso, pero los identificadores compartidos y las marcas de tiempo UTC permiten usarlos en conjunto.
Qué medir
Mide el volumen de solicitudes, la tasa de errores, la latencia P50, P95 y P99, las solicitudes concurrentes, la profundidad de la cola, la tasa de aciertos de caché, el CPU, la memoria, las lecturas, las escrituras, las esperas, la duración de las consultas, de los pipelines y de los notebooks, los fallos, los reintentos, las filas procesadas y la frescura de los datos. Acompaña cada tasa con su denominador y cada duración con el tamaño y la clase de la carga.
Las cuatro primeras son las «cuatro señales clave» del SRE de Google (latencia, tráfico, errores, saturación). La frescura es la que añaden las plataformas de datos: un pipeline que termina a tiempo pero carga el archivo de ayer está sano según todas las métricas de infraestructura, y mal para todos los usuarios.
Cada capa tiene su propio artículo en esta serie: Monitoreo de pipelines y notebooks de Microsoft Fabric, Monitoreo de cargas de trabajo de SQL Server en tiempo real, Diseñar un registro de ejecución para pipelines de datos y Cómo medir el volumen de solicitudes de API e informes.
Por qué fallan los promedios
Si la mayoría de las solicitudes terminan en milisegundos y unas pocas tardan decenas de segundos, el promedio no describe a casi nadie. El P50 muestra el comportamiento típico, el P95 expone el extremo lento y el P99 revela el comportamiento menos frecuente de la cola. Incluye el número de muestras y segmenta por tipo de informe, resultado de caché, clase de tenant, tamaño del resultado y estado de éxito.
Dónde están estas señales en una plataforma Microsoft
Pocas veces hace falta una herramienta nueva para empezar: la mayoría de estas señales ya existen. El trabajo es decidir cuáles conservas, durante cuánto tiempo y cómo se relacionan.
| Capa | Señales que conviene conservar | De dónde salen |
|---|---|---|
| Cliente y aplicación | Latencia de páginas o acciones, solicitudes fallidas, excepciones, llamadas a dependencias | Application Insights (Azure Monitor) |
| API | Solicitudes por consumidor, tasas de 4xx/5xx y 429, latencia del backend | Analítica y logs de diagnóstico de Azure API Management |
| Servicio de informes o de consultas | Tasa de aciertos de caché, rechazos de validación, espera en cola vs tiempo de consulta | Tu propio log estructurado, una fila por solicitud |
| SQL Server | Esperas, bloqueos, CPU, lecturas, regresiones de plan | DMV (sys.dm_exec_requests), Query Store, Extended Events |
| Fabric Warehouse / punto de conexión SQL | Duración de consultas, consultas frecuentes y largas | queryinsights.exec_requests_history, queryinsights.long_running_queries |
| Pipelines y notebooks de Fabric | Estado, duración, fallos, reintentos | Centro de supervisión, monitoreo de Spark, tu registro de ejecución |
| Capacidad de Fabric | Consumo de CU, suavizado, limitación y rechazo | Aplicación Microsoft Fabric Capacity Metrics |
Dos de ellas merecen un diseño deliberado y no valores por defecto: el log de solicitudes de tu propio servicio y el registro de ejecución de tus pipelines. Las herramientas de la plataforma muestran qué se ejecutó; solo tus logs dicen para qué cliente, tenant, informe o carga de negocio. Diseñar un registro de ejecución para pipelines de datos cubre el lado de los pipelines.
Alertas o paneles
Un panel sirve para mirar; una alerta pide a alguien que actúe. Alerta solo cuando quien la recibe tiene una respuesta documentada, y escribe la respuesta antes que la regla.
| Condición de alerta | Por qué importa | Primera respuesta |
|---|---|---|
| Latencia P95 de la API por encima del objetivo durante 10 minutos, con tráfico normal | Los usuarios esperan y no es solo carga | Separar por resultado de caché y por dependencia; seguir los ID de correlación más lentos |
| Tasa de 429 o 5xx por encima de lo normal para un consumidor | Un cliente está limitado o un backend está fallando | Comparar el volumen de ese consumidor con su cuota; ver Cómo medir el volumen de solicitudes de API e informes |
| Cadena de bloqueo de más de unos minutos en SQL Server | El trabajo espera detrás de una sola sesión | Runbook de bloqueos de SQL Server (en inglés) |
| Capacidad de Fabric en retraso interactivo o en rechazo | Todas las cargas de la capacidad se ven afectadas | Runbook de saturación de capacidad de Fabric (en inglés) |
| Frescura: última carga correcta más antigua que su programación más la tolerancia | Los informes muestran datos viejos mientras todos los procesos están en verde | Buscar en el registro de ejecución el último lote correcto y su marca de agua de origen |
| Pipeline fallido tras agotar los reintentos | El presupuesto de reintentos no absorbió un fallo transitorio | Leer el primer error, no el último; confirmar si se escribieron datos parciales |
Todo lo demás (CPU, memoria, tasa de caché, profundidad de cola, número de filas) va primero a un panel. Convierte una señal en alerta solo después de haberla visto anticipar un problema visible para los usuarios.
Un mínimo para la primera carga
Elige una carga importante y haz que esto funcione de extremo a extremo antes de añadir más:
- Un ID de correlación creado en la entrada y propagado a cada línea de log, etiqueta de consulta y parámetro de pipeline.
- Un log estructurado de solicitudes o ejecuciones: inicio y fin en UTC, estado, duración, filas o bytes y código de error.
- Latencia P50/P95/P99 y tasa de errores de esa carga, separadas por su clase principal (tipo de informe, pipeline, nivel de tenant).
- Una comprobación de frescura por conjunto de datos publicado: cuándo se cargó correctamente por última vez y desde qué lote de origen.
- La saturación del cómputo que usa: esperas y CPU de SQL Server, o utilización de la capacidad de Fabric.
- Dos o tres alertas de la tabla anterior, cada una con un responsable y una primera respuesta escrita.
Pasa a la siguiente carga solo cuando una persona de guardia que no construyó la primera pueda ir de «el informe va lento» a una solicitud, consulta o ejecución de notebook concreta usando solo estas señales.
Para profundizar
- Monitoreo de pipelines y notebooks de Microsoft Fabric
- Monitoreo de cargas de trabajo de SQL Server en tiempo real
- Capacidad y consumo de cómputo en Fabric (en inglés), y el Fabric Capacity Planner (en inglés) para dimensionar a partir del uso que ya mides
- Cómo encontrar regresiones de rendimiento en SQL Server con Query Store
Fuentes
- Libro de SRE de Google: Monitoring distributed systems (las cuatro señales clave)
- W3C: Trace Context (propagar un mismo ID de traza entre servicios); OpenTelemetry: Signals
- Microsoft Learn: Application Insights, Query Store, Extended Events
- Microsoft Learn (Fabric): Query insights, Centro de supervisión, Monitoreo de Spark, Aplicación Capacity Metrics
Fuentes de producto revisadas en noviembre de 2026. Las pantallas de supervisión de Fabric cambian a menudo; confirma los nombres de las funciones en las páginas citadas.
¿Te resultó útil este contenido?
¿Qué podríamos mejorar?
Gracias — esto me ayuda a mejorar Javi Builds.
Sigue aprendiendo
- Guía rápidaMonitorear pipelines y notebooks de FabricMonitorea pipelines y notebooks de Microsoft Fabric con Monitoring hub, Workspace Monitoring, el monitoreo de Spark, KQL, alertas y telemetría de capacidad para que los errores y las regresiones de rendimiento sean observables.Abrir guía rápida
- ArtículoMonitoreo de pipelines y notebooks de Microsoft Fabric en producciónCómo monitorear pipelines y notebooks de Fabric lo bastante bien para detectar fallos, lentitud, reintentos, presión de capacidad y datos incorrectos antes que los usuarios, con correlación de ejecuciones, registros de ejecución, referencias de duración y alertas.Leer artículo
¿Qué debería crear después?
Estoy construyendo Javi Builds alrededor de problemas reales que enfrentan los ingenieros de datos. Dime qué tema te gustaría ver después.
Mantente al día
Recibe solo las novedades de Javi Builds que realmente te interesan.
Revisa tu bandeja de entrada
Te he enviado un enlace de confirmación. Tu suscripción se activará cuando la confirmes.