SQL Server
SQL Server est lent : les 15 premières minutes de triage
Une séquence de triage en production qui transforme un ralentissement vague en faits et en prochaine étape sûre durant les 10 à 15 premières minutes.
Dans cet article
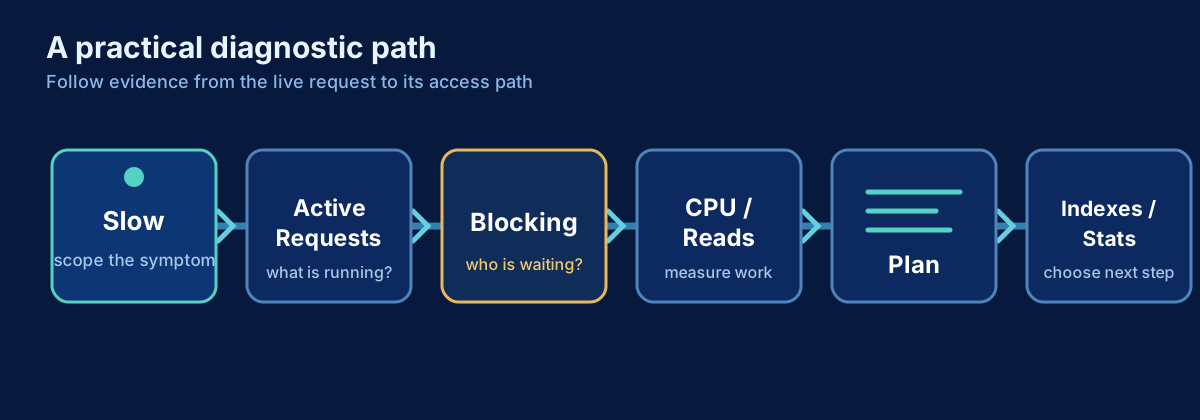
Réponse courte : pendant les 15 premières minutes, répondez à deux questions avant de changer quoi que ce soit. Le problème touche-t-il tout le serveur ou une seule charge, base ou requête ? Et quel signal domine : CPU, E/S, blocage, pression mémoire ou une requête coûteuse ? Capturez les éléments volatils pendant que vous y répondez, puis passez à l’investigation approfondie adaptée. Ce guide couvre uniquement ce triage, pas l’optimisation.
La méthode la plus sûre va du périmètre aux éléments factuels, puis seulement à une éventuelle modification. Capturez les éléments volatils avant de tuer une session, de redémarrer un service, de vider le cache des plans ou de reconstruire un index. Ces actions peuvent faire disparaître les symptômes et les preuves sans traiter la cause.
- SQL Server est lentNotez le symptôme, la charge et la fenêtre de temps
- Tout le serveur ou une charge ?Toutes les applications, une base ou une opération
- CPU élevéCPURequêtes les plus coûteuses en CPU, compilations, parallélisme
- attentes E/SI/OD’abord les lectures par requête, ensuite la latence du stockage
- attentes de verrouBlocageBloqueur de tête, puis le runbook de blocage SQL Server
- mémoireAutres attentesAllocations mémoire, RESOURCE_SEMAPHORE, réseau
- une instructionRequête coûteusePlan, lectures, estimations de lignes
- plan modifiéRégression de planComparer des fenêtres de temps dans Query Store
Problème : définir ce que signifie « lent »
Commencez par identifier la charge concernée et l’heure. Toutes les applications sont-elles lentes, ou seulement une opération ? Les échecs sont-ils continus ou intermittents ? Le problème se produit-il maintenant ? Notez la base de données, la durée attendue et observée, l’application, le login, l’hôte et un identifiant de requête si l’application en fournit un.
« Les rapports de ReportingDb prennent 90 secondes au lieu de 8 depuis 14 h 10 » est exploitable. Cette description précise une base et une période que l’on peut comparer à Query Store, aux outils de supervision, aux déploiements et aux traitements planifiés. « Le CPU est élevé » ne signifie pas que le CPU est la cause. Un travail utile, un scan provoqué par une mauvaise estimation ou une consommation liée à des compilations répétées peuvent tous utiliser du CPU pour des raisons différentes.
Diagnostic rapide : problème actuel ou passé ?
Si le ralentissement est en cours, examinez d’abord les requêtes actives et les blocages. Les vues de gestion dynamique fournissent un instantané : exécutez la requête plusieurs fois et enregistrez les résultats avec un horodatage. Si le ralentissement est terminé, appuyez-vous sur Query Store, l’historique de supervision, Extended Events, la télémétrie applicative et l’historique des tâches. Le cache des plans peut aider, mais ce n’est pas un journal d’audit durable : ses entrées peuvent disparaître lors d’une éviction, d’une recompilation, d’un redémarrage, d’un basculement ou d’une opération de vidage du cache.
Avant toute modification, capturez :
- l’heure du signalement et l’heure du serveur, fuseau horaire compris ;
- les identifiants des sessions et requêtes actives ;
- la base, le login, l’hôte, l’application et le texte SQL ;
- l’état, le type d’attente, la session bloquante, le CPU, les lectures, les écritures et le temps écoulé ;
- le plan d’exécution concerné ou les identifiants de requête et de plan dans Query Store ;
- les déploiements récents, changements de configuration, opérations de maintenance et volumes de charge inhabituels.
Requête : capturer les requêtes actives
Exécutez cette requête avec un login disposant de VIEW SERVER STATE sur les versions qui l’exigent. Sur les versions plus récentes, l’autorisation peut être VIEW SERVER PERFORMANCE STATE. La requête est en lecture seule et exclut sa propre session.
SELECT
    SYSDATETIMEOFFSET() AS captured_at,
    r.session_id,
    r.request_id,
    DB_NAME(r.database_id) AS database_name,
    s.login_name,
    s.host_name,
    s.program_name,
    r.status,
    r.command,
    r.wait_type,
    r.wait_time AS wait_time_ms,
    NULLIF(r.blocking_session_id, 0) AS blocking_session_id,
    r.cpu_time AS cpu_time_ms,
    r.logical_reads,
    r.reads AS physical_reads,
    r.writes,
    r.total_elapsed_time AS elapsed_time_ms,
    SUBSTRING(
        text_info.text,
        (r.statement_start_offset / 2) + 1,
        ((CASE r.statement_end_offset
            WHEN -1 THEN DATALENGTH(text_info.text)
            ELSE r.statement_end_offset
          END - r.statement_start_offset) / 2) + 1
    ) AS current_statement
FROM sys.dm_exec_requests AS r
INNER JOIN sys.dm_exec_sessions AS s
    ON s.session_id = r.session_id
OUTER APPLY sys.dm_exec_sql_text(r.sql_handle) AS text_info
WHERE s.is_user_process = 1
  AND r.session_id <> @@SPID
ORDER BY r.total_elapsed_time DESC;Notes
- ligne 13NULLIF transforme 0 (non bloquée) en NULL : seuls les vrais blocages affichent une valeur.
- lignes 19–26Extrait du lot l’instruction en cours d’exécution : les décalages sont des octets dans un texte Unicode, et -1 signifie la fin du lot.
- ligne 30OUTER APPLY conserve les requêtes sans handle SQL ; CROSS APPLY les écarterait.
Interpréter les résultats
Commencez par repérer les concentrations. Une requête avec un temps écoulé élevé et peu de CPU est peut-être en attente ; plusieurs requêtes derrière le même bloqueur peuvent former une chaîne de blocage ; plusieurs requêtes coûteuses provenant du même program_name peuvent révéler une hausse de charge applicative. wait_type indique ce qu’une requête attend actuellement, pas la cause racine. Une attente sur un verrou invite à examiner le bloqueur. PAGEIOLATCH_* signale l’attente d’une page de données provenant du stockage, mais il faut ensuite se demander pourquoi cette page était nécessaire. ASYNC_NETWORK_IO peut indiquer que le client consomme les lignes lentement, ou simplement que la requête renvoie trop de lignes.
Comparez le temps écoulé au CPU. Un temps écoulé élevé avec peu de CPU indique souvent une attente. Un CPU et des lectures logiques élevés justifient souvent d’examiner le plan. Les écritures peuvent correspondre à des modifications de données, à l’activité d’une table de travail ou à de la maintenance. Interprétez toujours les compteurs dans le contexte de la charge : un traitement ETL nocturne n’est pas comparable à une recherche API portant sur une seule ligne.
Ce que les résultats peuvent indiquer
Un identifiant de session bloquante mène au diagnostic des blocages : trouvez le bloqueur principal, examinez sa transaction et son SQL, puis déterminez pourquoi elle reste ouverte. Des scans répétés et de nombreuses lectures logiques orientent vers le plan, les estimations, les index, les statistiques, les prédicats et la taille des tables. Un plan qui a récemment changé mène à Query Store et à la comparaison de différentes périodes. Une charge concentrée sur un login, un hôte ou un programme oriente vers l’application appelante, le pool de connexions, la concurrence, la stratégie de nouvelle tentative ou un traitement planifié.
Si l’instantané ne montre rien d’anormal, ne concluez pas qu’il ne s’est rien passé. La requête coûteuse a peut-être terminé entre deux mesures. Passez aux données historiques et vérifiez que la capture Query Store est activée et fonctionne correctement. Comparez la période de l’incident à une période de référence connue, plutôt qu’à des heures sans rapport et soumises à une autre charge.
Que vérifier ensuite ?
N’examinez le plan d’exécution qu’après avoir identifié l’instruction concernée. Comparez les lignes estimées et réelles lorsqu’il est possible de collecter un plan réel sans risque. Vérifiez si les statistiques représentent la distribution actuelle des données et si un index existant prend en charge les prédicats. Une suggestion d’index manquant est un élément à étudier, pas une autorisation de créer l’index. Vérifiez les recouvrements, la largeur, le coût en écriture et le plan réel.
Examinez ensuite l’historique des changements : déploiements de code et de schéma, niveau de compatibilité, configuration à l’échelle de la base, valeurs de paramètres, croissance des données, maintenance des statistiques, infrastructure, basculement et tâches planifiées. Un changement récent est une hypothèse à tester, pas une preuve.
Ce qu’il ne faut pas faire
- Redémarrer SQL Server avant de capturer les éléments : cela vide les DMV, le cache des plans et les attentes dont vous aviez besoin.
- Vider le cache des plans de tout le serveur pour corriger une requête : tout se recompile et les preuves disparaissent.
- Reconstruire tous les index « au cas où » : cela coûte des E/S et du journal, et corrige rarement la requête lente du moment.
- Tuer des sessions avant d’avoir identifié le bloqueur de tête, ou tuer la session bloquée au lieu du bloqueur.
- Faire plusieurs changements à la fois : vous ne saurez plus lequel a aidé.
- Utiliser
NOLOCKcomme correctif de blocage en acceptant des résultats incohérents. - Accuser le CPU parce qu’il est visible, en ignorant la requête qui fait le travail.
Notes de production
Les DMV sont des structures partagées en production : gardez les requêtes de diagnostic ciblées et évitez les interrogations trop fréquentes. Lorsque c’est possible, enregistrez les résultats hors de l’instance concernée. Les autorisations varient selon la version de SQL Server et le modèle d’hébergement. Query Store fournit un historique durable des requêtes et des plans, mais il faut vérifier son mode de capture, sa limite de taille, son nettoyage et son état de lecture/écriture avant de s’y fier.
Après une modification, mesurez la même charge : durée, CPU, lectures logiques, écritures, nombre d’exécutions, attentes et taux d’erreur. Si les éléments observés ne s’améliorent pas, revenez en arrière lorsque c’est possible sans risque et réévaluez l’hypothèse. Le but n’est pas seulement de faire disparaître l’alerte : il faut comprendre ce qui a changé et démontrer que le système se comporte mieux.
Après le triage
Une fois le symptôme cerné pendant les 15 premières minutes, poursuivez avec la démarche complète d’optimisation des performances SQL Server. Utilisez les requêtes en cours et les blocages pour les éléments en direct, ou les régressions Query Store lorsque le ralentissement est déjà passé. La fiche flux de diagnostic résume les mêmes décisions, et le runbook de blocage SQL Server (en anglais) est la procédure pour un incident de blocage en cours.
Sources
- Microsoft Learn : sys.dm_exec_requests (y compris les autorisations), sys.dm_os_wait_stats, superviser les performances avec le Magasin des requêtes, plans d’exécution
- Guides de dépannage Microsoft : comprendre et résoudre les blocages, résoudre une utilisation élevée du CPU, résoudre les lenteurs dues aux E/S
Vérifié sur Microsoft Learn en novembre 2026. Sur SQL Server 2022 et versions ultérieures, l’autorisation des DMV est VIEW SERVER PERFORMANCE STATE.
Ce contenu vous a-t-il été utile ?
Que pourrions-nous améliorer ?
Merci — cela m’aide à améliorer Javi Builds.
Continuer à apprendre
- Aide-mémoireDémarche de diagnostic des performances SQL ServerAppliquez une démarche de diagnostic SQL Server reproductible pour distinguer blocages, CPU, E/S, attentes, régressions de requêtes et pression de charge avant de modifier quoi que ce soit.Ouvrir l’aide-mémoire
- Feuille de routeSQL Server Troubleshooting & DiagnosticsUne séquence de triage en production qui transforme un ralentissement vague en faits et en prochaine étape sûre durant les 10 à 15 premières minutes.Voir la feuille de route
Que devrais-je créer ensuite ?
Je développe Javi Builds autour des problèmes concrets rencontrés par les data engineers. Dites-moi quel sujet vous aimeriez voir ensuite.
Restez au courant
Recevez uniquement les nouvelles de Javi Builds qui vous intéressent.
Consultez votre boîte de réception
Je vous ai envoyé un lien de confirmation. Votre abonnement sera actif après confirmation.