SQL Server
SQL Server va lento: los primeros 15 minutos de triaje
Una secuencia de triaje en producción para convertir una lentitud imprecisa en evidencias y un siguiente paso seguro durante los primeros 10–15 minutos.
En este artículo
Respuesta corta: en los primeros 15 minutos, responde dos preguntas antes de cambiar nada. ¿El problema afecta a todo el servidor o a una sola carga, base de datos o consulta? ¿Y qué señal domina: CPU, E/S, bloqueos, presión de memoria o una consulta costosa? Captura la evidencia volátil mientras las respondes y después pasa a la investigación profunda adecuada. Esta guía cubre solo ese triaje, no la optimización.
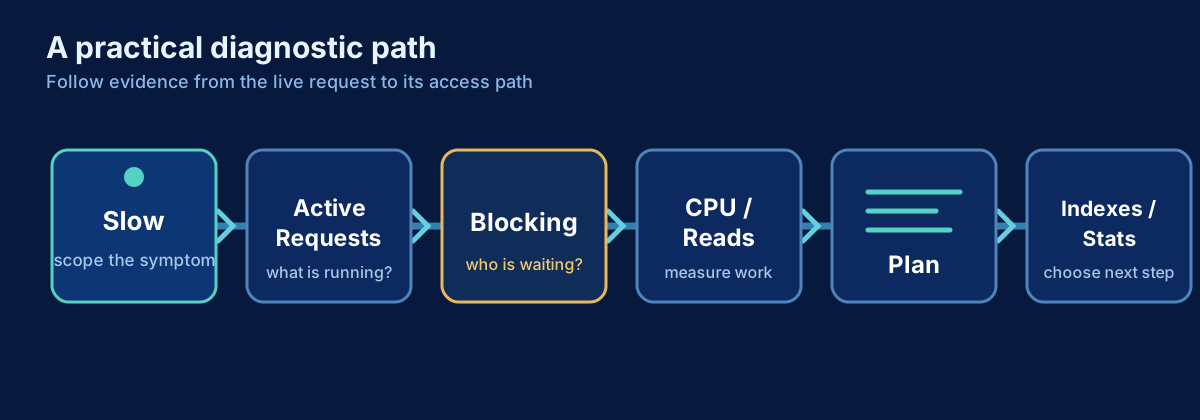
El flujo más seguro pasa del alcance a las evidencias y solo después a los cambios. Captura las evidencias volátiles antes de terminar una sesión, reiniciar un servicio, borrar la caché de planes o reconstruir un índice. Esas acciones pueden eliminar los síntomas y las evidencias sin resolver la causa.
- SQL Server va lentoAnota el síntoma, la carga y la ventana de tiempo
- ¿Todo el servidor o una carga?Todas las aplicaciones, una base de datos o una operación
- CPU altaCPUSolicitudes con más CPU, compilaciones, paralelismo
- esperas de E/SI/OPrimero lecturas por consulta, luego latencia del almacenamiento
- esperas de bloqueoBloqueosBloqueador principal y luego el runbook de bloqueos de SQL Server
- memoriaOtras esperasConcesiones de memoria, RESOURCE_SEMAPHORE, red
- una instrucciónConsulta costosaPlan, lecturas, estimaciones de filas
- plan cambiadoRegresión de planComparar ventanas de tiempo en Query Store
Problema: definir qué significa «lento»
Empieza por la carga afectada y el horario. Pregunta si todas las aplicaciones van lentas o solo una operación, si los fallos son continuos o intermitentes y si el problema ocurre ahora. Registra la base de datos, la duración esperada y la observada, la aplicación, el login, el host y un identificador de solicitud de ejemplo si la aplicación lo proporciona.
«Los informes de ReportingDb tardan 90 segundos en lugar de 8 desde las 14:10» es un dato útil. Indica una base de datos y un intervalo que se pueden comparar con Query Store, monitoreo, despliegues y trabajos programados. «El CPU está alto» no equivale a «la causa es el CPU». Un trabajo útil, un scan provocado por una mala estimación y el consumo por compilaciones repetidas pueden usar CPU por motivos diferentes.
Diagnóstico rápido: ¿actual o histórico?
Si la lentitud ocurre ahora, inspecciona primero las solicitudes activas y los bloqueos. Las vistas de administración dinámica ofrecen una instantánea del estado actual: ejecuta la consulta más de una vez y guarda los resultados con una marca de tiempo. Si la lentitud ya terminó, usa Query Store, el historial de monitoreo, Extended Events, la telemetría de aplicación y el historial de jobs. La caché de planes puede ayudar, pero no es un registro de auditoría duradero y puede perder entradas por eviction, recompilación, reinicio, failover o acciones que limpien la caché.
Antes de cambiar nada, captura:
- la hora del reporte y la hora del servidor, incluida la zona horaria;
- los identificadores de sesión y solicitud activos;
- base de datos, login, host, aplicación y texto SQL;
- estado, tipo de espera, sesión bloqueadora, CPU, lecturas, escrituras y tiempo transcurrido;
- el plan de ejecución pertinente o los identificadores de consulta y plan de Query Store;
- despliegues recientes, cambios de configuración, mantenimiento y volúmenes de carga inusuales.
Consulta: capturar solicitudes activas
Ejecuta esto con un login que tenga VIEW SERVER STATE en las versiones que lo requieren. En versiones más recientes, el permiso puede ser VIEW SERVER PERFORMANCE STATE. La consulta es de solo lectura y excluye su propia sesión.
SELECT
    SYSDATETIMEOFFSET() AS captured_at,
    r.session_id,
    r.request_id,
    DB_NAME(r.database_id) AS database_name,
    s.login_name,
    s.host_name,
    s.program_name,
    r.status,
    r.command,
    r.wait_type,
    r.wait_time AS wait_time_ms,
    NULLIF(r.blocking_session_id, 0) AS blocking_session_id,
    r.cpu_time AS cpu_time_ms,
    r.logical_reads,
    r.reads AS physical_reads,
    r.writes,
    r.total_elapsed_time AS elapsed_time_ms,
    SUBSTRING(
        text_info.text,
        (r.statement_start_offset / 2) + 1,
        ((CASE r.statement_end_offset
            WHEN -1 THEN DATALENGTH(text_info.text)
            ELSE r.statement_end_offset
          END - r.statement_start_offset) / 2) + 1
    ) AS current_statement
FROM sys.dm_exec_requests AS r
INNER JOIN sys.dm_exec_sessions AS s
    ON s.session_id = r.session_id
OUTER APPLY sys.dm_exec_sql_text(r.sql_handle) AS text_info
WHERE s.is_user_process = 1
  AND r.session_id <> @@SPID
ORDER BY r.total_elapsed_time DESC;Notas
- línea 13NULLIF convierte 0 (no bloqueada) en NULL, así solo los bloqueos reales muestran un valor.
- líneas 19–26Extrae del lote la instrucción que se ejecuta ahora: los desplazamientos son bytes en un texto Unicode y -1 significa el final del lote.
- línea 30OUTER APPLY conserva las solicitudes sin identificador SQL; CROSS APPLY las descartaría.
Cómo interpretar el resultado
Primero busca concentraciones. Una solicitud con mucha duración y poco CPU puede estar esperando; varias solicitudes con el mismo bloqueador pueden formar una cadena de bloqueos; muchas solicitudes costosas desde un mismo program_name pueden señalar un pico de actividad de la aplicación. wait_type explica qué está esperando una solicitud en ese momento, no la causa raíz. Una espera de lock dirige la investigación hacia el bloqueador. PAGEIOLATCH_* indica espera por una página de datos procedente del almacenamiento, pero la siguiente pregunta es por qué se necesitaba esa página. ASYNC_NETWORK_IO puede significar que el cliente consume las filas lentamente o, sencillamente, que la consulta devuelve demasiadas.
Compara la duración con el CPU. Una duración alta y poco CPU suele indicar espera. Un CPU y unas lecturas lógicas altos suelen justificar la inspección del plan. Las escrituras pueden ser cambios de datos, actividad de worktables o mantenimiento. Interpreta siempre los contadores en el contexto de la carga: un proceso ETL nocturno no es comparable con una consulta API de una sola fila.
Qué puede significar el resultado
Un identificador de sesión bloqueadora conduce al flujo de diagnóstico de bloqueos: localiza al bloqueador principal, inspecciona su transacción y SQL y determina por qué permanece abierta. Los scans repetidos y las lecturas lógicas altas conducen al plan, las estimaciones, los índices, las estadísticas, los predicados y el tamaño de las tablas. Un plan que acaba de cambiar conduce a Query Store y a comparar intervalos. Una carga concentrada por login, host o programa conduce a investigar la aplicación que llama, el pool de conexiones, la concurrencia, los reintentos o un proceso programado.
Si la instantánea activa parece normal, no concluyas que no pasó nada. La solicitud costosa quizá terminó entre muestras. Pasa a las evidencias históricas y verifica que la captura de Query Store esté habilitada y funcione correctamente. Compara el intervalo del incidente con otro conocido como bueno, no con horas sin relación y cargas diferentes.
Qué revisar después
Inspecciona el plan de ejecución solo después de identificar la instrucción. Compara las filas estimadas con las reales cuando puedas recopilar un plan real de forma segura. Comprueba si las estadísticas representan la distribución actual de los datos y si un índice existente admite los predicados. Una sugerencia de índice que falta es una señal para investigar, no una autorización para crearlo. Revisa solapamiento, anchura, costo de escritura y el plan real.
Después revisa el historial de cambios: despliegues de código y esquema, nivel de compatibilidad, configuración de ámbito de base de datos, patrones de parámetros, crecimiento de datos, mantenimiento de estadísticas, infraestructura, failover y jobs programados. Un cambio reciente es una hipótesis que hay que probar, no una prueba.
Qué no hacer
- Reiniciar SQL Server antes de capturar evidencias: se vacían las DMV, la caché de planes y las esperas que necesitabas.
- Borrar la caché de planes de todo el servidor para arreglar una consulta: todo se recompila y la evidencia desaparece.
- Reconstruir todos los índices «por si acaso»: cuesta E/S y log, y rara vez arregla la consulta que va lenta ahora.
- Terminar sesiones antes de identificar el bloqueador principal, o terminar la sesión bloqueada en lugar del bloqueador.
- Hacer varios cambios a la vez: pierdes la capacidad de saber cuál ayudó.
- Usar
NOLOCKcomo solución a los bloqueos aceptando resultados incoherentes. - Culpar a la CPU porque es visible, ignorando la consulta que hace el trabajo.
Notas de producción
Las DMV son estructuras compartidas de producción; mantén las consultas de diagnóstico acotadas y evita sondearlas con demasiada frecuencia. Cuando sea práctico, guarda los resultados fuera de la instancia afectada. Los permisos varían según la versión de SQL Server y el modelo de alojamiento. Query Store aporta un historial duradero de consultas y planes, pero antes de depender de él debes revisar el modo de captura, el límite de tamaño, la limpieza y el estado de lectura/escritura.
Después de un cambio, mide la misma carga: duración, CPU, lecturas lógicas, escrituras, cantidad de ejecuciones, esperas y tasa de errores. Si las evidencias no mejoran, revierte el cambio cuando sea seguro y revisa de nuevo la hipótesis. El objetivo no es solo hacer desaparecer la alerta, sino entender qué condición cambió y demostrar que el sistema funciona mejor.
Después del triaje
Cuando los primeros 15 minutos hayan acotado el síntoma, continúa con el flujo completo de optimización del rendimiento de SQL Server. Usa las consultas en ejecución y los bloqueos para la evidencia en vivo, o las regresiones con Query Store cuando la lentitud ya haya pasado. La ficha flujo de diagnóstico resume las mismas decisiones, y el runbook de bloqueos de SQL Server (en inglés) es el procedimiento para un incidente de bloqueo activo.
Fuentes
- Microsoft Learn: sys.dm_exec_requests (incluidos los permisos), sys.dm_os_wait_stats, supervisar el rendimiento con el Almacén de consultas, planes de ejecución
- Guías de solución de problemas de Microsoft: comprender y resolver bloqueos, solucionar el uso elevado de CPU, solucionar la lentitud causada por E/S
Revisado en Microsoft Learn en noviembre de 2026. En SQL Server 2022 y versiones posteriores, el permiso de las DMV es VIEW SERVER PERFORMANCE STATE.
¿Te resultó útil este contenido?
¿Qué podríamos mejorar?
Gracias — esto me ayuda a mejorar Javi Builds.
Sigue aprendiendo
- Guía rápidaFlujo de diagnóstico de rendimiento de SQL ServerUsa un flujo de diagnóstico de SQL Server repetible para distinguir bloqueos, CPU, E/S, esperas, regresiones de consultas y presión de carga antes de cambiar nada.Abrir guía rápida
- Hoja de rutaSQL Server Troubleshooting & DiagnosticsUna secuencia de triaje en producción para convertir una lentitud imprecisa en evidencias y un siguiente paso seguro durante los primeros 10–15 minutos.Ver hoja de ruta
¿Qué debería crear después?
Estoy construyendo Javi Builds alrededor de problemas reales que enfrentan los ingenieros de datos. Dime qué tema te gustaría ver después.
Mantente al día
Recibe solo las novedades de Javi Builds que realmente te interesan.
Revisa tu bandeja de entrada
Te he enviado un enlace de confirmación. Tu suscripción se activará cuando la confirmes.