Microsoft Fabric
Répliquer des tables Azure SQL dans Microsoft Fabric et les interroger depuis un notebook
Répliquez une table Azure SQL Database dans OneLake avec Microsoft Fabric Mirroring, vérifiez les prérequis réseau et d’identité, puis interrogez les données depuis un notebook avec Spark SQL et PySpark.
Dans cet article
Microsoft Fabric Mirroring permet de rendre les données opérationnelles d’Azure SQL disponibles dans OneLake sans avoir à créer et planifier un pipeline de copie classique.
Dans ce tutoriel, nous allons répliquer une petite table dbo.tenant d’Azure SQL Database dans Microsoft Fabric, vérifier que les modifications sont répliquées, puis interroger directement la table répliquée depuis un Fabric Notebook.
L’architecture est simple :
- Azure SQL Database
- Fabric MirroringFabric Mirrored Database
- OneLake
- Fabric Notebook
Le point essentiel est qu’Azure SQL reste le système opérationnel de référence. Fabric reçoit une copie synchronisée, orientée lecture, utilisable pour l’analytique, les notebooks, le reporting et les traitements de données en aval.
Toutes les captures de cet article portent un filigrane Javi Builds et ont été nettoyées afin d’en retirer les informations personnelles propres à l’environnement.
Pourquoi utiliser Fabric Mirroring ?
Un modèle d’intégration courant consiste à copier périodiquement des tables opérationnelles vers une plateforme analytique au moyen d’un pipeline.
C’est une solution qui fonctionne, mais lorsque les données doivent rester synchronisées avec Azure SQL, Fabric Mirroring permet de réduire considérablement la plomberie nécessaire.
Au lieu de ceci :
- Azure SQL
- Pipeline planifiéFichiers de dépôt
- Lakehouse
vous pouvez utiliser :
- Azure SQL
- Réplication continueOneLake
Cette approche présente plusieurs avantages :
- Pas de logique personnalisée de copie incrémentielle pour les tables prises en charge.
- Pas de pipeline d’interrogation à lancer toutes les quelques minutes.
- Les insertions, mises à jour et suppressions peuvent être répliquées automatiquement.
- Les données répliquées sont accessibles dans Fabric et OneLake.
- Les notebooks Fabric peuvent interroger directement la base répliquée.
- La base Azure SQL continue de servir la charge applicative.
Pour des données applicatives opérationnelles qui doivent également être accessibles dans Fabric, c’est un modèle très intéressant.
1. Créer une table source dans Azure SQL
Pour cette preuve de concept, nous avons utilisé une simple table de tenants.
CREATE TABLE dbo.tenant
(
    tenant_id INT NOT NULL PRIMARY KEY,
    tenant_name NVARCHAR(100) NOT NULL,
    status INT NOT NULL,
    created_date DATETIME2 NOT NULL,
    ended_date DATETIME2 NULL
);Vous pouvez insérer une ligne d’exemple avec :
INSERT INTO dbo.tenant
(
    tenant_id,
    tenant_name,
    status,
    created_date,
    ended_date
)
VALUES
(
    1,
    N'tenant_test',
    1,
    SYSUTCDATETIME(),
    NULL
);Pour une architecture de production, je définirais normalement une contrainte par défaut pour created_date et documenterais la signification de chaque valeur de status, ou la décrirais dans une table de référence.
2. Créer la base Azure SQL répliquée dans Fabric
Dans Microsoft Fabric :
- Ouvrez l’espace de travail cible.
- Choisissez New item.
- Sélectionnez Mirrored Azure SQL Database.
- Saisissez le serveur et la base Azure SQL.
- Configurez la connexion.
- Sélectionnez les tables à répliquer.
- Créez la base de données répliquée.
Dans cet exemple, seule la table suivante est nécessaire :
dbo.tenantFabric propose également une option semblable à :
Automatically mirror future tablesActivez-la uniquement si vous souhaitez réellement que les nouvelles tables éligibles créées dans la base source soient ajoutées automatiquement. Dans un environnement de production soumis à une gouvernance stricte, je préfère généralement sélectionner explicitement les tables qui doivent faire partie du jeu de données répliqué.
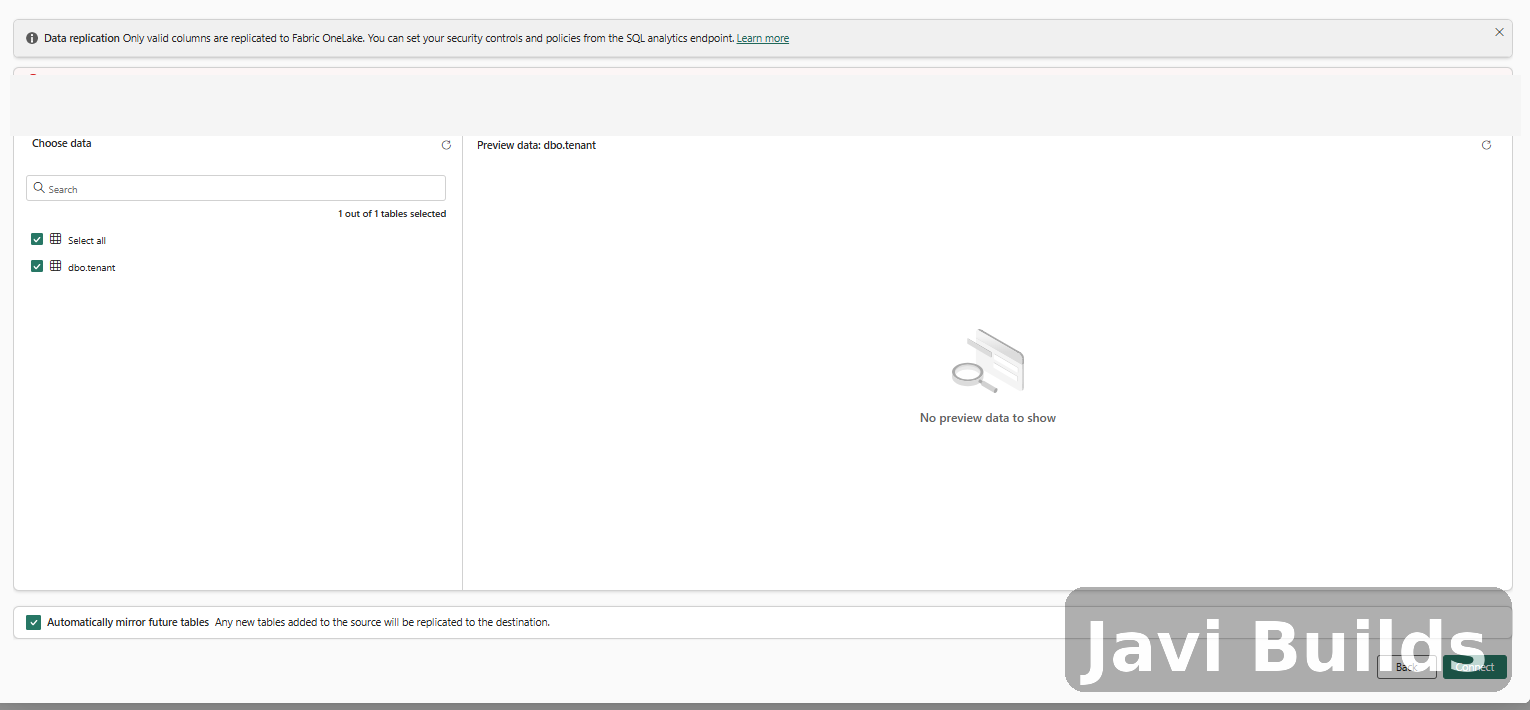
Sélection de la table Azure SQL que Fabric va répliquer dans OneLake.
3. Prérequis Azure SQL susceptibles de vous bloquer
L’assistant de configuration de Mirroring peut révéler plusieurs prérequis côté Azure, faciles à manquer.
Pendant cette preuve de concept, les points importants concernaient l’identité, l’authentification et l’accès réseau.
Accès réseau
Fabric doit pouvoir joindre le serveur logique Azure SQL.
Si le pare-feu SQL bloque la connexion, vous pouvez recevoir une erreur semblable à :
Client with IP address 'x.x.x.x' is not allowed to access the server.Pour une preuve de concept rapide, vous pouvez ajouter l’adresse IP requise au pare-feu du serveur Azure SQL.
En production, étudiez un modèle réseau plus contrôlé, comme une connectivité fondée sur un VNet ou une connexion privée, plutôt que d’ouvrir largement l’accès au serveur SQL.
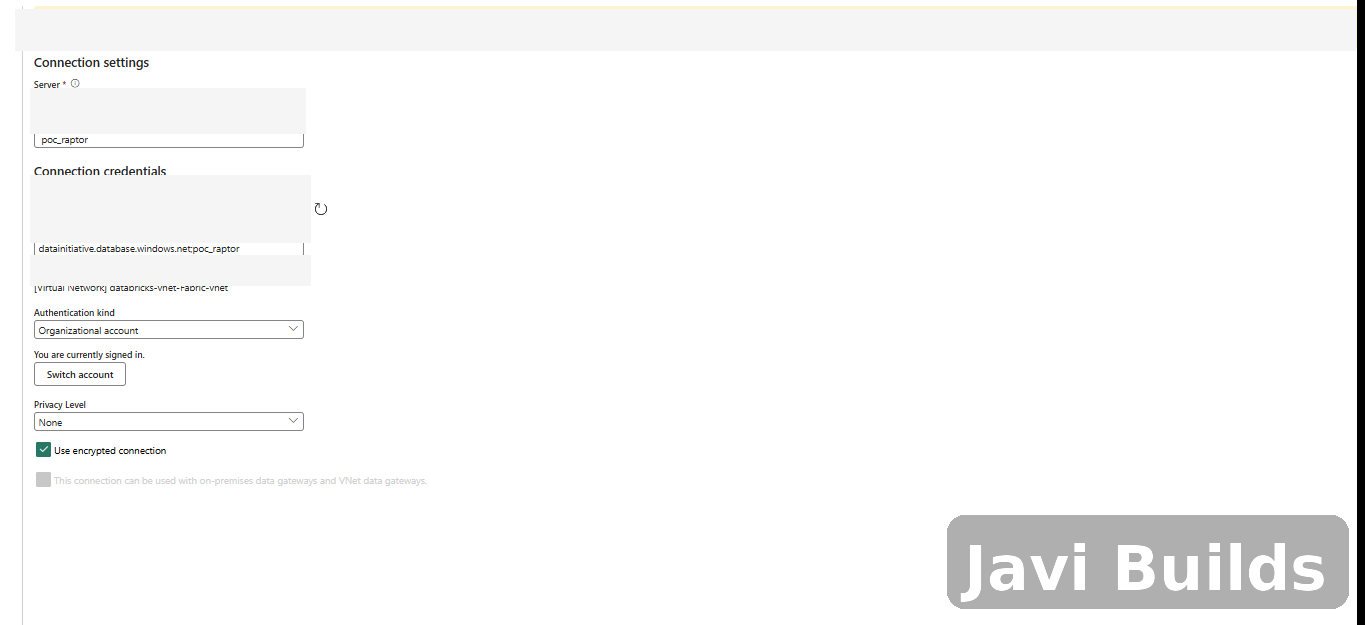
Azure SQL rejette la connexion tant que l’accès réseau requis n’est pas configuré.
4. Configurer l’authentification Microsoft Entra
Dans les environnements soumis à des contrôles Azure Policy plus stricts, vous devrez peut-être configurer l’authentification Microsoft Entra avant d’activer l’identité managée requise par Mirroring.
Au niveau du serveur logique Azure SQL :
SQL logical server
    ↓
Microsoft Entra ID
Vérifiez qu’un administrateur Microsoft Entra est configuré.
Selon les règles de votre organisation, vous devrez peut-être également activer :
Support only Microsoft Entra authentication for this serverSoyez prudent avec ce paramètre.
Lorsque l’authentification Microsoft Entra uniquement est activée, l’authentification SQL par nom d’utilisateur et mot de passe est désactivée pour le serveur. Avant de modifier ce paramètre sur un serveur de production, validez les connexions applicatives et administratives existantes.
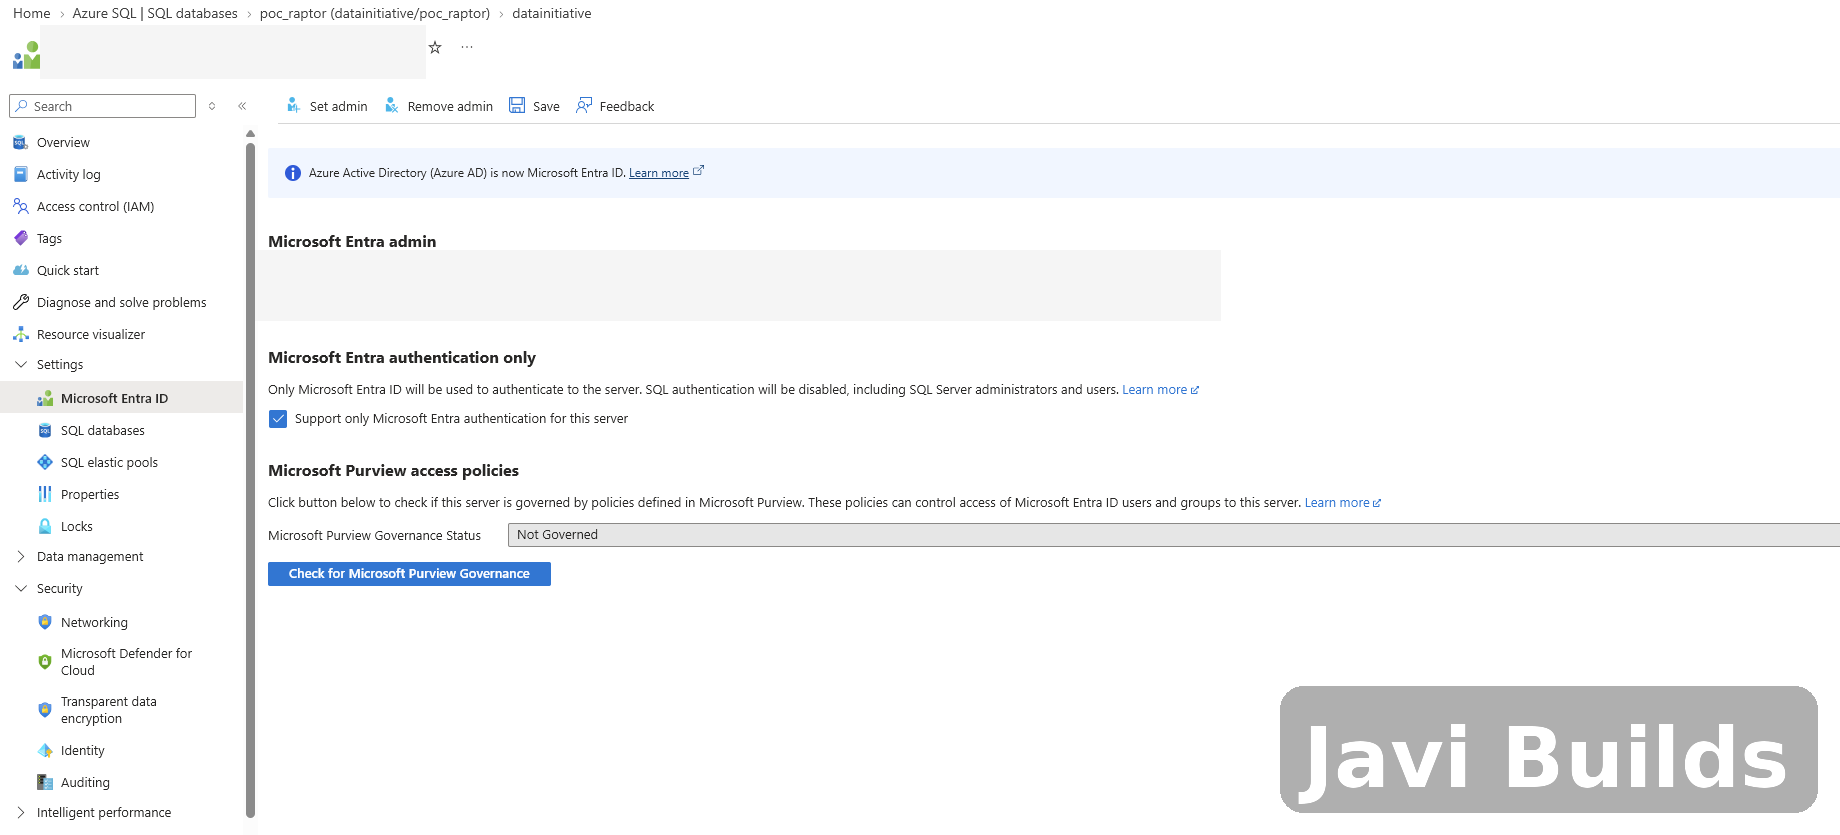
Paramètres d’authentification Microsoft Entra sur le serveur logique Azure SQL.
5. Activer l’identité managée du serveur SQL
Fabric Mirroring exige également que le serveur logique Azure SQL dispose d’une identité managée.
Accédez à :
SQL logical server
    ↓
Security
    ↓
Identity
Activez :
System assigned managed identity = OnL’identité managée attribuée par le système doit également être configurée comme identité principale appropriée du serveur SQL.
Si Azure Policy vous empêche de l’activer, examinez attentivement le message d’erreur de la stratégie. Dans certaines organisations, une stratégie exige d’abord l’authentification Microsoft Entra uniquement.
Il est utile de documenter cette dépendance : elle n’est pas évidente lors de la première création de la base répliquée.
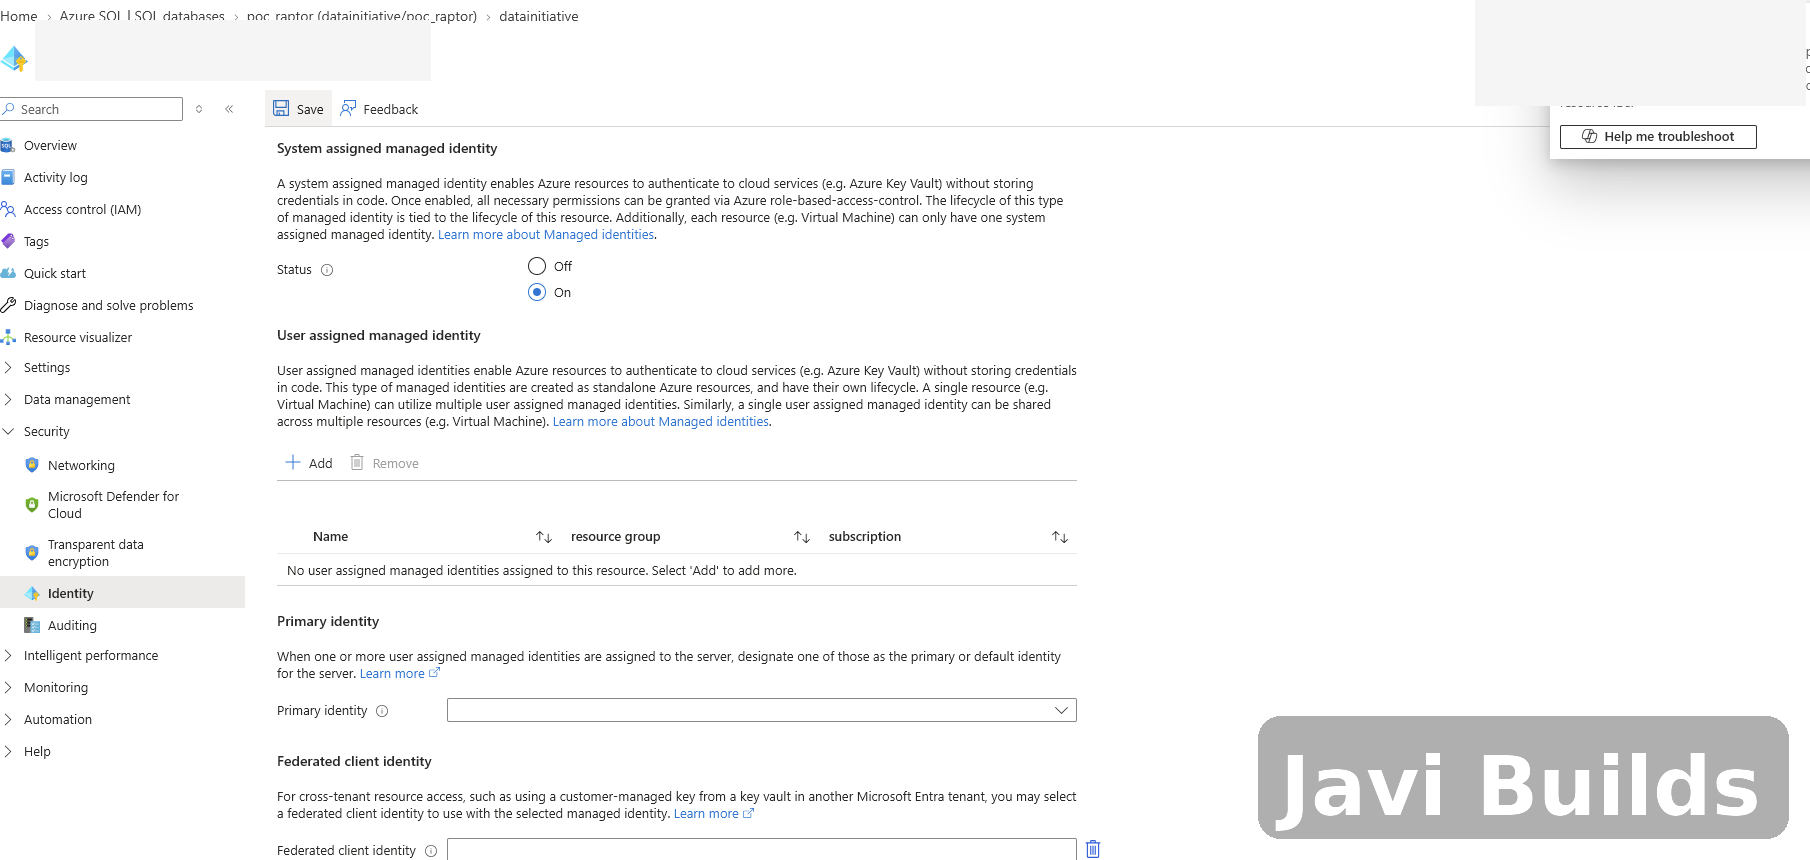
Activation de l’identité managée attribuée par le système, requise pour la configuration de Mirroring.
6. Créer la base de données répliquée
Une fois les prérequis réseau et d’identité satisfaits, retournez dans Fabric et poursuivez l’assistant.
Fabric crée un nouvel élément de base de données répliquée.
L’initialisation suit approximativement ces étapes :
- 1Valider la source
- 2Créer la base répliquée
- 3Initialiser la réplication
- 4Instantané initial
- 5Réplication continue
Pendant l’initialisation, vous pouvez voir :
Status: Startinget :
No data has landedC’est normal pendant la préparation de la synchronisation initiale.
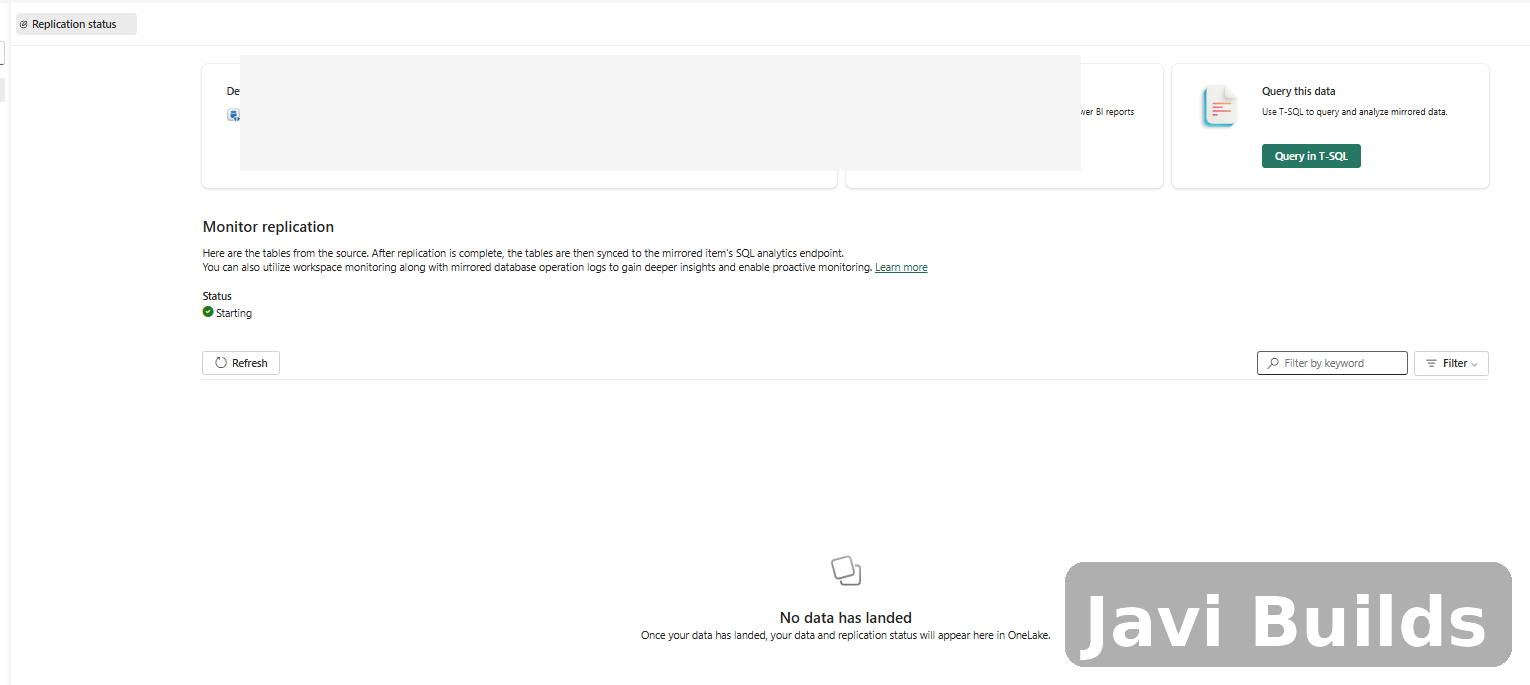
Fabric initialise la réplication et attend l’arrivée des premières données dans OneLake.
7. Comprendre les objets créés dans Fabric
Après la création de la base répliquée, Fabric expose plusieurs éléments associés dans l’espace de travail.
Vous verrez généralement :
Mirrored database
SQL analytics endpoint
Le SQL analytics endpoint fournit une interface SQL pour interroger les données répliquées.
La base de données répliquée expose les tables copiées dans OneLake.
Ce point est important : dans certaines parties de l’interface Fabric, l’élément répliqué peut ressembler à un Lakehouse, mais il ne s’agit pas simplement d’un Lakehouse créé manuellement par un utilisateur.
8. Ajouter la base répliquée à un notebook
Créez ou ouvrez un Fabric Notebook.
Dans le volet Data items :
Add data items
    ↓
OneLake catalog
    ↓
Select the mirrored database
Après l’ajout, vous devriez voir une structure semblable à celle-ci :
OneLake
  └─ mirrored_database
      └─ Schemas
          └─ dbo
              └─ Tables
                  └─ tenant
Vous pouvez développer la table et examiner ses colonnes directement dans l’explorateur du notebook.
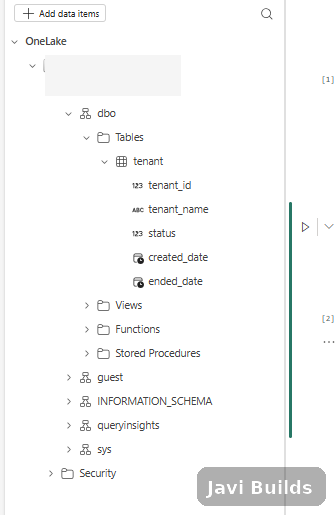
La table dbo.tenant répliquée est directement accessible dans l’explorateur du notebook.
9. Interroger la table répliquée avec Spark SQL
Un détail est particulièrement important.
Si aucun Lakehouse par défaut n’est associé au notebook, un nom en trois parties comme celui-ci :
SELECT *
FROM mirrored_database.dbo.tenant;peut échouer avec une erreur semblable à :
No default context found, please attach a lakehouse before running spark sql queries with partial namespaces.Vous n’avez pas nécessairement besoin d’associer un autre Lakehouse.
Utilisez le nom complet en quatre parties :
workspace.database.schema.tablePar exemple :
SELECT *
FROM demo_workspace.demo_mirror.dbo.tenant;Le notebook peut ainsi résoudre la table répliquée sans dépendre du contexte d’un Lakehouse par défaut.
10. Interroger la même table avec PySpark
Vous pouvez interroger le même objet avec spark.sql() :
df = spark.sql("""
    SELECT *
    FROM demo_workspace.demo_mirror.dbo.tenant
""")

display(df)Vous obtenez ainsi un Spark DataFrame que vous pouvez utiliser dans la suite de votre travail d’ingénierie Fabric.
Par exemple :
active_tenants = spark.sql("""
    SELECT
        tenant_id,
        tenant_name,
        created_date
    FROM demo_workspace.demo_mirror.dbo.tenant
    WHERE status = 1
""")

display(active_tenants)Vous pouvez ensuite joindre les données opérationnelles répliquées à d’autres données provenant d’un Lakehouse ou d’un Warehouse.
11. Valider la réplication continue
Voir la ligne initiale confirme que l’instantané a été chargé.
Le test le plus intéressant consiste à vérifier que les modifications ultérieures sont répliquées automatiquement.
Insérez une autre ligne dans Azure SQL :
INSERT INTO dbo.tenant
(
    tenant_id,
    tenant_name,
    status,
    created_date,
    ended_date
)
VALUES
(
    2,
    N'second_test',
    2,
    SYSUTCDATETIME(),
    NULL
);Relancez ensuite la requête du notebook Fabric :
SELECT *
FROM demo_workspace.demo_mirror.dbo.tenant
ORDER BY tenant_id;Lorsque la deuxième ligne apparaît, vous avez validé l’ensemble du parcours :
- INSERT Azure SQL
- Fabric Mirroring
- OneLake
- Spark SQL / PySpark
Aucun pipeline de copie n’a été lancé.
Aucun notebook n’a effectué l’ingestion.
La modification de la source a été répliquée par le service Mirroring.
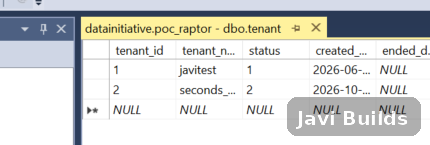
Ajout d’une deuxième ligne dans la table source Azure SQL pour valider la réplication continue.
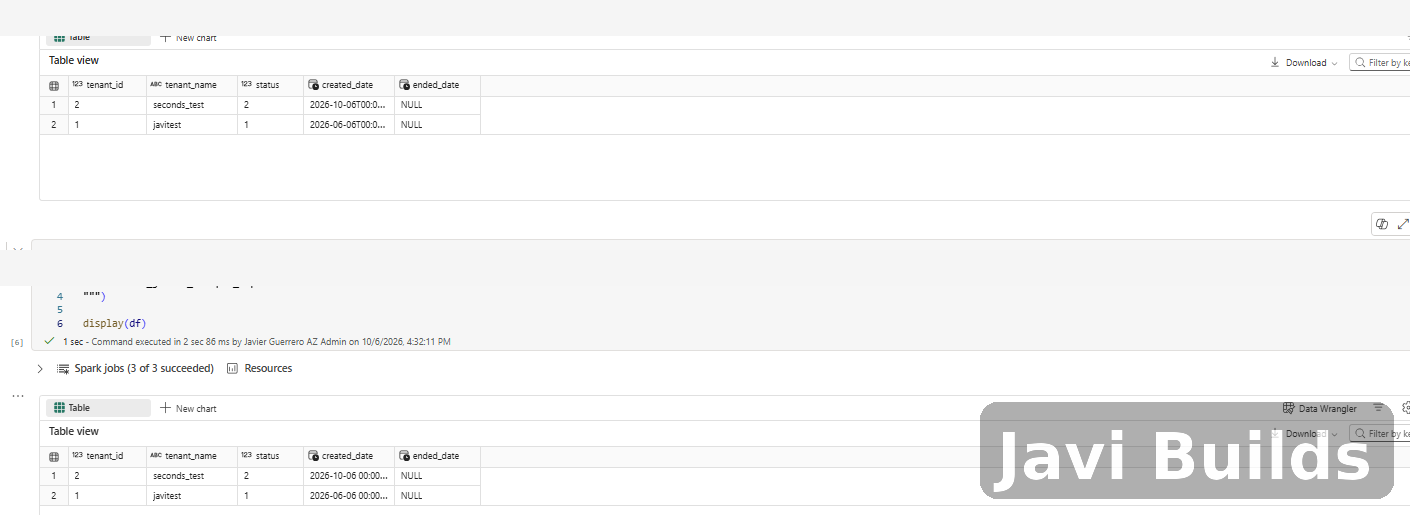
La nouvelle ligne Azure SQL apparaît dans Fabric sans exécuter de pipeline de copie.
Que s’est-il passé exactement ?
L’architecture finale est simple :
- Application / API
- Lecture / écritureAzure SQL DatabaseSource de vérité opérationnelle
- dbo.tenant
- Fabric MirroringFabric Mirrored DatabaseCopie synchronisée dans OneLake
- NotebooksSpark
- SQL Analytics Endpoint
L’application doit continuer à considérer Azure SQL comme le système transactionnel.
Fabric doit traiter les données répliquées comme une représentation analytique, orientée lecture, des données opérationnelles.
Cette séparation est importante.
Ne faites pas de la copie répliquée le point d’écriture de la configuration des tenants de votre application vers Azure SQL.
Le flux doit rester :
- Application
- Azure SQL
- Mirroring
- Fabric
et non :
- Application
- Réplique Fabric
- Azure SQL
Dans quels cas ce modèle devient-il utile ?
Une petite table tenant ne semble peut-être pas très impressionnante, mais ce modèle devient particulièrement utile lorsqu’on combine des métadonnées opérationnelles avec de grands jeux de données analytiques.
Imaginez qu’Azure SQL contienne :
tenant
merchant
application_configuration
report_configuration
feature_flags
et que Fabric contienne :
sales
registrations
commissions
clickstream
reporting aggregates
Mirroring permet à vos traitements Fabric de référencer des tables opérationnelles relativement petites sans créer un pipeline d’ingestion distinct pour chacune.
Un notebook pourrait alors exécuter une requête de ce type :
SELECT
    s.tenant_id,
    t.tenant_name,
    SUM(s.amount) AS total_sales
FROM analytics.sales s
JOIN demo_workspace.demo_mirror.dbo.tenant t
    ON s.tenant_id = t.tenant_id
GROUP BY
    s.tenant_id,
t.tenant_name;C’est dans une architecture multi-tenant que ce modèle devient particulièrement intéressant.
Points à prendre en compte en production
Mirroring est puissant, mais avant de l’adopter largement en production, j’examinerais plusieurs aspects.
Éligibilité des tables
Toutes les fonctionnalités SQL Server et tous les types de données ne sont pas nécessairement éligibles à la réplication. Validez le schéma des tables que vous souhaitez répliquer.
Réseau
Ne considérez pas une règle de pare-feu temporaire utilisée pour une preuve de concept comme l’architecture définitive.
En production, évaluez le modèle de connectivité privée ou fondée sur un VNet adapté à votre environnement.
Authentification
Comprenez les conséquences de l’activation de l’authentification Microsoft Entra uniquement avant de l’appliquer à un serveur SQL existant.
Identité
Documentez l’identité managée attribuée par le système du serveur logique SQL et les stratégies de l’organisation qui la régissent.
Sélection des tables
Déterminez si vous souhaitez vraiment que les futures tables soient répliquées automatiquement.
Dans les déploiements de production soumis à une gouvernance, la sélection explicite des tables est souvent plus facile à contrôler.
Responsabilités de lecture et d’écriture
Définissez clairement les responsabilités :
Azure SQL = opérations, lecture et écriture
Base répliquée Fabric = lecture analytique
Latence de réplication
Considérez Mirroring comme une réplication quasi temps réel ; ne supposez pas que le comportement est synchrone avec les transactions entre Azure SQL et Fabric.
Liste de contrôle de déploiement
Voici la liste que je conserverais avec l’implémentation :
Azure SQL
[ ] Base source créée
[ ] Schémas des tables sources pris en charge
[ ] Administrateur Microsoft Entra configuré
[ ] Authentification Microsoft Entra uniquement examinée/configurée si nécessaire
[ ] Identité managée attribuée par le système activée
[ ] Identité principale requise configurée
[ ] Accès réseau depuis Fabric validé

Microsoft Fabric
[ ] Base de données Azure SQL répliquée créée
[ ] Connexion à la source correcte sélectionnée
[ ] Tables requises sélectionnées
[ ] Décision relative à "Automatically mirror future tables" documentée
[ ] État de réplication sain
[ ] Données initiales arrivées dans OneLake

Validation
[ ] Base répliquée ajoutée à un Fabric Notebook
[ ] Nom d’objet Spark en quatre parties vérifié
[ ] Instantané initial interrogé avec succès
[ ] Nouvelle insertion source répliquée avec succès
[ ] Réplication d’une mise à jour testée
[ ] Réplication d’une suppression testée
Conclusion
Ce que j’apprécie dans ce modèle, c’est qu’il nécessite très peu de code d’ingestion personnalisé.
Pour cette preuve de concept, le parcours final se résumait à ceci :
- 1Créer une table Azure SQL
- 2Configurer le réseau SQL et l’identité
- 3Créer la base Fabric répliquée
- 4Sélectionner la table
- 5Attendre la synchronisation initiale
- 6Ajouter la base répliquée au notebook
- 7Interroger avec Spark
- 8Modifier les données sources
- 9Les voir apparaître dans Fabric
Il n’y avait ni logique de watermark incrémentiel, ni activité de copie à planifier, ni processus CDC personnalisé à maintenir.
Dans une architecture où Azure SQL gère l’état opérationnel et Microsoft Fabric l’analytique, Fabric Mirroring offre une passerelle très simple entre les deux.
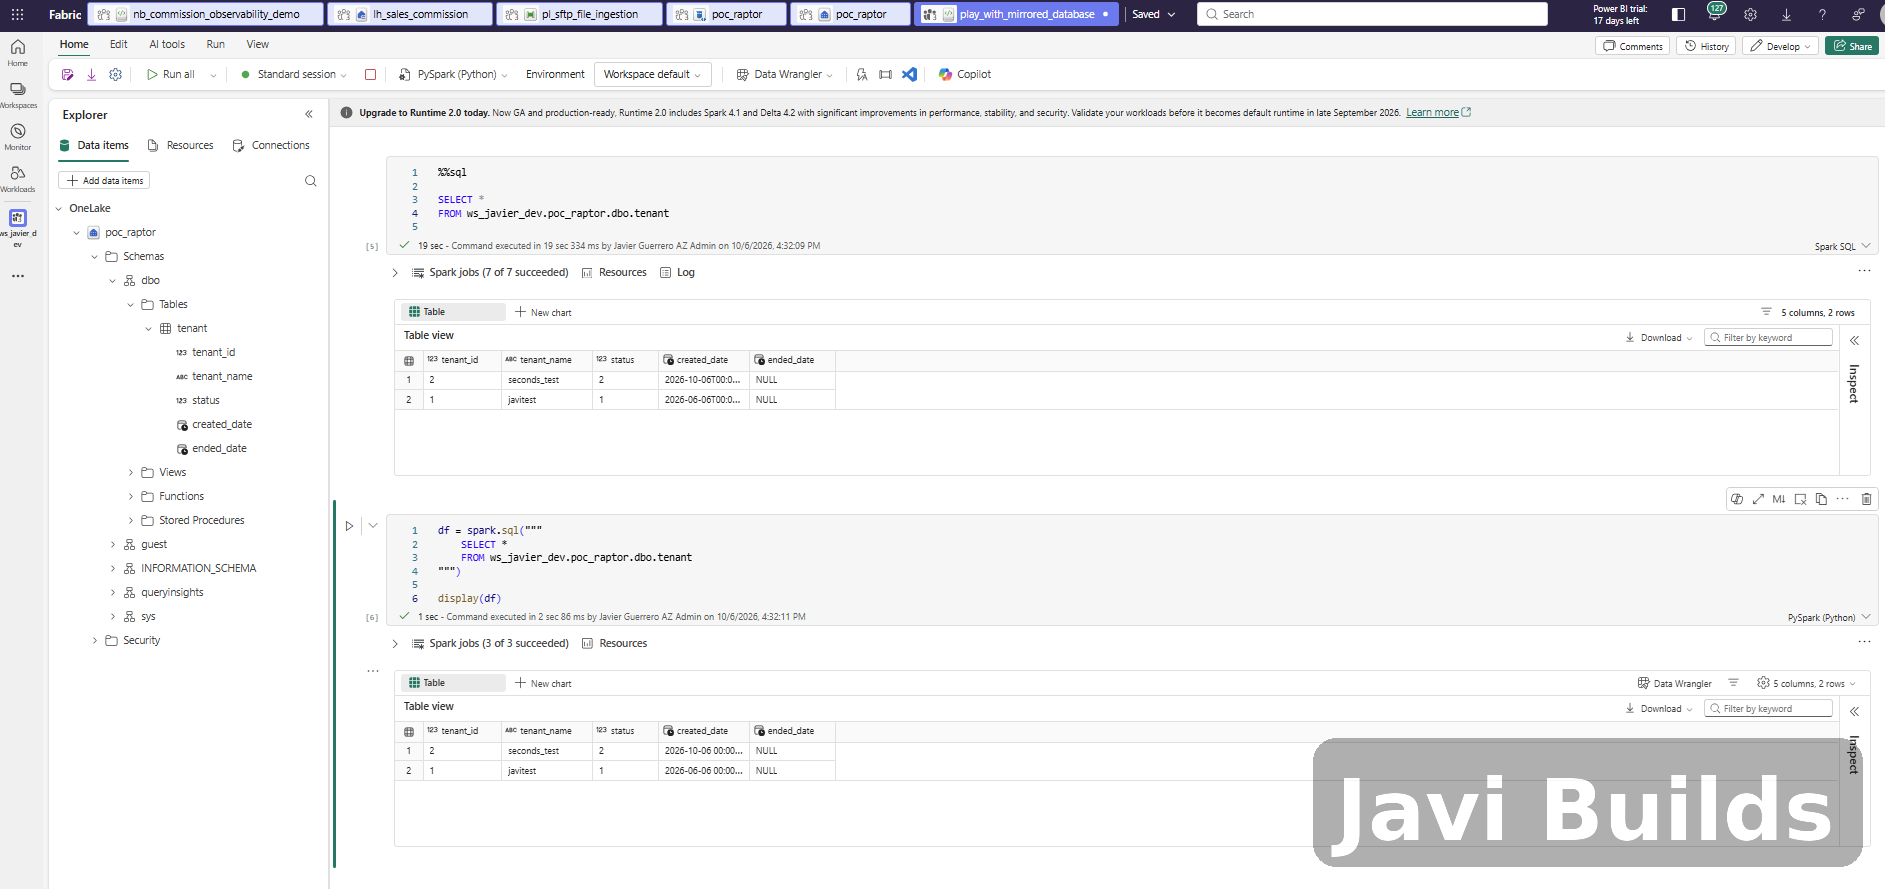
Vue complète du notebook montrant la table répliquée interrogée avec Spark SQL et PySpark.
Ce contenu vous a-t-il été utile ?
Que pourrions-nous améliorer ?
Merci — cela m’aide à améliorer Javi Builds.
Continuer à apprendre
- ArticleContenu en anglaisCreate Your First Fabric NotebookCreate a Microsoft Fabric notebook, attach it to a Lakehouse, build a small dataset with PySpark, write it as a Delta table and query it with Spark SQL, with every step explained.Lire l’article
- Aide-mémoireContenu en anglaisMicrosoft Fabric Workspace Settings Cheat SheetThe Microsoft Fabric workspace settings that change how a data engineering workspace behaves: Spark pools, environments and jobs, domain assignment, OneLake shortcut caching and diagnostics, and data workflow (Apache Airflow job) runtime pools, with what to verify for each.Ouvrir l’aide-mémoire
- RessourceContenu en anglaisMicrosoft Fabric Certification Study PlannerAn adaptable 6–8 week example plan that connects official Fabric certification objectives with hands-on practice, review, and exam readiness.Voir la ressource
Que devrais-je créer ensuite ?
Je développe Javi Builds autour des problèmes concrets rencontrés par les data engineers. Dites-moi quel sujet vous aimeriez voir ensuite.
Restez au courant
Recevez uniquement les nouvelles de Javi Builds qui vous intéressent.
Consultez votre boîte de réception
Je vous ai envoyé un lien de confirmation. Votre abonnement sera actif après confirmation.