Microsoft Fabric
Replicar tablas de Azure SQL en Microsoft Fabric y consultarlas desde un notebook
Replica una tabla de Azure SQL Database en OneLake con Microsoft Fabric Mirroring, comprueba los requisitos de red e identidad y consulta los datos desde un notebook con Spark SQL y PySpark.
En este artículo
Microsoft Fabric Mirroring permite disponer de datos operativos de Azure SQL en OneLake sin crear ni programar un pipeline de copia tradicional.
En este recorrido replicaremos una tabla pequeña, dbo.tenant, desde Azure SQL Database a Microsoft Fabric, comprobaremos que los cambios se replican y consultaremos la tabla replicada directamente desde un Fabric Notebook.
El objetivo es sencillo:
- Azure SQL Database
- Fabric MirroringFabric Mirrored Database
- OneLake
- Fabric Notebook
El punto arquitectónico importante es que Azure SQL sigue siendo el sistema operativo de registro. Fabric recibe una copia sincronizada y orientada a lectura que puede utilizarse para análisis, notebooks, informes e ingeniería de datos posterior.
Todas las capturas de este artículo llevan una marca de agua Javi Builds y se han depurado para eliminar información personal específica del entorno.
¿Por qué usar Fabric Mirroring?
Un patrón de integración habitual consiste en copiar periódicamente tablas operativas a una plataforma analítica mediante un pipeline.
Funciona, pero si los datos deben mantenerse sincronizados con Azure SQL, Fabric Mirroring puede eliminar buena parte de esa infraestructura adicional.
En vez de esto:
- Azure SQL
- Pipeline programadoArchivos de aterrizaje
- Lakehouse
puedes usar:
- Azure SQL
- Mirroring continuoOneLake
Esto ofrece varias ventajas:
- No hace falta lógica personalizada de copia incremental para las tablas compatibles.
- No se necesita un pipeline de sondeo cada pocos minutos.
- Las inserciones, actualizaciones y eliminaciones pueden replicarse automáticamente.
- Los datos replicados están disponibles en Fabric y OneLake.
- Los notebooks Fabric pueden consultar directamente la base de datos replicada.
- La base de Azure SQL sigue atendiendo la carga de la aplicación.
Es un patrón muy atractivo para datos operativos de aplicaciones que también deben estar disponibles en Fabric.
1. Crear una tabla de origen en Azure SQL
Para esta prueba de concepto usamos una tabla sencilla de tenants.
CREATE TABLE dbo.tenant
(
    tenant_id INT NOT NULL PRIMARY KEY,
    tenant_name NVARCHAR(100) NOT NULL,
    status INT NOT NULL,
    created_date DATETIME2 NOT NULL,
    ended_date DATETIME2 NULL
);Puedes insertar una fila de ejemplo con:
INSERT INTO dbo.tenant
(
    tenant_id,
    tenant_name,
    status,
    created_date,
    ended_date
)
VALUES
(
    1,
    N'tenant_test',
    1,
    SYSUTCDATETIME(),
    NULL
);En un diseño de producción normalmente usaría una restricción DEFAULT para created_date y definiría el significado de cada valor de status mediante documentación o una tabla de referencia.
2. Crear la base de Azure SQL replicada en Fabric
En Microsoft Fabric:
- Abre el workspace de destino.
- Selecciona New item.
- Elige Mirrored Azure SQL Database.
- Introduce el servidor y la base de datos de Azure SQL.
- Configura la conexión.
- Selecciona las tablas que quieres replicar.
- Crea la base de datos replicada.
En este ejemplo solo se necesita la tabla:
dbo.tenantFabric también ofrece una opción similar a:
Automatically mirror future tablesActívala solo si realmente quieres que las nuevas tablas aptas que se creen en la base de origen se añadan automáticamente. En un entorno de producción con controles estrictos, normalmente prefiero seleccionar explícitamente las tablas que deben formar parte del conjunto replicado.
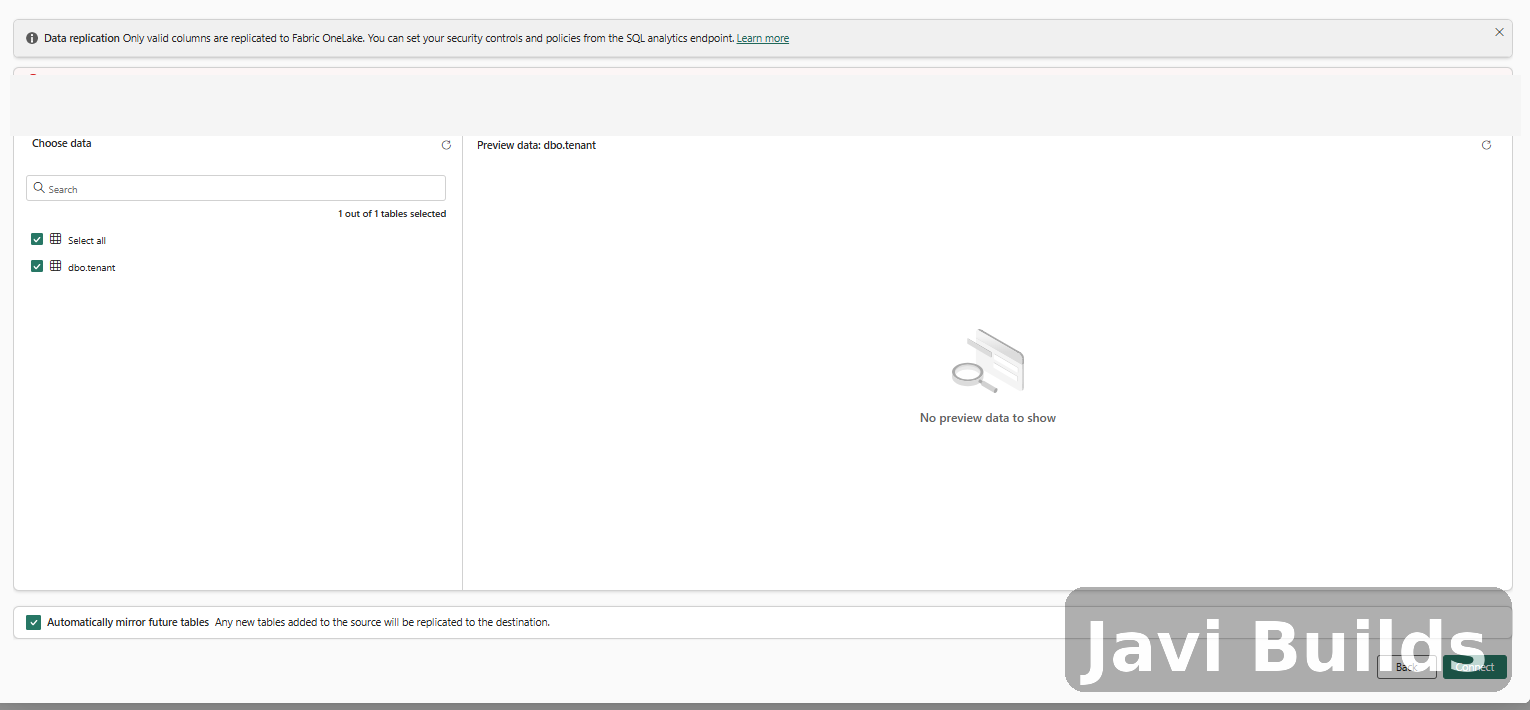
Selección de la tabla de Azure SQL que Fabric replicará en OneLake.
3. Requisitos previos de Azure SQL que puedes encontrar
El asistente de Mirroring puede revelar varios requisitos previos del lado de Azure que es fácil pasar por alto.
Durante esta prueba de concepto, los puntos importantes fueron identidad, autenticación y acceso de red.
Acceso de red
Fabric debe poder comunicarse con el servidor lógico de Azure SQL.
Si el firewall de SQL bloquea la conexión, puedes recibir un error parecido a este:
Client with IP address 'x.x.x.x' is not allowed to access the server.Para una prueba de concepto rápida, puedes añadir la dirección IP requerida al firewall del servidor de Azure SQL.
En producción, evalúa un modelo de red más controlado, como conectividad basada en VNet o conectividad privada, en lugar de abrir ampliamente el servidor SQL.
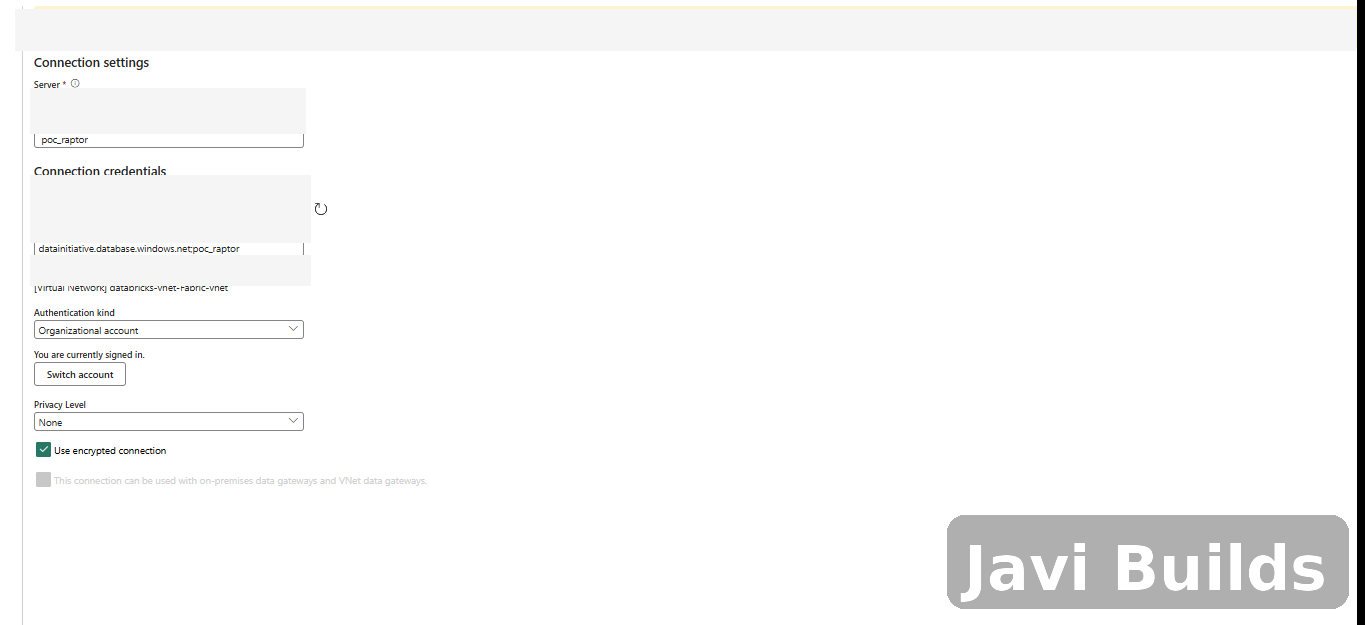
Azure SQL rechaza la conexión hasta que se configura el acceso de red requerido.
4. Configurar la autenticación de Microsoft Entra
En entornos con controles de Azure Policy más estrictos, quizá debas configurar la autenticación de Microsoft Entra antes de habilitar la identidad administrada que requiere Mirroring.
En el nivel del servidor lógico de Azure SQL:
SQL logical server
    ↓
Microsoft Entra ID
Asegúrate de que haya un administrador de Microsoft Entra configurado.
Según las políticas de tu organización, quizá también debas activar:
Support only Microsoft Entra authentication for this serverTen cuidado con esta opción.
Al habilitar solo la autenticación de Microsoft Entra, se desactiva para el servidor la autenticación SQL mediante nombre de usuario y contraseña. Antes de cambiarla en un servidor de producción, valida las conexiones de aplicación y administración existentes.
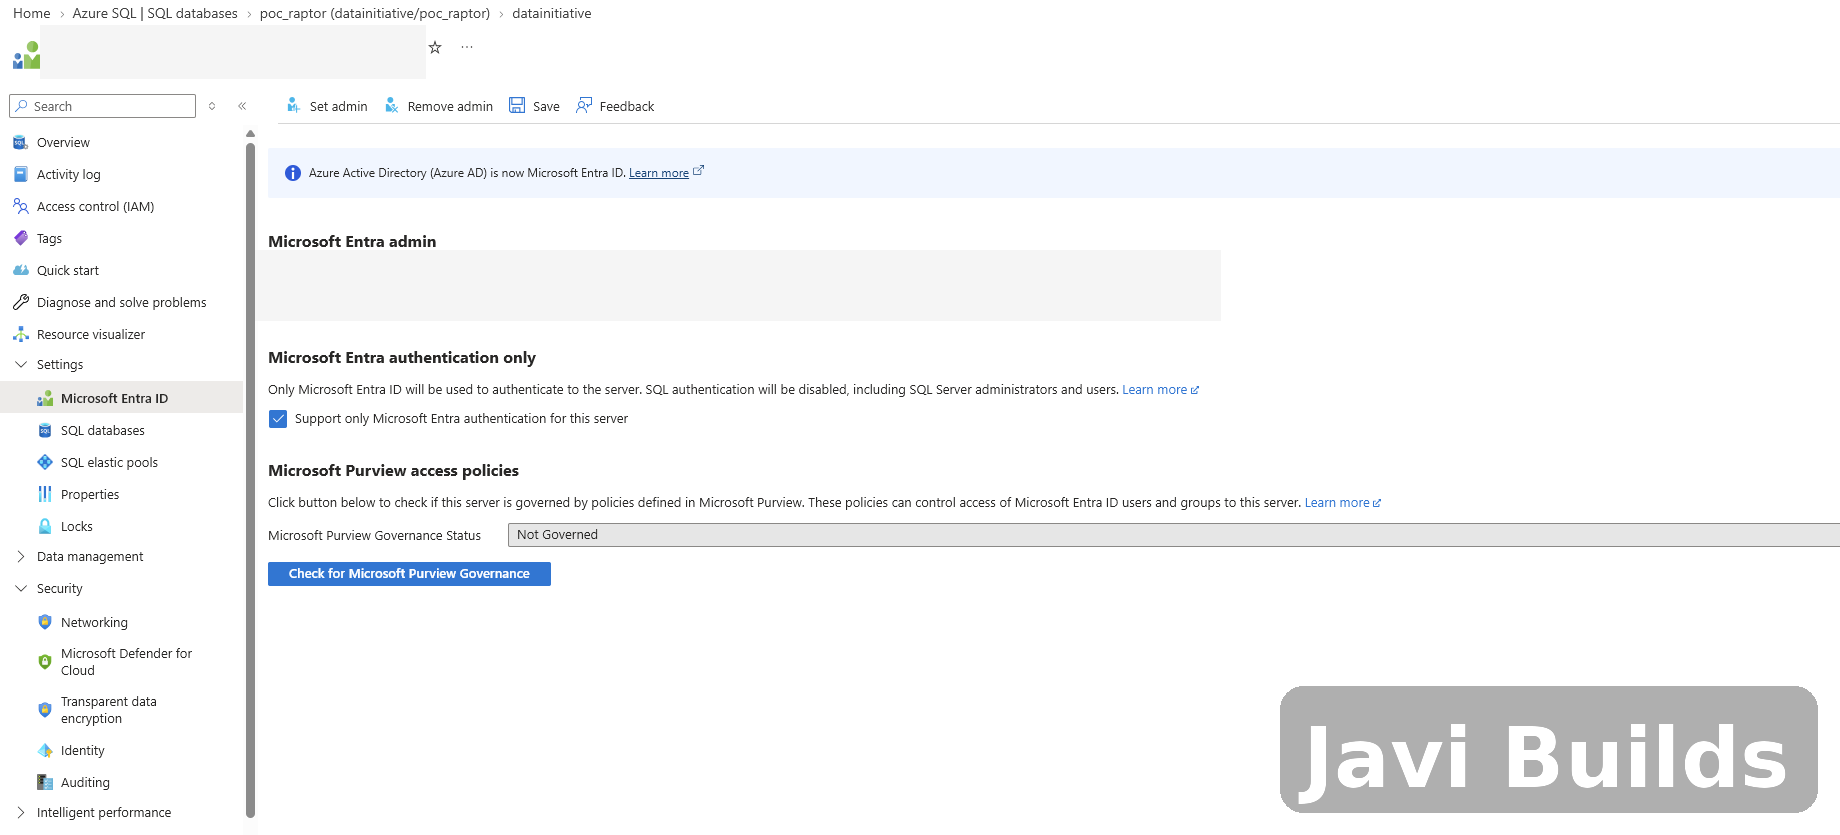
Configuración de autenticación de Microsoft Entra en el servidor lógico de Azure SQL.
5. Habilitar la identidad administrada del servidor SQL
Fabric Mirroring también requiere que el servidor lógico de Azure SQL tenga configurada una identidad administrada.
Ve a:
SQL logical server
    ↓
Security
    ↓
Identity
Activa:
System assigned managed identity = OnLa identidad administrada asignada por el sistema también debe configurarse como la identidad principal adecuada para el servidor SQL.
Si Azure Policy impide habilitarla, revisa con atención el error de la política. En algunas organizaciones, una política puede exigir que se habilite primero solo la autenticación de Microsoft Entra.
Conviene documentar esta dependencia porque no es evidente la primera vez que se crea la base replicada.
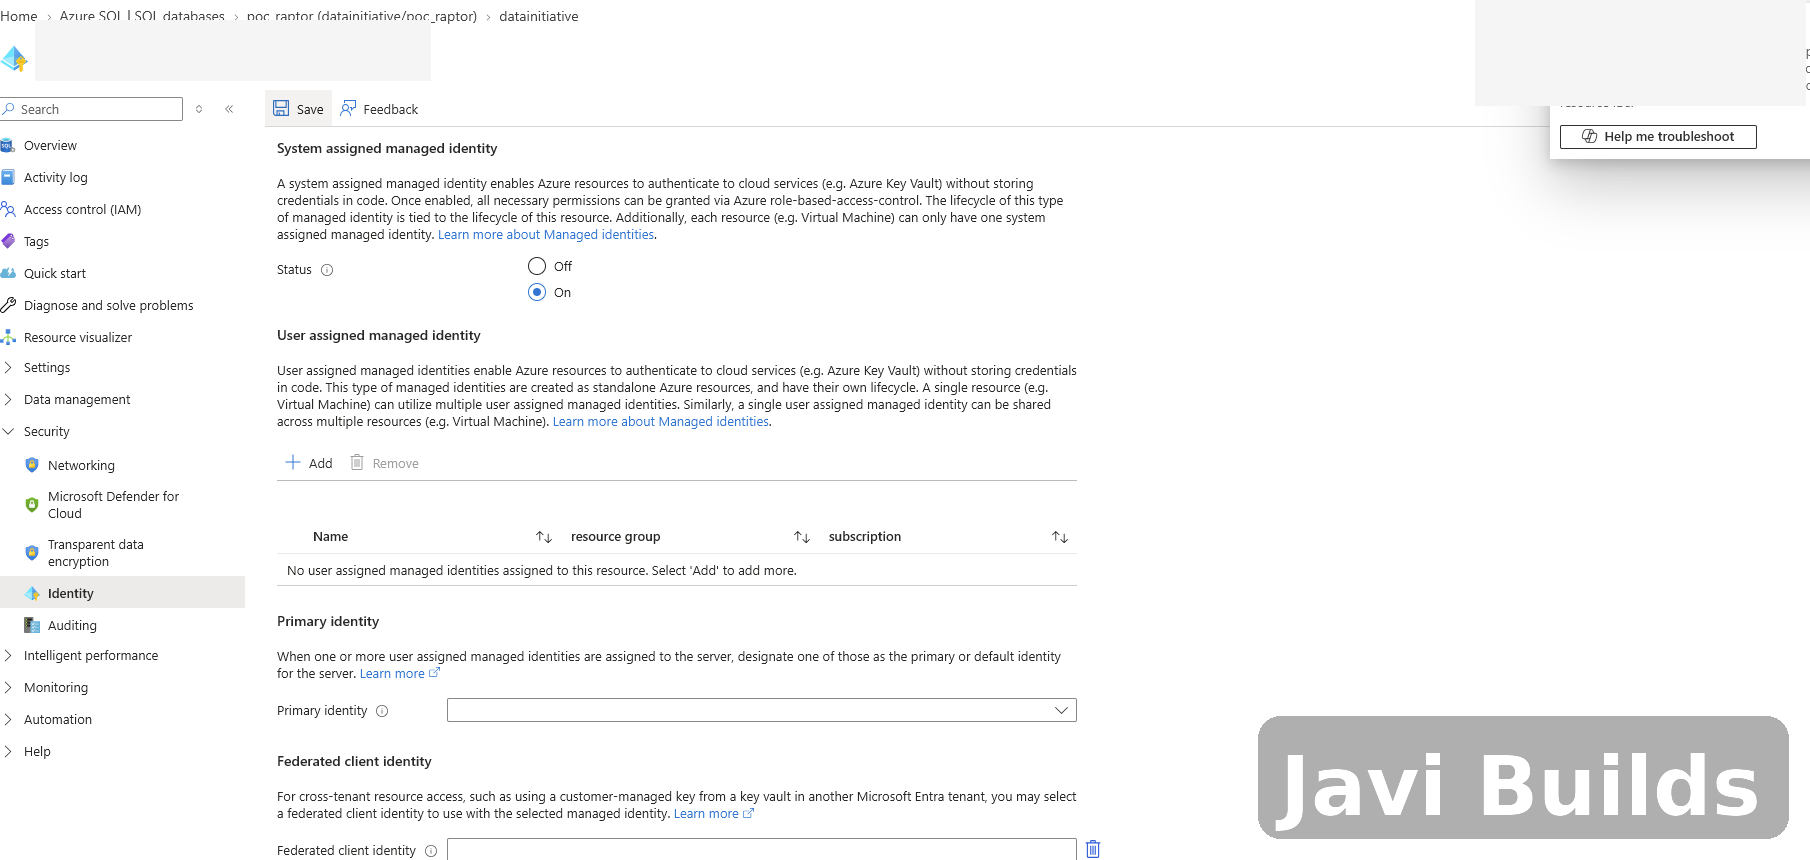
Habilitación de la identidad administrada asignada por el sistema requerida para configurar Mirroring.
6. Crear la base de datos replicada
Cuando se cumplan los requisitos de red e identidad, vuelve a Fabric y continúa con el asistente.
Fabric crea un nuevo elemento de base de datos replicada.
El flujo inicial es aproximadamente este:
- 1Validar el origen
- 2Crear la base de datos replicada
- 3Inicializar la replicación
- 4Instantánea inicial
- 5Replicación continua
Durante la inicialización puedes ver:
Status: Startingy:
No data has landedEs normal mientras se prepara la sincronización inicial.
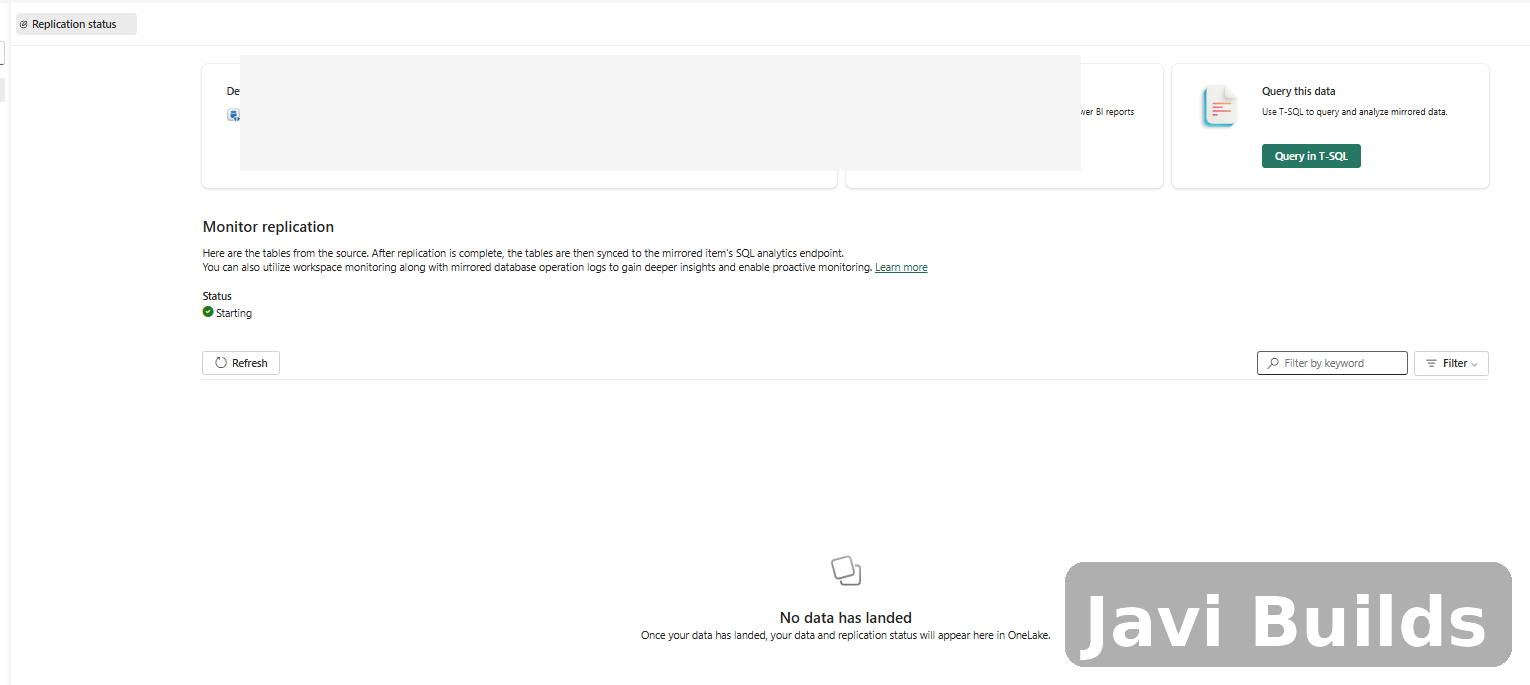
Fabric inicializa la replicación y espera a que los primeros datos lleguen a OneLake.
7. Entender los objetos que se crean en Fabric
Después de crear la base replicada, Fabric muestra varios elementos relacionados en el workspace.
Normalmente verás:
Mirrored database
SQL analytics endpoint
El SQL analytics endpoint proporciona una superficie SQL para consultar los datos replicados.
La base de datos replicada expone las tablas replicadas en OneLake.
Esto es importante porque el elemento replicado puede parecerse a un Lakehouse en algunas partes de la interfaz de Fabric, pero no es simplemente un Lakehouse normal creado por un usuario.
8. Añadir la base replicada a un notebook
Crea o abre un Fabric Notebook.
En el panel Data items:
Add data items
    ↓
OneLake catalog
    ↓
Select the mirrored database
Después de añadirla, deberías ver algo parecido a:
OneLake
  └─ mirrored_database
      └─ Schemas
          └─ dbo
              └─ Tables
                  └─ tenant
Puedes expandir la tabla e inspeccionar sus columnas directamente en el explorador del notebook.
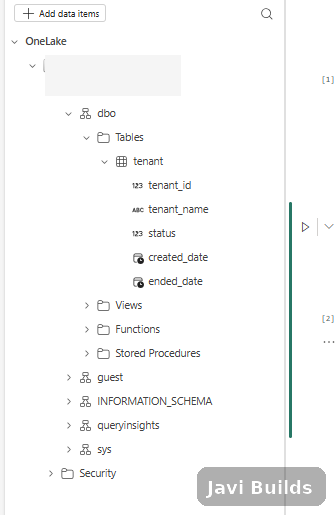
La tabla replicada dbo.tenant está disponible directamente en el explorador del notebook.
9. Consultar la tabla replicada con Spark SQL
Hay un detalle importante.
Si el notebook no tiene un Lakehouse predeterminado asociado, un nombre de tres partes como este:
SELECT *
FROM mirrored_database.dbo.tenant;puede fallar con un error parecido a este:
No default context found, please attach a lakehouse before running spark sql queries with partial namespaces.No es necesario que asocies otro Lakehouse.
Usa el nombre completo de cuatro partes:
workspace.database.schema.tablePor ejemplo:
SELECT *
FROM demo_workspace.demo_mirror.dbo.tenant;Así el notebook puede resolver la tabla replicada sin depender del contexto de un Lakehouse predeterminado.
10. Consultar la misma tabla con PySpark
También puedes consultar el mismo objeto mediante spark.sql():
df = spark.sql("""
    SELECT *
    FROM demo_workspace.demo_mirror.dbo.tenant
""")

display(df)Esto te proporciona un Spark DataFrame que puedes usar en el resto del flujo de ingeniería de Fabric.
Por ejemplo:
active_tenants = spark.sql("""
    SELECT
        tenant_id,
        tenant_name,
        created_date
    FROM demo_workspace.demo_mirror.dbo.tenant
    WHERE status = 1
""")

display(active_tenants)Desde ahí puedes unir los datos operativos replicados con otros datos de Lakehouse o Warehouse.
11. Validar la replicación continua
Ver la fila inicial confirma que llegó la instantánea.
La prueba más interesante es comprobar que los cambios posteriores se replican automáticamente.
Inserta otra fila en Azure SQL:
INSERT INTO dbo.tenant
(
    tenant_id,
    tenant_name,
    status,
    created_date,
    ended_date
)
VALUES
(
    2,
    N'second_test',
    2,
    SYSUTCDATETIME(),
    NULL
);Después vuelve a ejecutar la consulta del notebook Fabric:
SELECT *
FROM demo_workspace.demo_mirror.dbo.tenant
ORDER BY tenant_id;Cuando aparezca la segunda fila, habrás validado el flujo completo:
- INSERT de Azure SQL
- Fabric Mirroring
- OneLake
- Spark SQL / PySpark
No se ejecutó ningún pipeline de copia.
Ningún notebook realizó la ingesta.
El servicio de Mirroring replicó el cambio de origen.
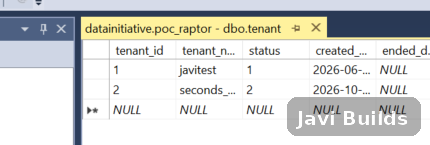
Se añade una segunda fila a la tabla de origen de Azure SQL para validar la replicación continua.
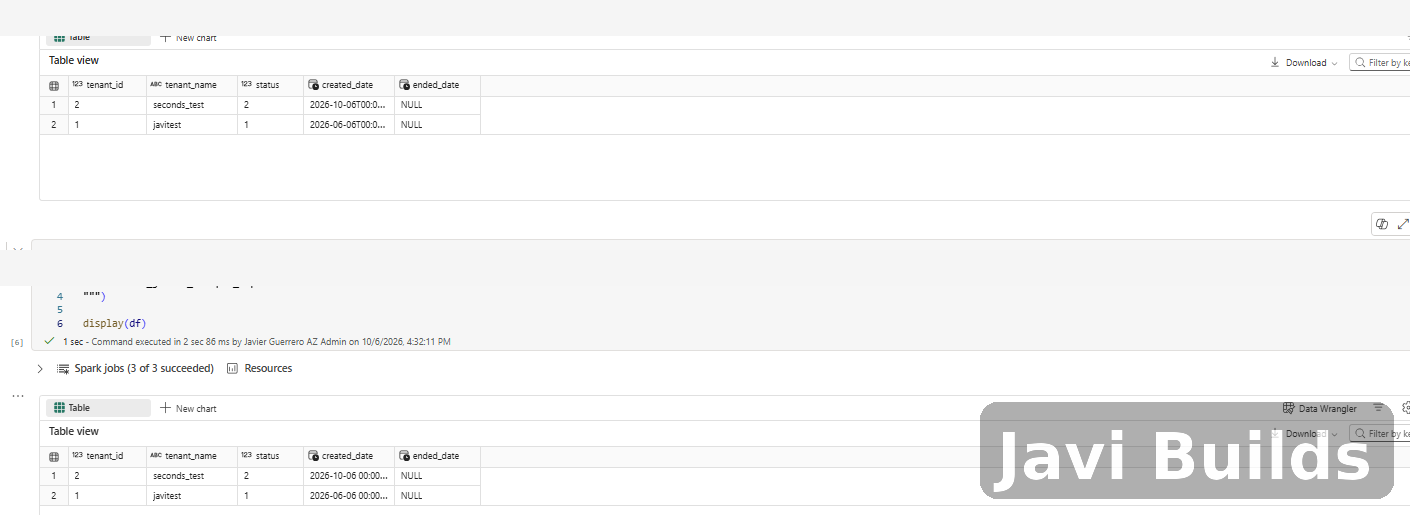
La nueva fila de Azure SQL aparece en Fabric sin ejecutar un pipeline de copia.
¿Qué ocurrió exactamente?
La arquitectura final es sencilla:
- Aplicación / API
- Lectura / escrituraAzure SQL DatabaseFuente de verdad operacional
- dbo.tenant
- Fabric MirroringFabric Mirrored DatabaseCopia sincronizada en OneLake
- NotebooksSpark
- SQL Analytics Endpoint
La aplicación debe seguir tratando Azure SQL como el sistema transaccional.
Fabric debe tratar los datos replicados como una representación analítica y orientada a lectura de esos datos operativos.
Esa separación es importante.
No diseñes la copia replicada como el lugar donde la aplicación escribe la configuración de tenants de vuelta en Azure SQL.
El flujo debe seguir siendo:
- Aplicación
- Azure SQL
- Mirroring
- Fabric
y no:
- Aplicación
- Réplica de Fabric
- Azure SQL
Cuándo resulta útil este patrón
Una tabla pequeña tenant quizá no parezca muy interesante, pero el patrón resulta útil cuando se combinan metadatos operativos con grandes conjuntos de datos analíticos.
Imagina que Azure SQL contiene:
tenant
merchant
application_configuration
report_configuration
feature_flags
mientras que Fabric contiene:
sales
registrations
commissions
clickstream
reporting aggregates
Mirroring permite que las cargas de Fabric hagan referencia a tablas operativas relativamente pequeñas sin crear un pipeline de ingesta separado para cada una.
Un notebook podría ejecutar algo como esto:
SELECT
    s.tenant_id,
    t.tenant_name,
    SUM(s.amount) AS total_sales
FROM analytics.sales s
JOIN demo_workspace.demo_mirror.dbo.tenant t
    ON s.tenant_id = t.tenant_id
GROUP BY
    s.tenant_id,
t.tenant_name;Aquí es donde el patrón resulta especialmente útil en una arquitectura multi-tenant.
Consideraciones de producción
Mirroring es potente, pero aun así conviene evaluar varios aspectos antes de usarlo ampliamente en producción.
Compatibilidad de las tablas
No todas las funcionalidades de SQL Server ni todos los tipos de datos son necesariamente aptos para replicarse. Valida el esquema de las tablas que quieres replicar.
Red
No consideres una regla temporal de firewall usada en una prueba de concepto como arquitectura definitiva.
En producción, evalúa el modelo de conectividad privada o basada en VNet adecuado para tu entorno.
Autenticación
Comprende el impacto de habilitar solo la autenticación de Microsoft Entra antes de aplicarla a un servidor SQL existente.
Identidad
Documenta la identidad administrada asignada por el sistema del servidor lógico de SQL y las políticas de la organización que la regulan.
Selección de tablas
Decide si realmente quieres que las tablas futuras se repliquen automáticamente.
En despliegues de producción controlados, la selección explícita de tablas suele ser más fácil de gobernar.
Responsabilidades de lectura y escritura
Deja claras las responsabilidades:
Azure SQL = lectura y escritura operativas
Base de datos replicada de Fabric = lectura analítica
Latencia de replicación
Considera Mirroring casi en tiempo real; no supongas que el comportamiento entre Azure SQL y Fabric es síncrono a nivel de transacción.
Checklist de despliegue
Esta es la lista que conservaría junto a la implementación:
Azure SQL
[ ] Base de datos de origen creada
[ ] Esquemas de tablas de origen compatibles
[ ] Administrador de Microsoft Entra configurado
[ ] Autenticación exclusiva de Microsoft Entra revisada/configurada si es necesaria
[ ] Identidad administrada asignada por el sistema habilitada
[ ] Identidad principal requerida configurada
[ ] Acceso de red desde Fabric validado

Microsoft Fabric
[ ] Base Azure SQL replicada creada
[ ] Conexión correcta con el origen seleccionada
[ ] Tablas necesarias seleccionadas
[ ] Decisión sobre "Automatically mirror future tables" documentada
[ ] Estado de replicación correcto
[ ] Datos iniciales disponibles en OneLake

Validación
[ ] Base replicada añadida a un Fabric Notebook
[ ] Nombre de objeto Spark de cuatro partes verificado
[ ] Consulta de la instantánea inicial completada
[ ] Nueva inserción en el origen replicada correctamente
[ ] Replicación de UPDATE probada
[ ] Replicación de DELETE probada
Conclusión
Lo que me gusta de este patrón es la poca lógica de ingesta personalizada que requiere.
En esta prueba de concepto, el flujo final fue básicamente:
- 1Crear una tabla de Azure SQL
- 2Configurar red e identidad SQL
- 3Crear una base de datos replicada en Fabric
- 4Seleccionar la tabla
- 5Esperar la sincronización inicial
- 6Añadir la base replicada al notebook
- 7Consultar con Spark
- 8Cambiar los datos de origen
- 9Verlos aparecer en Fabric
No hubo lógica de watermark incremental, actividad de copia que programar ni proceso CDC personalizado que mantener.
En arquitecturas donde Azure SQL administra el estado operativo y Microsoft Fabric se encarga del análisis, Fabric Mirroring ofrece un puente muy limpio entre ambos.
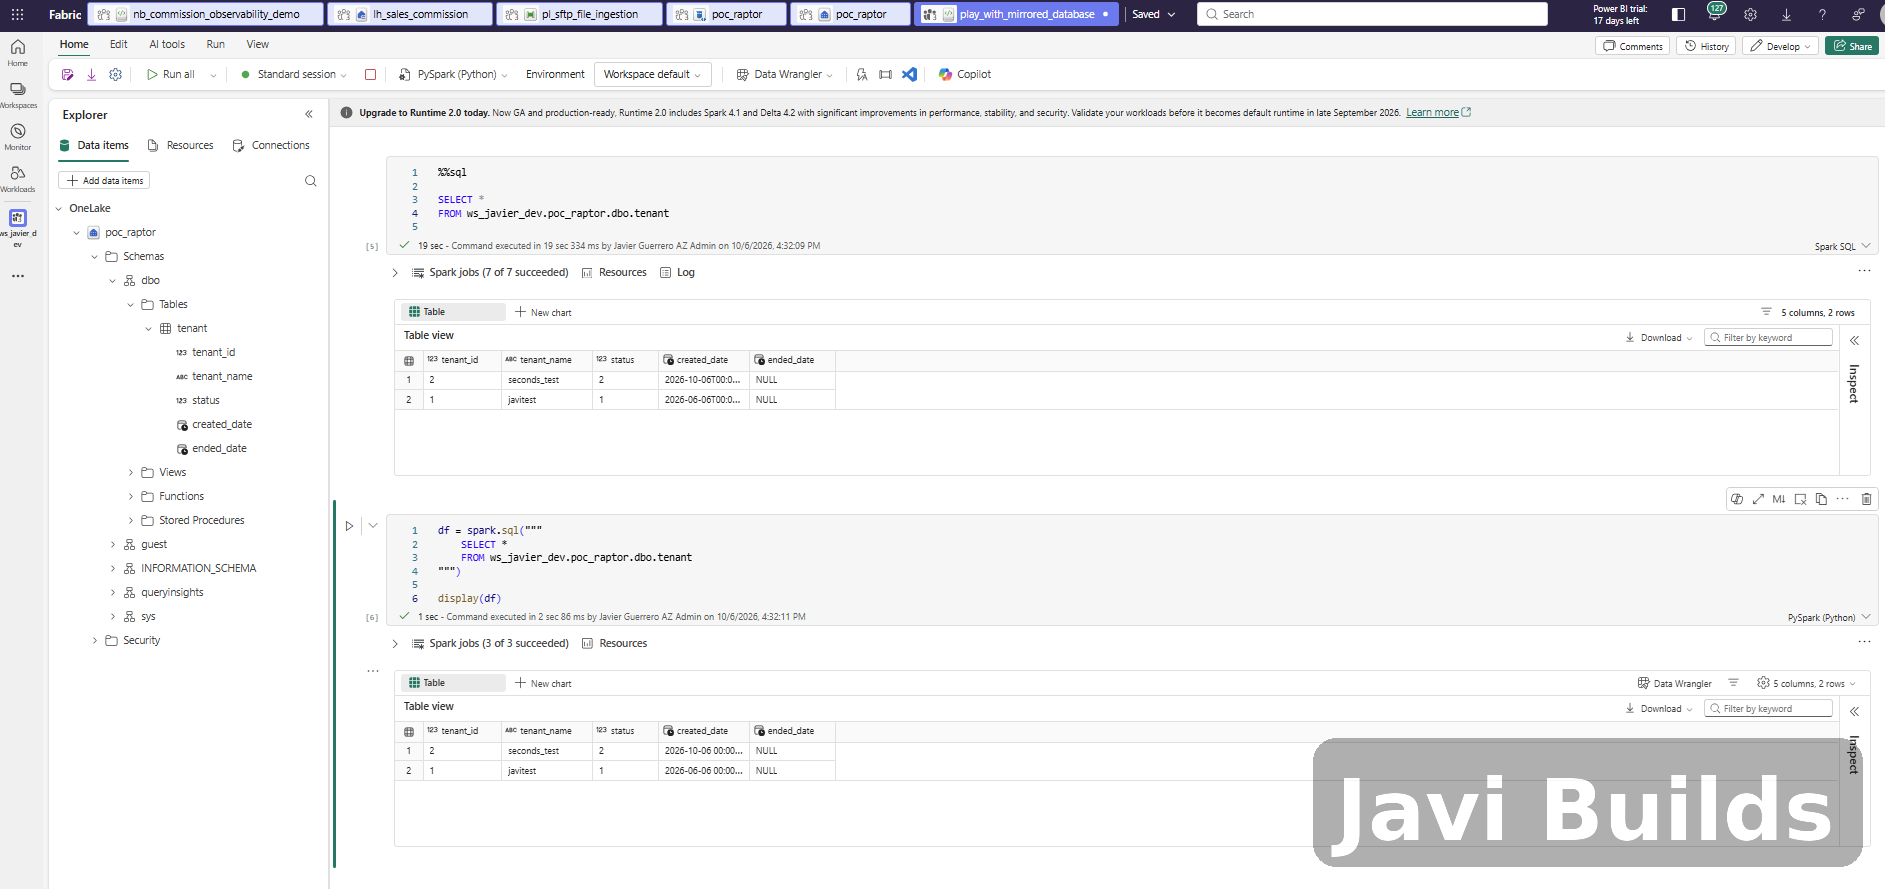
Vista completa del notebook que muestra la tabla replicada consultada correctamente con Spark SQL y PySpark.
¿Te resultó útil este contenido?
¿Qué podríamos mejorar?
Gracias — esto me ayuda a mejorar Javi Builds.
Sigue aprendiendo
- ArtículoContenido en inglésCreate Your First Fabric NotebookCreate a Microsoft Fabric notebook, attach it to a Lakehouse, build a small dataset with PySpark, write it as a Delta table and query it with Spark SQL, with every step explained.Leer artículo
- Guía rápidaContenido en inglésMicrosoft Fabric Workspace Settings Cheat SheetThe Microsoft Fabric workspace settings that change how a data engineering workspace behaves: Spark pools, environments and jobs, domain assignment, OneLake shortcut caching and diagnostics, and data workflow (Apache Airflow job) runtime pools, with what to verify for each.Abrir guía rápida
- RecursoContenido en inglésMicrosoft Fabric Certification Study PlannerAn adaptable 6–8 week example plan that connects official Fabric certification objectives with hands-on practice, review, and exam readiness.Ver recurso
¿Qué debería crear después?
Estoy construyendo Javi Builds alrededor de problemas reales que enfrentan los ingenieros de datos. Dime qué tema te gustaría ver después.
Mantente al día
Recibe solo las novedades de Javi Builds que realmente te interesan.
Revisa tu bandeja de entrada
Te he enviado un enlace de confirmación. Tu suscripción se activará cuando la confirmes.