Cloud et automatisation
Rapports précalculés ou requêtes en direct : comment choisir
Choisissez entre rapports précalculés, requêtes en direct ou modèle hybride selon la fraîcheur, la répétition, la variabilité, le coût et les contraintes de sécurité.
Dans cet article
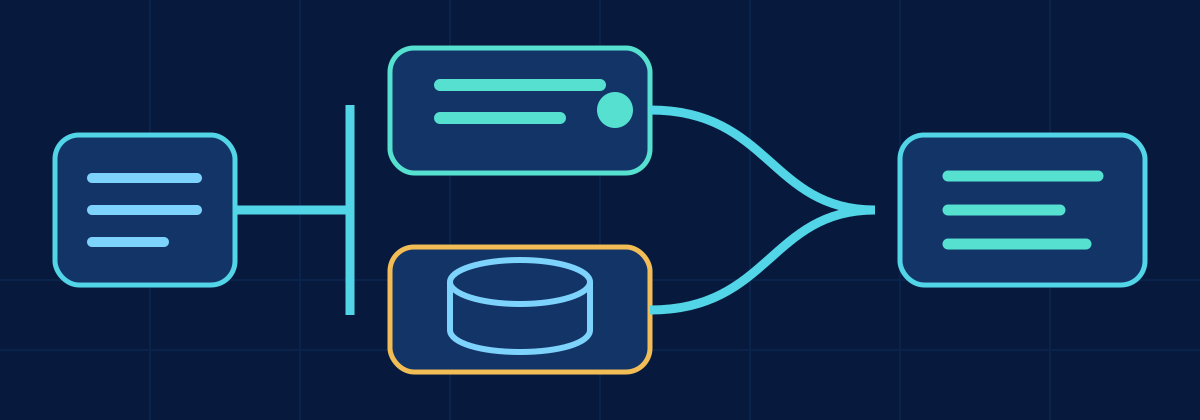
Réponse courte : précalculez un rapport quand le même résultat est demandé souvent et que les données changent selon un calendrier connu ; exécutez-le en direct quand les filtres varient trop pour réutiliser les résultats ou que les utilisateurs ont besoin de données plus récentes que le dernier chargement. La plupart des moteurs de rapports finissent hybrides : ils servent un résultat stocké tant qu’il correspond à la version actuelle des données, et interrogent en direct en cas d’absence. Décidez par classe de rapport, pas une fois pour tout le moteur.
Résultats précalculés
Les résultats précalculés conviennent aux rapports connus et souvent demandés, aux requêtes coûteuses sur l’historique et aux plages de dates prévisibles. Ils déplacent le travail hors du temps de réponse et offrent une latence stable, mais nécessitent du stockage, des métadonnées de fraîcheur, une stratégie d’invalidation, une séparation sécurisée des tenants et un nettoyage du cycle de vie. Un fichier précalculé doit toujours être autorisé au moment du téléchargement.
Requête en direct
L’exécution en direct convient aux données qui doivent être fraîches, aux filtres très variables, aux moteurs de requête à faible latence et à l’exploration interactive. Elle évite les artefacts obsolètes, mais expose la plateforme de données à la concurrence et à des coûts de requête imprévisibles. Appliquez des modèles validés, des délais d’exécution, l’annulation, des limites de lignes, des quotas et du load shedding.
Modèle hybride
- DemandeValidée, tenant identifié
- Clé de cache
tenantrapportparamètresformatversion - RechercheDans
report-cache, sous{tenant}/{report}/… - En cache et encore valide ?Avant l’expiration du TTL du rapport
Oui Résultat en cache
- Réautoriser cet appelant
- Lire la sortie stockée
- Renvoyer le résultat
Non Absence dans le cache
- Interroger Fabric (modèle approuvé)
- Générer la sortie : JSON, CSV ou Parquet
- Stocker sous le chemin du tenant, avec un TTL
- Renvoyer le résultat
Isolation par tenant : même rapport, mêmes paramètres, tenants distincts
- contoso
contoso · sales-by-region · 2026-09 · csv · v3report-cache/contoso/sales-by-region/… - fabrikam
fabrikam · sales-by-region · 2026-09 · csv · v3report-cache/fabrikam/sales-by-region/…
Deux clés, deux dossiers : aucun partage.
Un moteur hybride consulte d’abord un cache tenant-aware, puis exécute une requête récente en cas de cache miss sûr. Les clés de cache comprennent le tenant, le type de rapport, la plage de dates, les dimensions, les filtres, le format et la version du rapport. Le TTL suit les exigences de fraîcheur. L’invalidation peut être déclenchée par un événement après une actualisation des données ou par le temps lorsque le couplage exact est impraticable.
Décision
Il n’y a pas de solution universelle. Choisissez pour chaque classe de rapport en fonction de l’objectif de fraîcheur, de la fréquence des demandes, de la variabilité des paramètres, du coût d’exécution, de la taille des résultats, de la concurrence et de la tolérance aux pannes. Mesurez le taux de cache hit et la durée des requêtes, mais aussi la justesse, les incidents liés à des résultats obsolètes, la sécurité des sorties et la croissance du stockage.
Décider par classe de rapport
| Classe de rapport | Exemple | Choix habituel | Raison |
|---|---|---|---|
| Période fixe, paramètres fixes, nombreux lecteurs | Relevé mensuel par locataire | Précalcul après le chargement mensuel | Même sortie lue de nombreuses fois ; les données ne changeront plus |
| Paramètres courants, données quotidiennes | « 30 derniers jours par canal » | Hybride, clé incluant la version des données | Forte réutilisation jusqu’au chargement suivant, puis invalidation naturelle |
| Combinaisons libres de filtres et de dimensions | Ventilations ad hoc depuis une API | En direct, avec des limites strictes | La réutilisation est rare : les résultats stockés gaspillent surtout du stockage |
| Vue opérationnelle quasi temps réel | Commandes des 15 dernières minutes | En direct, ou une petite table précalculée rafraîchie par le pipeline | La fraîcheur compte plus que la latence d’une répétition |
| Très gros exports | Détail d’une année pour un locataire | Tâche asynchrone qui écrit un fichier | Ni le cache ni une requête synchrone ne conviennent |
Si vous ne savez pas classer un rapport, mesurez avant de choisir : journalisez la clé normalisée des demandes pendant quelques semaines et comptez combien de fois chaque clé se répète entre deux chargements. Une clé qui ne se répète jamais avant que les données changent est un mauvais candidat au cache, quel que soit son coût.
Indexer le cache sur la version des données, pas seulement sur le temps
Un TTL fondé sur le temps devine quand les données changent. Quand votre pipeline enregistre un identifiant de chargement, placez-le dans la clé et l’invalidation se fait d’elle-même :
{tenant}/{report}/{report_version}/{data_version}/{sha256(normalized parameters)}.{format}

contoso/revenue-by-channel/v3/load-2026-11-06-0200/9f2c….csv- locataire en premier : une clé ou un chemin construit sans le locataire peut être servi au mauvais locataire ;
- report_version : modifier la requête ou la forme de sortie ne doit pas servir d’anciens fichiers ;
- data_version : l’identifiant du dernier chargement réussi des tables sources, lu dans votre journal d’exécution ; un nouveau chargement produit de nouvelles clés et les anciennes entrées ne sont simplement plus lues ;
- paramètres normalisés : triés, complétés par leurs valeurs par défaut et typés, pour que des demandes équivalentes partagent une clé.
Gardez un TTL comme filet de sécurité et pour le nettoyage du stockage, pas comme mécanisme de fraîcheur.
Modes de défaillance propres au cache
- Ruée après un chargement. Toutes les clés deviennent absentes au même moment et l’entrepôt reçoit d’un coup tout le trafic de la matinée. Regroupez les demandes identiques en cours pour qu’une seule requête remplisse l’entrée pendant que les autres attendent, ou précalculez les clés les plus demandées en dernière étape du chargement.
- Données arrivées en retard. Une correction arrive après le chargement désigné par la version des données. Incrémentez la version pour les corrections, ou excluez du cache les rapports qui ne tolèrent aucune fenêtre de correction.
- Écritures partielles. Le résultat est renvoyé à l’appelant mais l’écriture en cache échoue, ou ne se termine qu’à moitié. Écrivez sous un nom temporaire puis renommez, et traitez une entrée illisible comme une absence plutôt que comme une erreur.
- Stockage qui ne fait que grossir. Des fichiers précalculés que personne n’ouvre. Comptez les lectures par entrée et cessez de précalculer les clés qui ne sont pas lues.
Ce qu’il faut mesurer
Le taux de résultats trouvés par classe de rapport (pas global), l’âge des données au moment où un résultat est servi, la P95 des requêtes en direct et la part des absences qui la dépassent, les octets stockés par locataire et les lectures par entrée stockée. Un taux de cache en hausse accompagné d’un âge des données servies en hausse est un signal d’alerte, pas un succès.
Voir aussi
- Qu’est-ce qu’un moteur de rapports ?
- Architecture d’un moteur de rapports : de la demande au résultat
- Construire un moteur de rapports multi-locataire sur Azure et Microsoft Fabric, section 9 (cache et artefacts de rapport)
- Concevoir un journal d’exécution pour les pipelines de données : d’où vient la version des données
Sources
- Azure Architecture Center : modèle Cache-Aside, modèle Vue matérialisée
- Microsoft Learn : vue d’ensemble des signatures d’accès partagé (SAS), pour un accès de courte durée aux résultats stockés
Vérifié en novembre 2026. Les seuils indiqués sont des repères de conception, pas des mesures issues d’un système particulier.
Ce contenu vous a-t-il été utile ?
Que pourrions-nous améliorer ?
Merci — cela m’aide à améliorer Javi Builds.
Continuer à apprendre
- Aide-mémoireContenu en anglaisMicrosoft Fabric Workspace Settings Cheat SheetThe Microsoft Fabric workspace settings that change how a data engineering workspace behaves: Spark pools, environments and jobs, domain assignment, OneLake shortcut caching and diagnostics, and data workflow (Apache Airflow job) runtime pools, with what to verify for each.Ouvrir l’aide-mémoire
- ArticleConcevoir un moteur de rapports pour les consommateurs d’interface et d’APIConcevez un backend de rapports unique et gouverné pour les pages d’interface interactives, les API externes, les téléchargements et les gros exports asynchrones.Lire l’article
Que devrais-je créer ensuite ?
Je développe Javi Builds autour des problèmes concrets rencontrés par les data engineers. Dites-moi quel sujet vous aimeriez voir ensuite.
Restez au courant
Recevez uniquement les nouvelles de Javi Builds qui vous intéressent.
Consultez votre boîte de réception
Je vous ai envoyé un lien de confirmation. Votre abonnement sera actif après confirmation.