Cloud y automatización
Informes precalculados o consultas en tiempo real: cómo elegir
Elige entre informes precalculados, consultas en tiempo real o ejecución híbrida según frescura, frecuencia, variabilidad, costo y seguridad.
En este artículo
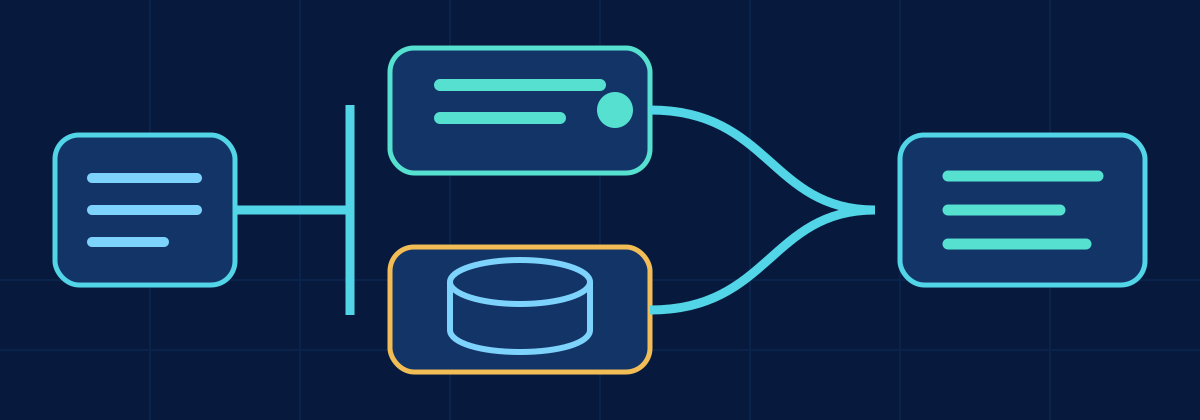
Respuesta corta: precalcula un informe cuando el mismo resultado se pide a menudo y los datos cambian con un calendario conocido; ejecútalo en tiempo real cuando los filtros varían demasiado para reutilizar resultados o los usuarios necesitan datos más recientes que la última carga. La mayoría de los motores de informes acaban siendo híbridos: sirven un resultado almacenado mientras coincide con la versión actual de los datos y consultan en tiempo real cuando no hay acierto. Decide por clase de informe, no una vez para todo el motor.
Informes precalculados
Los resultados precalculados encajan con informes conocidos que se repiten, consultas históricas costosas e intervalos de fechas previsibles. Sacan el trabajo del tiempo de respuesta y ofrecen una latencia estable, pero requieren almacenamiento, metadatos de frescura, invalidación, separación segura de tenants y limpieza de su ciclo de vida. El archivo precalculado sigue necesitando autorización al descargarse.
Consulta en tiempo real
La ejecución directa encaja con datos frescos, filtros muy variables, motores de consulta de baja latencia y exploración interactiva. Evita artefactos desactualizados, pero expone la plataforma de datos a la concurrencia y a costos de solicitudes imprevisibles. Aplica plantillas validadas, tiempos de espera, cancelación, límites de filas, cuotas y load shedding.
Modelo híbrido
- SolicitudValidada, tenant identificado
- Clave de caché
tenantinformeparámetrosformatoversión - BuscarEn
report-cache, bajo{tenant}/{report}/… - ¿Está en caché y sigue vigente?Dentro del TTL del informe
Sí Acierto de caché
- Volver a autorizar a este solicitante
- Leer la salida almacenada
- Devolver el resultado
No Sin resultado en caché
- Consultar Fabric (plantilla aprobada)
- Generar la salida: JSON, CSV o Parquet
- Guardar en la ruta del tenant con un TTL
- Devolver el resultado
Aislamiento por tenant: mismo informe, mismos parámetros, distintos tenants
- contoso
contoso · sales-by-region · 2026-09 · csv · v3report-cache/contoso/sales-by-region/… - fabrikam
fabrikam · sales-by-region · 2026-09 · csv · v3report-cache/fabrikam/sales-by-region/…
Dos claves, dos carpetas: no se comparten.
Un motor híbrido consulta primero una caché tenant-aware y ejecuta una consulta actualizada cuando no hay una entrada segura. Las claves de caché incluyen tenant, tipo de informe, intervalo de fechas, dimensiones, filtros, formato y versión del informe. El TTL se ajusta a los requisitos de frescura. La invalidación puede activarse con un evento después de actualizar los datos o basarse en el tiempo cuando no sea práctico mantener una vinculación exacta.
Decisión
No hay un ganador universal. Elige para cada clase de informe según el objetivo de frescura, la frecuencia de uso, la variabilidad de parámetros, el costo de ejecución, el tamaño del resultado, la concurrencia y la tolerancia a fallos. Mide la tasa de aciertos de caché y la duración de las consultas, pero también la corrección, los incidentes por resultados desactualizados, la seguridad de las salidas y el crecimiento del almacenamiento.
Decidir por clase de informe
| Clase de informe | Ejemplo | Elección habitual | Motivo |
|---|---|---|---|
| Periodo fijo, parámetros fijos, muchos lectores | Extracto mensual por tenant | Precalcular tras la carga mensual | La misma salida se lee muchas veces; los datos ya no cambiarán |
| Parámetros comunes, datos diarios | «Últimos 30 días por canal» | Híbrido, con la versión de los datos en la clave | Mucha reutilización hasta la siguiente carga y luego invalidación natural |
| Combinaciones libres de filtros y dimensiones | Desgloses ad hoc desde una API | En tiempo real, con límites estrictos | La reutilización es rara; los resultados guardados sobre todo gastan almacenamiento |
| Vista operativa casi en tiempo real | Pedidos de los últimos 15 minutos | En tiempo real, o una tabla pequeña precalculada que refresca el pipeline | La frescura importa más que la latencia de una repetición |
| Exportaciones muy grandes | Detalle de un año para un tenant | Trabajo asíncrono que escribe un archivo | No encaja ni un acierto de caché ni una consulta síncrona |
Si no sabes clasificar un informe, mide antes de elegir: registra la clave normalizada de las solicitudes durante unas semanas y cuenta cuántas veces se repite cada clave entre dos cargas. Una clave que nunca se repite antes de que cambien los datos es mala candidata para la caché, por cara que sea.
Indexar la caché por la versión de los datos, no solo por tiempo
Un TTL basado en tiempo adivina cuándo cambian los datos. Cuando tu pipeline registra un identificador de carga, ponlo en la clave y la invalidación ocurre sola:
{tenant}/{report}/{report_version}/{data_version}/{sha256(normalized parameters)}.{format}

contoso/revenue-by-channel/v3/load-2026-11-06-0200/9f2c….csv- tenant primero: una clave o ruta que se puede construir sin el tenant puede servirse al tenant equivocado;
- report_version: cambiar la consulta o la forma de la salida no debe servir archivos antiguos;
- data_version: el identificador de la última carga correcta de las tablas de origen, leído de tu registro de ejecución; una carga nueva produce claves nuevas y las entradas antiguas simplemente dejan de leerse;
- parámetros normalizados: ordenados, con sus valores por defecto y tipados, para que solicitudes equivalentes compartan una clave.
Mantén un TTL como red de seguridad y para limpiar el almacenamiento, no como mecanismo de frescura.
Modos de fallo propios de la caché
- Avalancha tras una carga. Todas las claves fallan a la vez y el almacén recibe de golpe todo el tráfico de la mañana. Agrupa los fallos idénticos en curso para que una sola consulta llene la entrada mientras los demás esperan, o precalcula las claves más pedidas como último paso de la carga.
- Datos que llegan tarde. Una corrección llega después de la carga a la que apunta la versión de los datos. Incrementa la versión con las correcciones o excluye de la caché los informes que no toleran ninguna ventana de corrección.
- Escrituras parciales. El resultado se devuelve al llamante pero la escritura en caché falla o queda a medias. Escribe con un nombre temporal y renombra, y trata una entrada ilegible como un fallo de caché, no como un error.
- Almacenamiento que solo crece. Archivos precalculados que nadie abre. Cuenta las lecturas por entrada y deja de precalcular las claves que no se leen.
Qué medir
La tasa de aciertos por clase de informe (no global), la antigüedad de los datos en el momento de servir un resultado, la P95 de las consultas en tiempo real y la proporción de fallos de caché que la superan, los bytes almacenados por tenant y las lecturas por entrada guardada. Una tasa de aciertos que sube junto con la antigüedad de los datos servidos es una alerta, no un éxito.
Relacionado
- ¿Qué es un motor de informes?
- Arquitectura de un motor de informes: de la solicitud al resultado
- Construir un motor de informes multi-tenant en Azure y Microsoft Fabric, sección 9 (caché y artefactos de informe)
- Diseñar un registro de ejecución para pipelines de datos: de dónde sale la versión de los datos
Fuentes
- Azure Architecture Center: patrón Cache-Aside, patrón Vista materializada
- Microsoft Learn: información general sobre firmas de acceso compartido (SAS), para un acceso de corta duración a los resultados almacenados
Revisado en noviembre de 2026. Los umbrales son orientaciones de diseño, no mediciones de un sistema concreto.
¿Te resultó útil este contenido?
¿Qué podríamos mejorar?
Gracias — esto me ayuda a mejorar Javi Builds.
Sigue aprendiendo
- Guía rápidaProcesamiento batch vs streamingElige entre procesamiento de datos batch y streaming comparando latencia, corrección, complejidad operativa, costo, reproducción, estado y recuperación ante fallos en cargas de trabajo de producción reales.Abrir guía rápida
- ArtículoDiseñar un motor de informes para consumidores de interfaz y de APIDiseña un único backend de informes gobernado para páginas de interfaz interactivas, API externas, descargas y grandes exportaciones asíncronas.Leer artículo
¿Qué debería crear después?
Estoy construyendo Javi Builds alrededor de problemas reales que enfrentan los ingenieros de datos. Dime qué tema te gustaría ver después.
Mantente al día
Recibe solo las novedades de Javi Builds que realmente te interesan.
Revisa tu bandeja de entrada
Te he enviado un enlace de confirmación. Tu suscripción se activará cuando la confirmes.